音声対話のための音声合成・音声認識エンジン、speech.cppを作ってみた話
by 逆瀬川ちゃん
46 min read
こんにちは!逆瀬川ちゃん (@gyakuse) です!
今日は音声対話のために作った音声合成と音声認識のエンジン、speech.cppについてまとめていきたいと思います。
作ったもの
speech.cppは、音声合成と音声認識のモデルをggmlの上で動かすC++のエンジンです。MacではMetal、WindowsとLinuxではVulkanでGPUを使い、GPUがなければCPUで動きます。
いま動かせるのは次のモデルです。どれも、元のモデルの重みをspeech.cpp用のGGUFのファイルに変換して、Hugging Faceに置いています。
音声合成モデル
| モデル | 言語 | speech.cpp用のGGUF |
|---|---|---|
| Qwen3-TTS | 10言語 | 0.6B / 1.7B |
| Irodori-TTS | 日本語 | v4.1-Small-MF / v4.1-Small |
Qwen3-TTSは用意された9人の声から選べます。Irodori-TTSは録音や言葉で声を指定でき、速さを重視するならMFが向いています。
音声認識モデル
| モデル | 言語 | speech.cpp用のGGUF |
|---|---|---|
| Qwen3-ASR | 30言語 | 0.6B / 1.7B |
| parakeet-tdt_ctc-0.6b-ja | 日本語 | ダウンロード |
| parakeet-tdt-0.6b-v3 | ヨーロッパの25言語 | ダウンロード |
| ReazonSpeech NeMo v2 | 日本語 | ダウンロード |
Qwen3-ASRは、固有名詞などをプロンプトで教えられます。日本語ではparakeet-jaが速く、ReazonSpeechはビームサーチで書き起こします。精度と速さは後半で比較します。
音声区間検出モデル
| モデル | 言語 | speech.cpp用のGGUF |
|---|---|---|
| Silero VAD v6.2 | 言語によらない | ダウンロード |
音声のどこで人が話しているかを見つけます。長尺の録音を区間ごとに書き起こしたり、話し終わりを見つけたりするのに使います。
使ってみる
インストールする
インストールは1行です。Apple siliconのMacと、x86-64のLinuxではこちら、
curl -fsSL https://raw.githubusercontent.com/nyosegawa/speech.cpp/main/install.sh | sh
Windows x64ではPowerShellで実行します(Vulkan対応のGPUドライバーが必要です)。
irm https://raw.githubusercontent.com/nyosegawa/speech.cpp/main/install.ps1 | iex
Linuxの配布版には、AVX2・FMA・F16Cに対応するCPUとglibc 2.34以降が必要です。Vulkanローダーが入っていなければ、インストーラーがCPU版を選びます。Intel Macではソースからビルドしてください。詳しい条件はインストールの説明にあります。
モデルは名前で指定します。初めて使うときに、Hugging Faceから取ってきてOSのキャッシュのフォルダに置きます。
ブラウザで試す
いちばん手軽なのは、試すためのページを開くことです。
speech serve --open
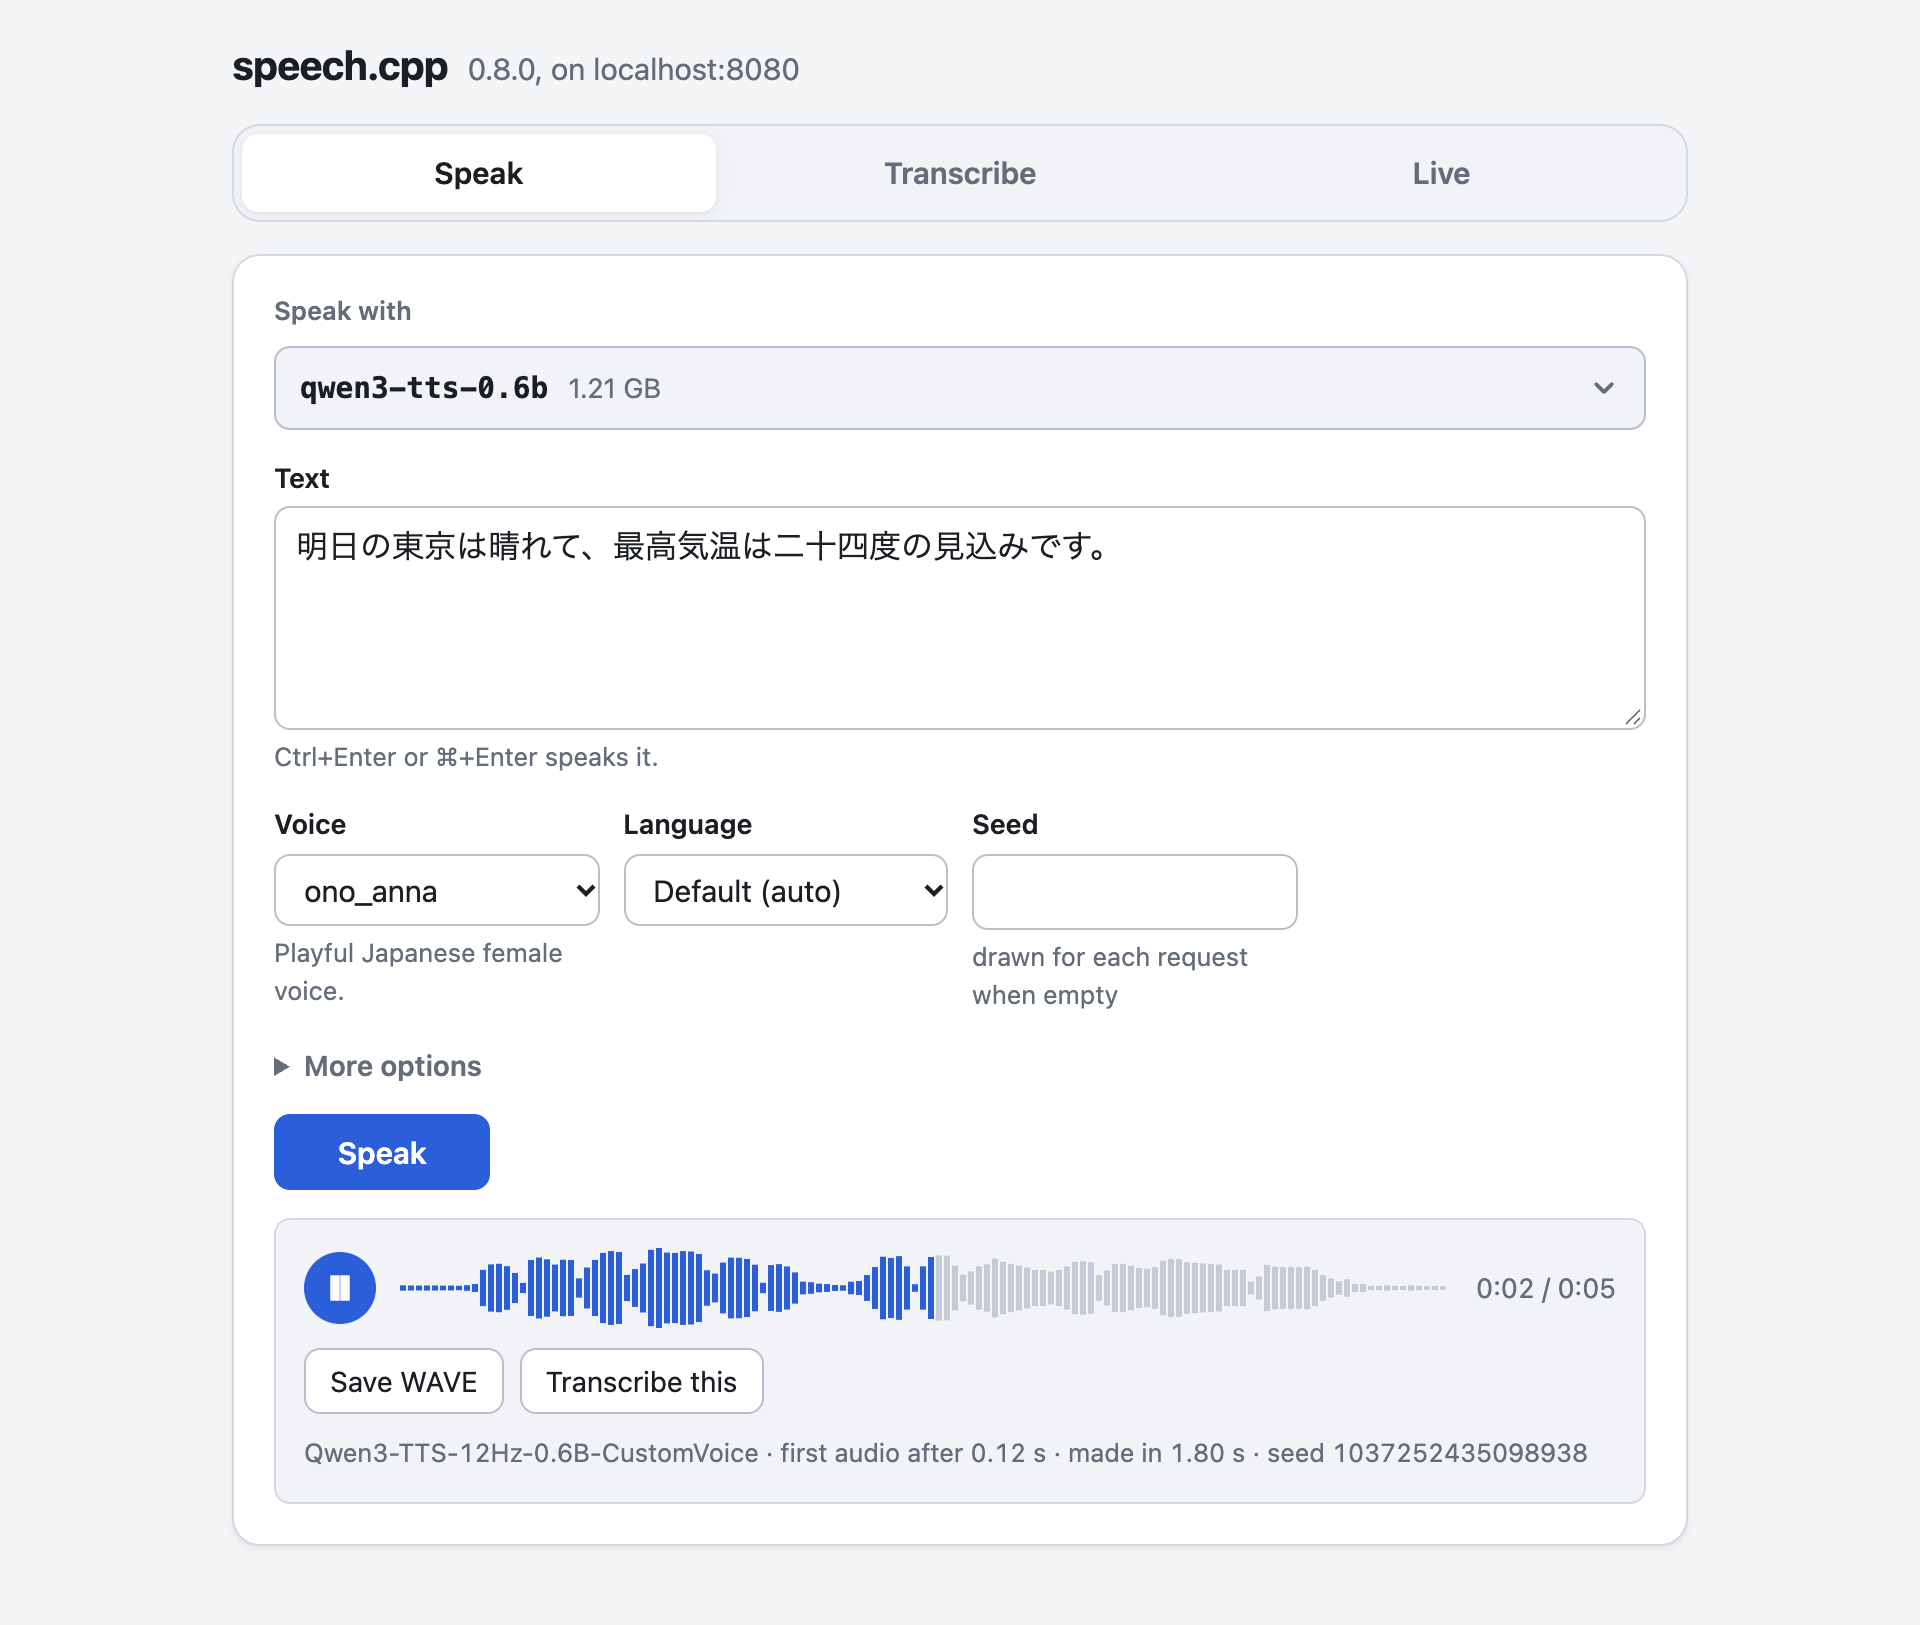
Speak、Transcribe、Liveのタブで、モデルを選んで文を読ませたり、録音や音声ファイルを書き起こしたり、マイクに話しているそばから書き起こしたりできます。
文を読み上げる
コマンドからも使えます。Qwen3-TTSで読む場合です。
speech tts qwen3-tts-0.6b --voice ono_anna --language ja -o out.wav "明日の東京は晴れです。"
好きな声で読み上げる
Irodori-TTSは、参照音声のWAVファイルを直接渡して、その声で読み上げられます。この例では、合成した音声をout.wavに保存します。
speech tts irodori-tts-mf \
--add-voice me=my-voice.wav --voice me \
-o out.wav "こんにちは。"
同じ声を繰り返し使うなら、speech voiceで声のファイルを一度作っておくこともできます。WAVを渡すたびに参照音声をエンコードする時間を省けます。
speech voice irodori-tts-mf my-voice.wav my-voice.voice.gguf
speech tts irodori-tts-mf \
--add-voice me=my-voice.voice.gguf --voice me \
-o out.wav "こんにちは。"
参照音声がなくても、声の特徴を言葉で書けば、それに合った声で読んでくれます。
speech tts irodori-tts-mf --voice none \
--instructions "低く落ち着いた男性の声で、ゆっくりと読み上げてください。" \
-o out.wav "明日の東京は晴れです。"
書き起こす
Qwen3-ASRは、固有名詞をプロンプトで教えられます。
speech asr parakeet-tdt_ctc-0.6b-ja utterance.wav
speech asr qwen3-asr-1.7b --language ja --prompt "逆瀬川, Codex, Claude" utterance.wav
長尺の録音やマイクから書き起こす
長尺の録音は、Silero VADで話している区間を見つけて、区間ごとに書き起こします。--liveにすると、マイクに向かって話しているそばから書き起こします。
speech asr reazonspeech-v2 --vad silero-vad meeting.wav
speech asr reazonspeech-v2 --vad silero-vad --live
HTTPサーバーとして使う
HTTPサーバーを立てると、OpenAIのAPIと同じ形で呼べます。
speech serve irodori-tts-mf --add-voice me=my-voice.voice.gguf
curl http://127.0.0.1:8080/v1/audio/speech -H 'Content-Type: application/json' \
-d '{"input": "明日の東京は晴れです。", "voice": "me"}' -o out.wav
Pythonからは、届いたところからPCMを受け取れます。
import requests
import wave
with requests.post("http://127.0.0.1:8080/v1/audio/speech",
json={"input": "明日の東京は晴れです。", "voice": "me", "response_format": "pcm"},
stream=True) as r:
r.raise_for_status()
with wave.open("out.wav", "wb") as w:
w.setnchannels(1)
w.setsampwidth(2)
w.setframerate(int(r.headers["X-Sample-Rate"]))
for chunk in r.iter_content(chunk_size=None):
w.writeframes(chunk)
アプリに組み込む
ふつうはHTTPサーバーかワーカーで足ります。アプリに直接組み込みたいときは、C APIを使います (C APIより)。
speech_model * model = NULL;
speech_request * request = NULL;
if (check(speech_model_load("Irodori-TTS-866M-MF-v4.1-F16.gguf", NULL, &model)) &&
check(speech_voice_add(model, "bright", "bright-young-woman-10s.voice.gguf")) &&
check(speech_request_new(model, &request)) &&
check(speech_request_set_text(request, "明日の東京は晴れです。")) &&
check(speech_request_set_string(request, SPEECH_OPT_VOICE, "bright")) &&
check(speech_synthesize(request, on_audio, NULL))) {
/* on_audio が、できた音声を少しずつ受け取る */
}
speech_request_free(request);
speech_model_free(model);
なぜ作ったか
わたしはASISTというデスクトップ向けの音声対話アシスタントを作っています。音声対話でいちばんしんどいのは待ち時間です。人どうしの会話では、相手が話し終えてから次の人が話し始めるまでは200ミリ秒くらいだそうです (Stivers et al., 2009)。アシスタントが1秒黙っていると聞こえているか心配になります。
日本語の声はAratakoさんのIrodori-TTSがとても良くて、読みが自然ですし、参照音声を渡せばその声で話してくれます。ただ、そのまま動かすと若干遅く、リアルタイムの会話には少し向きません。
Windowsではめちゃくちゃつらく、検証に使っているマシンはRTX 2080 (8 GB) なのですが、PythonとCUDAで音声のモデルを動かそうとすると、ことごとくうまくいきませんでした。
- Qwen3-TTSは、PyTorchの公式のパッケージでWindowsで動かせませんでした
- 音声認識に使っていたllama.cppは、CUDA 13向けのビルドがRTX 20向けの機械語を含んでおらず起動しませんでした。CUDA 12向けのビルドは動きましたが、最初の起動でGPUのコードのコンパイルに28秒かかりました
CUDAとPythonで行くなら、NVIDIAのGPUでドライバー580以上、RTX 20以降が前提になり、数GBのPythonの環境も配ることになります。
しかも、モデルごとに動かし方がばらばらでした。ASISTでは、音声認識をllama.cppのllama-serverで、読み上げを自分で作ったワーカーで動かしていました。llama-serverのほうは、モデルとmmprojの2つのファイル、ループバックのポートとその鍵、アプリが落ちたときに止める見張りが要り、文脈が4096トークンなので約270秒より長い発話は失敗していました。
なので、音声合成も音声認識もひとつのエンジンで動かせて、MacでもWindowsでもLinuxでも同じものがGPUで動いて、会話に間に合う速さで、公式の実装と同じ結果を出すものが欲しい気持ちがありました。まずは、声が出るまでを短くする話からです。
音声合成: 声が出るまでを短くして途切れないようにする
最初の声が出るまでを見る
ASISTは会話のモデルの返事を文ごとに分けて、届いたものから読み上げています。Irodori-TTSには1文ずつ渡し、Qwen3-TTSには待っている文を合計300文字以内でまとめて渡します。続きは先の音声を再生しているあいだに作れるので、利用者が最初に待つのは最初の文の声が出るまでです。なので全体の速さ (RTF、1秒の音声を作るのに何秒かかるか) よりも、最初の声が出るまでの時間を見ていきます。
計測するときは、相槌、短い返事、長めの説明、英単語まじりのテキストなど20文を、どの実装にも同じ声で読ませて中央値を取りました。Irodori-TTSのseedは固定し、Qwen3-TTSのseedは毎回変えています (くわしくはAppendixに書いています)。
Irodori-TTSのしくみ
Irodori-TTSは、LLMのように1トークンずつ出していくモデルではありません。Echo-TTSにならったDiffusion Transformer (DiT) が、音声コーデックの潜在表現 (latent、48 kHz、25 Hz、32次元) をテキスト全体ぶん一気に作り、コーデックがそれを波形に戻します。音声の長さは、生成の前に別のモデルが予測します。
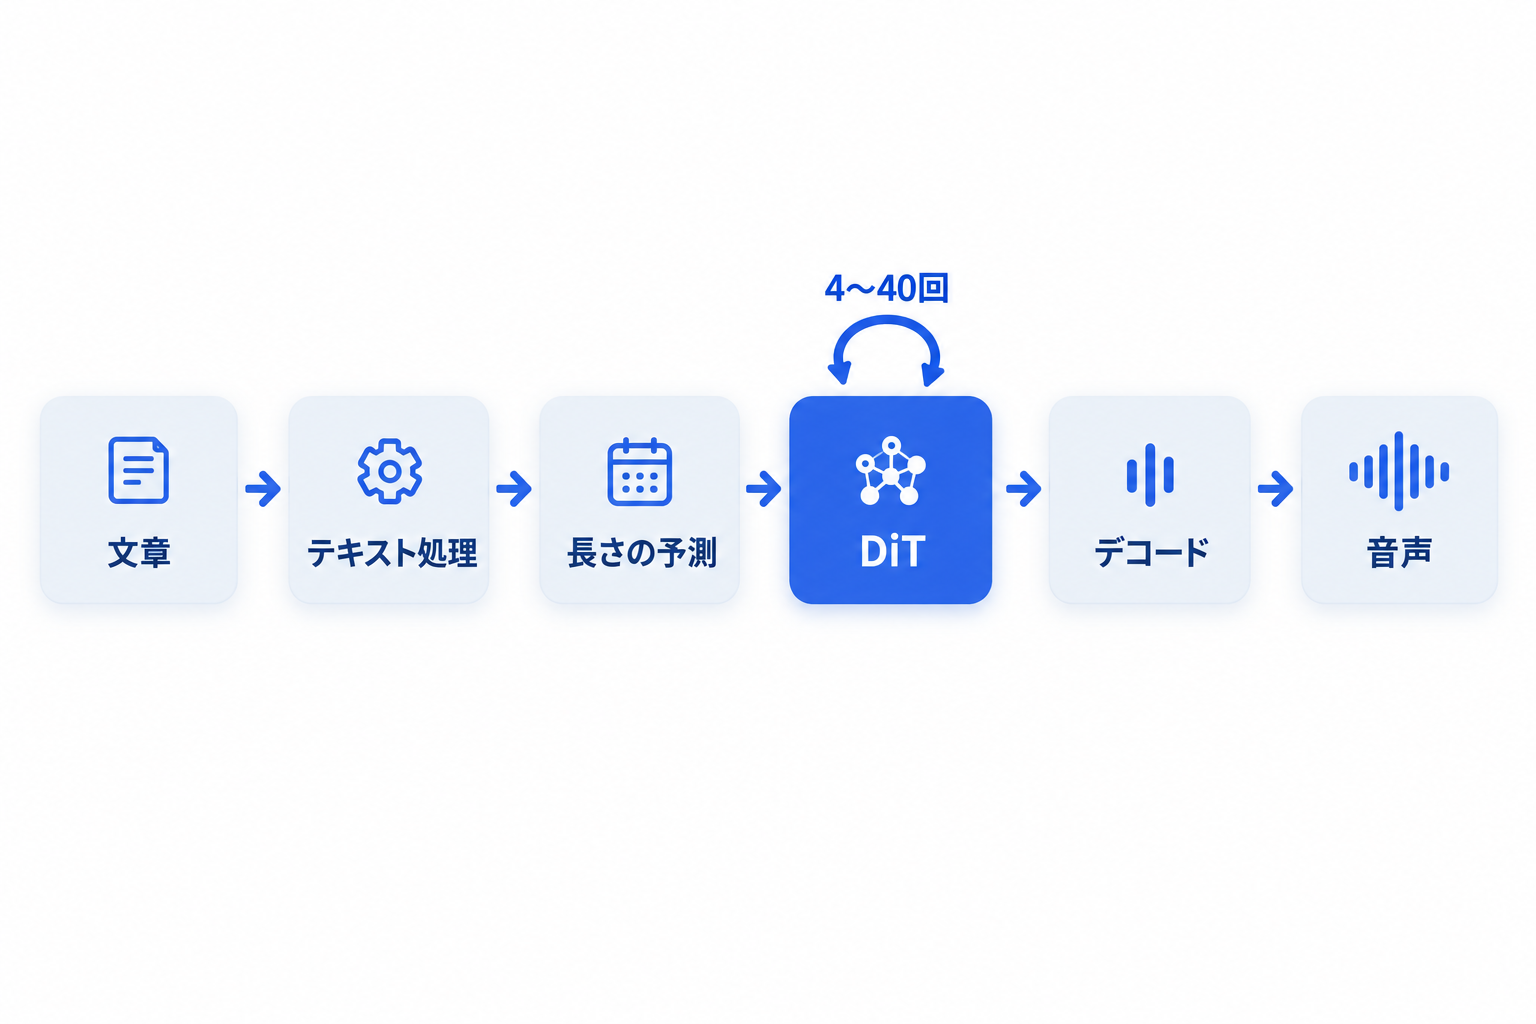
DiTはテキスト全体をいっぺんに見て解くので、途中から声を出すことはできません。公式の実装では、声が出るまでに、テキストの準備、長さの予測、サンプラーの全ステップ、コーデックのデコードが全部終わっている必要があります。
DiTがノイズから音声を作るやり方の違いで、モデルが2つあります。
もとのv4.1-SmallはRectified Flowで学習しています。ノイズと音声のあいだを直線で結んで、その途中の各点で「どちらにどれだけ進めばいいか」(速度) を覚えさせます。生成するときは、いまの速度を予測して少し進む、を40回繰り返します。テキストや話者に強く従わせるCFGのために、前半はDiTを3回ずつ計算するので、けっこう重いです。
v4.1-Small-MFは、v4.1-Smallを教師モデルとしてMeanFlowで蒸留したモデルです。MeanFlowは、その時点の速度ではなく、ある区間の平均の速度を覚えます。その時点の速度のまま大股で進むと曲がった道からはみ出してしまいますが、区間の平均の速度がわかっていれば大股でも目的地に着けます。教師モデルのCFG付きの道筋をそのまま学ぶので、生徒モデルは1ステップにDiTを1回計算するだけで済み、4ステップで音声ができます (Irodori-TTSのMeanFlowの説明)。
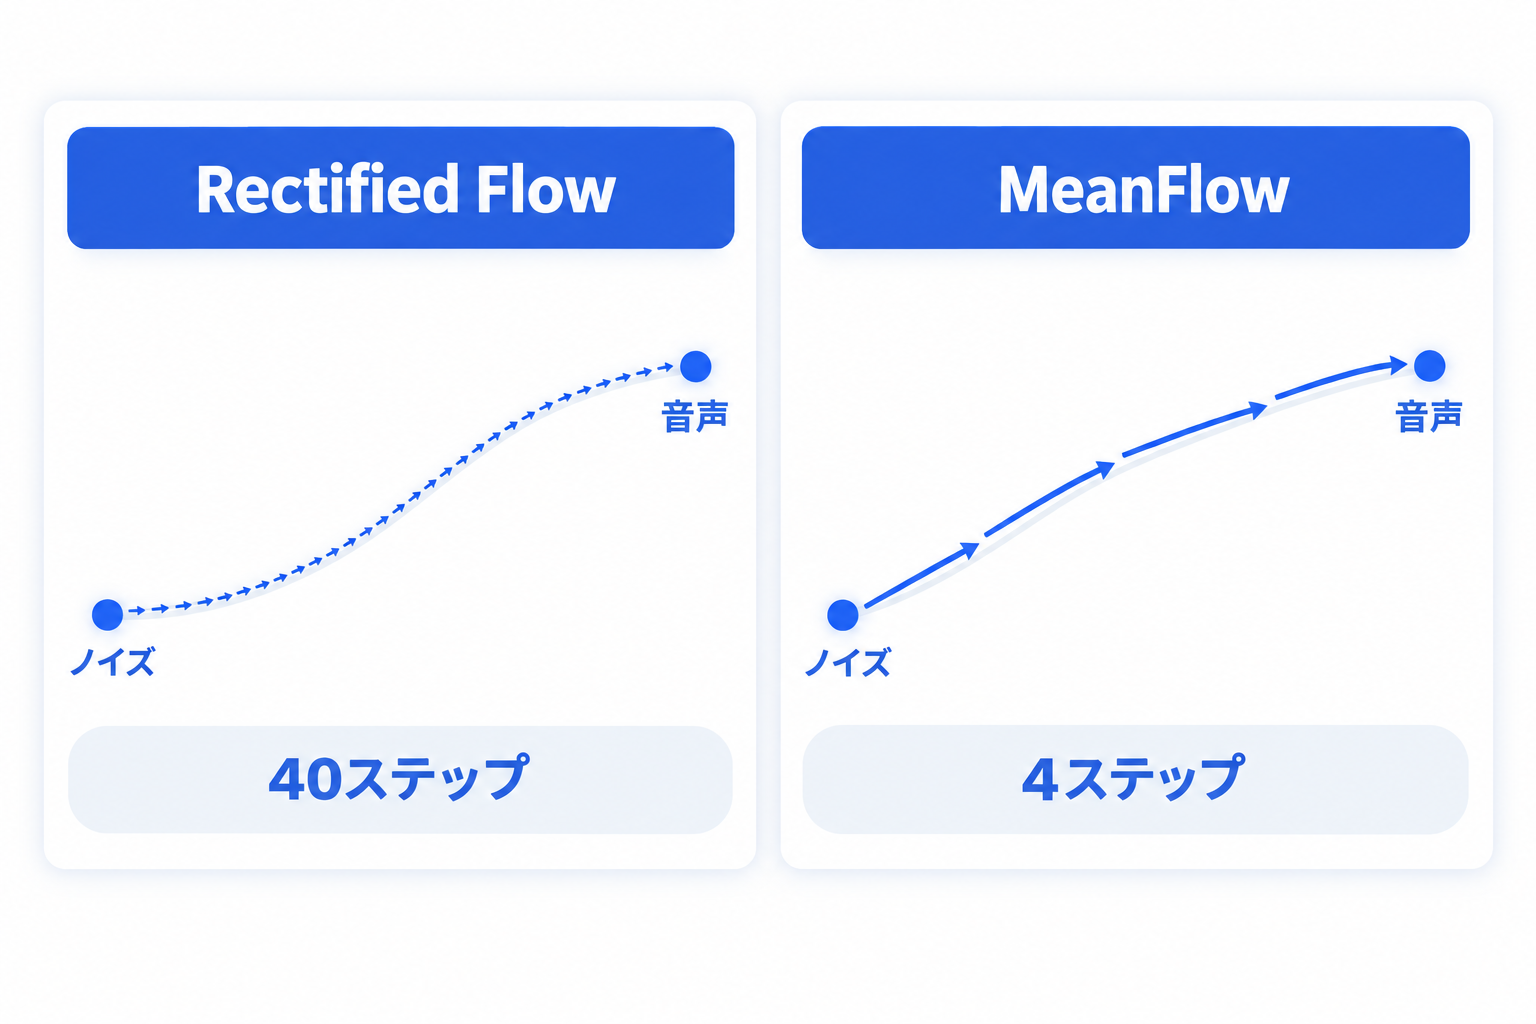
MFのモデルカードによると、v4.1-Smallをそのまま4ステップにすると参照音声との声の近さが0.75から0.38まで落ちますが、MFなら4ステップで0.74を保てます。会話では速さが大事なので、ASISTではMFを使っています。
公式の実装はどこに時間を使っているか
では公式の実装は何に時間を使っているのでしょうか。M5のMPSで、MFに33文字のテキストを読ませて処理ごとに計測しました。
| 処理 | 参照音声をWAVEで渡す | エンコードした潜在表現を渡す |
|---|---|---|
| 参照音声のエンコード | 0.92〜1.04秒 | 0.001〜0.005秒 |
| 長さの予測 | 0.25〜0.28秒 | 0.22〜0.24秒 |
| サンプラー (4ステップ) | 0.62〜0.63秒 | 0.55〜0.60秒 |
| コーデックのデコード | 1.29〜1.40秒 | 1.30〜1.41秒 |
| 合計 | 3.09〜3.35秒 | 2.07〜2.25秒 |
参照音声をWAVEファイルで渡すと、読ませるたびに毎回エンコードしています。一度エンコードした潜在表現を渡せばこの1秒はなくなり、音声もまったく同じものが出ます。残りでいちばん時間がかかっているのは、コーデックのデコードでした。MFでステップが4まで減ったので、DiTよりコーデックのほうが重くなっています。
速くする方法を考える
この内訳を見ながら、速くする方法を考えてみます。
ステップを減らすのは、MFを使えば済みます。参照音声のエンコードは、一度作った潜在表現を使い回せば済みます。
Irodori-TTSを速くする工夫は、ほかの方も試して記事にしています。Rossoさんの記事は、RTX 3080とv4で1文の時間を処理ごとに分けて測り、DiTの計算そのものより、GPUに命令を出す手間で時間がかかっていることを確かめています。そこでDiTをCUDA Graphに記録して命令を出す手間を省き、文ごとに違う音声の長さは、予測した長さを少し切り上げていくつかの長さにそろえることで対応しています。5.1秒の音声を作る時間が0.90秒から0.30秒になり、Sway Samplingでステップを8に減らすと0.23秒になっています。
Macではosushi_crさんの記事があります。M1 MaxのMPSとv2で、Sway Samplingでステップを40から8に減らし、モデルを常駐させて次の文を再生中に作っておくことで、5文の読み上げを28.77秒から10.58秒にしています。MPSではbf16にするとかえって遅くなり、コーデックをCPUに置くと2倍ほど遅くなったそうです。
どちらもPyTorchのまま、動かし方を工夫して速くしています。speech.cppでは、MacでもWindowsでも同じものをGPUで動かしたいので、別の方向も考えました。
重みを8ビットに量子化して軽くする手もあります。ただ、Irodori-TTSで試すと、20文を書き起こしたCERが2.99%から3.81%に増え、聞いてわかる崩れも出ました。
PyTorchから別の実行環境に移す方法もあります。ONNX Runtimeは、MacではCoreMLを経由し、これはプレビュー扱いで入力の形が変わると遅くなります。WindowsのDirectMLは保守だけの扱いになりました。MLXはMacでしか動きません。MacとWindowsの両方でGPUを使いたいので、ggmlを選びました。
ggmlは、llama.cppやwhisper.cppのもとになっているC/C++のテンソルのライブラリです。Metal、Vulkan、CUDA、CPU向けの計算をそれぞれ持っていて、計算グラフは呼ぶたびに組み立てるので、テキストの長さが毎回違っても困りません。実行ファイルにそのまま組み込めるので、使う側は何もインストールしなくて済みます。
最後に、作り終える前に声を出してしまう方法です。DiTはテキスト全体ぶんを一度に作るので途中では出せませんが、DiTが終わったあとのコーデックのデコードは、少しずつ進めて流せます。MFではコーデックのほうがDiTより重いので、ここを少しずつ流せば待ち時間はかなり減るはずです。
speech.cppでやったこと
speech.cppでは、MFをggmlに移植し、参照音声は潜在表現にしてファイル (声のファイル) に保存し、コーデックをウィンドウに分けてデコードしました。
コーデックは、全体を一度にデコードするのをやめました。最初の12フレーム (0.48秒ぶん) をデコードしたらすぐ返して再生を始め、残りは再生しているあいだに24〜48フレームずつデコードします。ウィンドウの大きさは、それまでのウィンドウで計測したデコードの速さから、聞いている人の手元に0.1秒ぶんの音声が残っているうちに終わる、いちばん大きいものを選びます。遅いPCでは小さく、速いPCでは大きくなります。
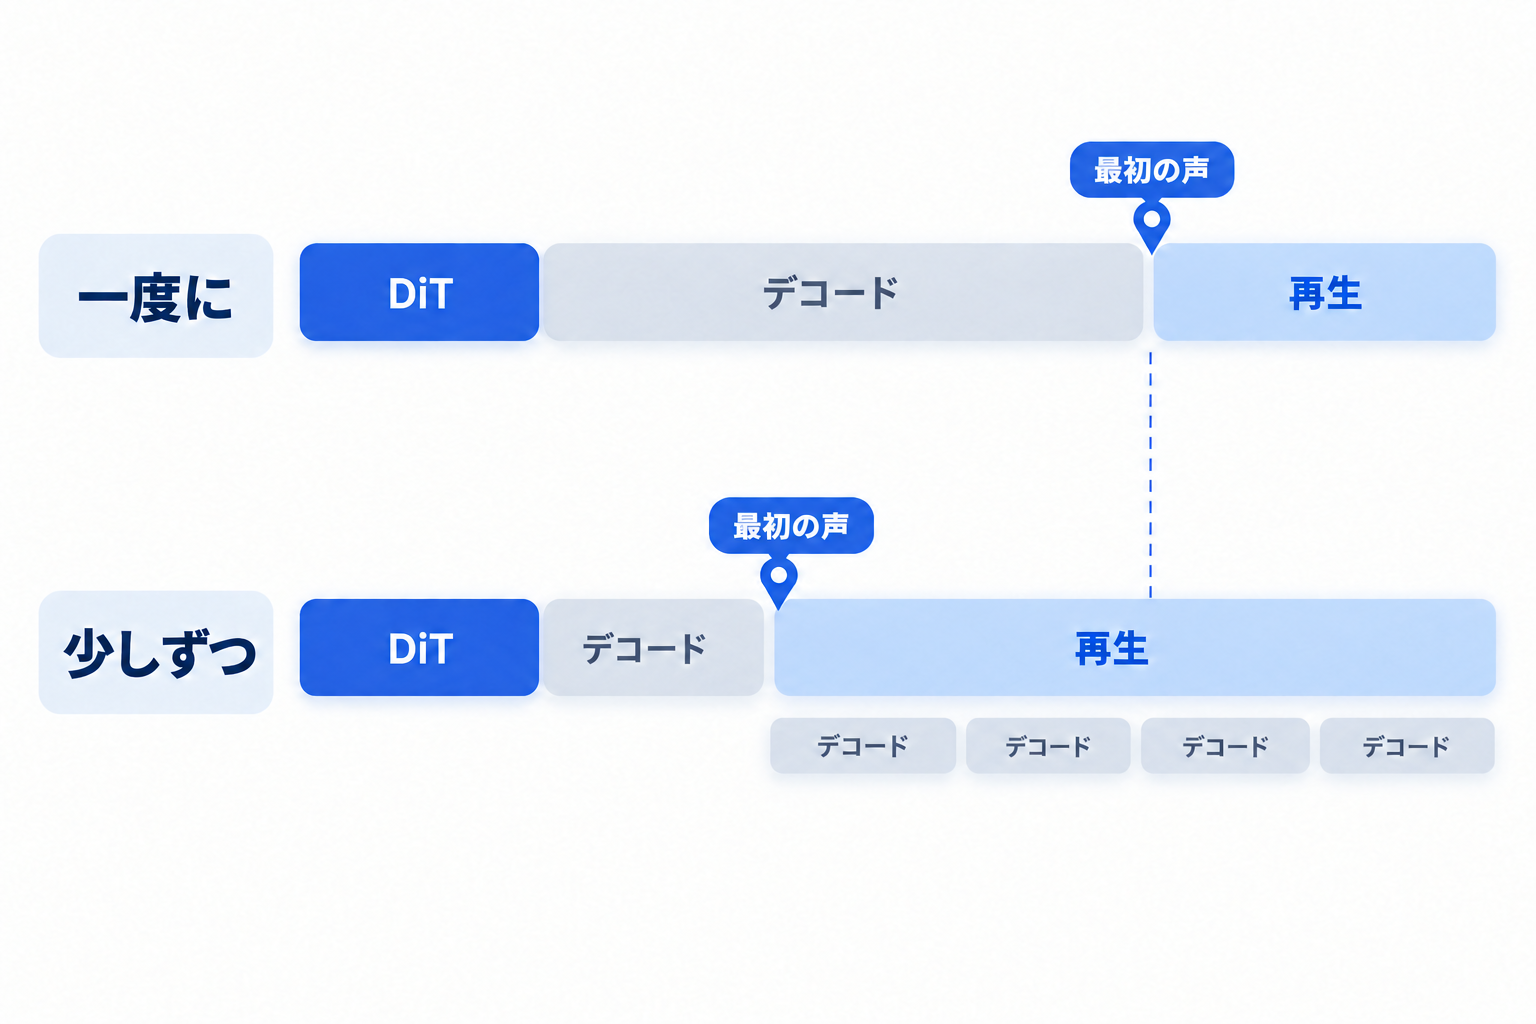
ウィンドウに分けるときは、つなぎ目で音が変わらないようにしています。各ウィンドウの前後に10フレームずつ余分にデコードして、その部分を捨てると、一度にデコードしたときと同じ波形になります。どの大きさで分けてもビット単位で同じなので、PCの速さでウィンドウの大きさが変わっても、同じseedなら同じ音声が出ます。これでデコードの時間のほとんどが再生と重なり、待ち時間にはほぼ入らなくなりました。
もうひとつ、会話ならではの工夫があります。会話では、アシスタントが話している途中でこちらが話し始めることがよくあります。そのとき読み上げ中の文を取り消しても、サンプラーが最後まで回ってしまうと次の返事が待たされます。そこでサンプラーのステップの合間に取り消されていないかを確かめるようにしました。120文字のテキストを取り消した直後の返事は、声が出るまで881ミリ秒かかっていたのが351ミリ秒になりました。
Qwen3-TTSは1フレームずつ流す
Qwen3-TTSは、Irodori-TTSとは逆に、LLMのように音声トークンを1フレームずつ出していくモデルです。1フレームは0.08秒ぶんの音声で、16個のコードブックのトークンでできています。talker (Qwen3のデコーダー) が各フレームの1つ目のトークンを出し、code predictorが残りの15個を埋めます。コーデックも過去の入力しか見ないので、1フレームできるたびにデコードして流せます。speech.cppではコーデックの途中の状態を次の呼び出しに持ち越しているので、1フレームずつデコードしても、全体を一度にデコードしたときとほぼ同じ波形になります (後で比較するqwentts.cppとの違いは、ここです)。
ほかの実装と比較する
M5で、同じ20文を、同じ参照音声、同じseedで読ませて比較しました。参照音声のエンコードは、どの実装も一度だけにしています。speech.cppの行は名前を太字にし、同じモデルの中でいちばん速い値も太字にしました (このあとの表も同じです)。
| モデル | 実装 | 最初の音声まで (中央値) | 最初の音声まで (p90) | RTF | CER |
|---|---|---|---|---|---|
| v4.1-Small-MF | speech.cpp (Metal、F16) | 0.25秒 | 0.52秒 | 0.17 | 6.14% |
| v4.1-Small-MF | mlx-audio (MLX、FP16) | 1.01秒 | 2.67秒 | 0.17 | 4.48% |
| v4.1-Small-MF | 公式の実装 (PyTorch、MPS、FP32) | 1.33秒 | 3.19秒 | 0.21 | 8.62% |
| v4.1-Small、16ステップ | speech.cpp (Metal、F16) | 1.24秒 | 3.40秒 | 0.34 | 3.15% |
| v4.1-Small、16ステップ | mlx-audio | 1.84秒 | 4.54秒 | 0.31 | 1.99% |
| v4.1-Small、16ステップ | 公式の実装 | 2.69秒 | 7.37秒 | 0.45 | 3.48% |
| v4-Small、16ステップ | audio.cpp v0.9.0 (コーデックもMetal) | 1.55秒 | 4.26秒 | 0.28 | 9.62% |
| v4-Small、16ステップ | audio.cpp v0.9.0 (コーデックはCPU) | 10.22秒 | 30.11秒 | 1.77 | 5.31% |
| Qwen3-TTS 0.6B | speech.cpp (Metal、Q8_0) | 0.04秒 | 0.05秒 | 0.31 | 5.80% |
| Qwen3-TTS 1.7B | speech.cpp (Metal、Q8_0) | 0.06秒 | 0.11秒 | 0.42 | 2.99% |
RTX 2080 (Vulkan) のWindowsでも計測しました。mlx-audioはMacでしか動かず、公式の実装はWindowsでは試していないので、この表には入っていません。
| モデル | 実装 | 最初の音声まで (中央値) | 最初の音声まで (p90) | RTF | CER |
|---|---|---|---|---|---|
| v4.1-Small-MF | speech.cpp (Vulkan、F16) | 0.12秒 | 0.20秒 | 0.07 | 7.13% |
| v4.1-Small、16ステップ | speech.cpp (Vulkan、F16) | 0.52秒 | 1.12秒 | 0.13 | 3.15% |
| v4-Small、16ステップ | audio.cpp v0.9.0 (Vulkan) | 1.06秒 | 3.01秒 | 0.19 | 3.81% |
| Qwen3-TTS 0.6B | speech.cpp (Vulkan、Q8_0) | 0.03秒 | 0.04秒 | 0.27 | 7.96% |
| Qwen3-TTS 1.7B | speech.cpp (Vulkan、Q8_0) | 0.04秒 | 0.05秒 | 0.32 | 2.82% |
表の時間は、合成を要求してから最初の音声が届くまでです。声が実際に始まるまでとは違います。Qwen3-TTS 0.6Bは、文の頭に無音を作ることが多いモデルです。最初の音声は0.04秒で届いても、声が聞こえ始めるのは中央値で0.5秒ほどあとでした (4人の声で0.24〜0.48秒、長いときは1.9秒)。公式の実装でも同じで、ono_annaに同じ文を20回読ませると、頭の無音は中央値で0.89秒ありました。1.7Bは0.10秒、Irodori-TTSのMFは0.03秒なので、会話で使うなら1.7BかIrodori-TTSのほうが早く声が聞こえます。
公式の実装もmlx-audioもaudio.cppも、音声を全部作り終えてから返すので、声が出るまでの時間は1文を作り終える時間と同じです。speech.cppは最初のウィンドウをデコードしたら返すので、ここで差がつきます。MFのRTFはmlx-audioとほぼ同じ (0.174と0.171) なので、全体の速さはあまり変わらず、声が出るまでの差はほとんどがウィンドウに分けてデコードしたおかげです。CERは、合成した音声をQwen3-ASR 1.7Bで書き起こして数えたもので、実装ごとにノイズの作り方が違うので、1回の計測だと数ポイントは上下します。audio.cppはMFに対応していないので、RFの16ステップで比較しています。
声が出たあとに途切れないようにする
声が早く出ても、途中で途切れては困ります。音声をチャンクに分けて少しずつ渡すときは、届いた音声を再生し終える前に、次のチャンクが届いている必要があります。最初のチャンクを小さくすれば声は早く出ますが、そのぶん次のチャンクが間に合いにくくなります。
ほかの実装は、これをそれぞれ別のやり方で避けています。Qwen3-TTSの公式は、最初から4フレーム (0.32秒分) ずつ送ります (Qwen3-TTS Technical Report)。途切れにくい代わりに、最初の声は4フレームを作り終えるまで出ません。CosyVoiceは、チャンクを毎回決まった倍率で大きくしていきます。倍率は、動かすPCの速さに合わせて人が決めます。再生する側で多めに貯めてから鳴らすやり方もありますが、そのぶん声が出るのが遅れます。
speech.cppのQwen3-TTSでは、最初は小さく、だんだん大きくしていくようにしました。チャンクの大きさは、1フレーム、1フレーム、2フレーム、そのあとは4フレームずつです。
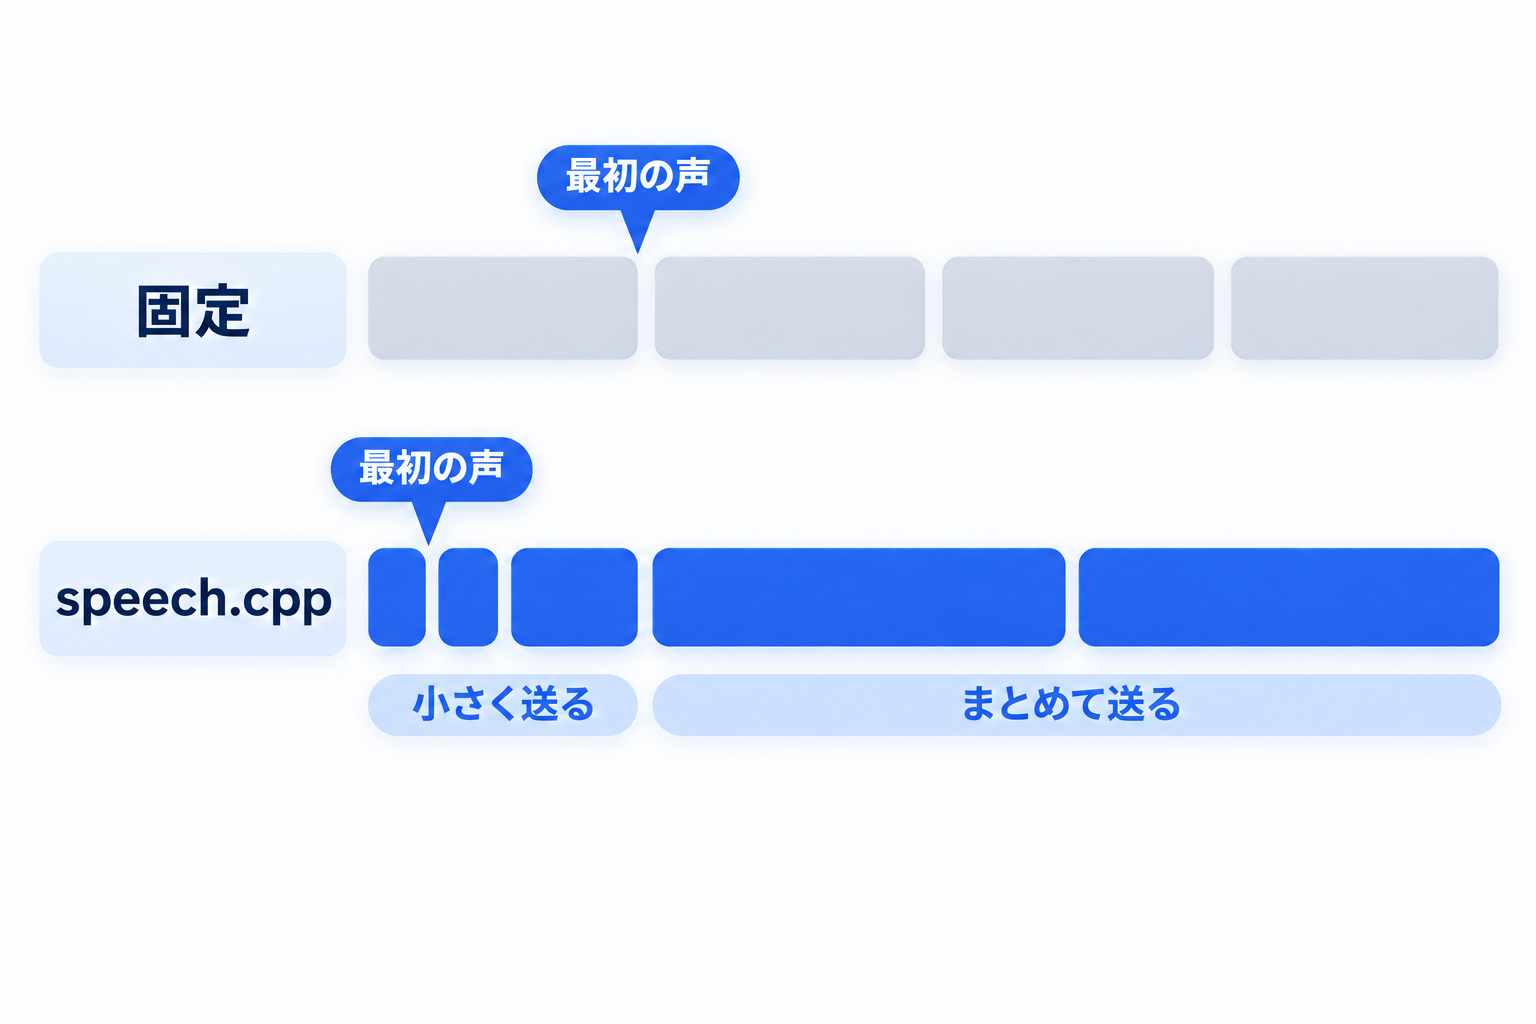
1フレームを作るのにかかる時間は、M5でもRTX 2080でも、1フレームぶんの音声 (0.08秒) よりずっと短いので、小さいチャンクで始めれば、次のチャンクが届く前に手持ちの音声が尽きることはありません。そのあとは4フレームずつまとめて送るので、コーデックを呼ぶ回数もほとんど増えません。
チャンクの大きさを、その場の速さを計測しながら決めることも考えました。ただ、チャンクの分け方が変わると、聞き分けられないほどわずかですが音声の値も変わります。その場の速さで分け方を決めると、同じseedでも実行するたびに音声が変わってしまうので、決まった表にしています。ここまでの話は、生成した音声を頭の無音も含めて、そのまま再生する場合です。
本当に途切れないかも確かめました。同じ20文を読ませ、最初のチャンクが届いたらすぐ再生を始めたとして、手元の音声を鳴らし終える前に次のチャンクが届いているかを見ています。M5でもRTX 2080でも、Qwen3-TTSの0.6Bと1.7B、Irodori-TTSのMFと16ステップのどれも、20文すべてで一度も途切れませんでした。
ASISTでは、頭のほぼ無音な部分だけを削ります。息やため息などの音が始まったら、その後の間も残します。ただ、頭を削るとその間に次の音声を作る余裕もなくなるので、最初の音が届いてから、届いている音声の長さと合わせて0.2秒になるだけ待って鳴らします。すでに前の文の再生を待つ間に0.2秒以上届いていれば、追加では待ちません。
公開版のASIST 0.8.0でも、M5で同じ20文を読ませて確かめました。モデルを読み込んだあと、合成開始から声の部分を再生する予定時刻までの中央値は、Qwen3-TTS 0.6Bが0.40秒、1.7Bが0.25秒、Irodori-TTS MFが0.26秒でした。これはWeb Audioの再生予定から求めた値で、スピーカーや出力機器の遅延は含めていません。
これで音声合成は、会話に間に合う速さで、途切れずに話せるようになりました。
公式実装と同じ形状であることをしっかり確かめる
モデルを別の実行環境に移すと、計算の順番や精度が少しずつ変わります。音声合成なら声が少し変わり、音声認識なら書き起こしのテキストが変わります。困るのは、聞いただけでは気づけないことです。音声合成は毎回ノイズから作るので、もともと読むたびに声が少し違いますし、音声認識の違いは数十件に1件にしか出ないこともあります。
そこでspeech.cppでは、移植するモデルごとに、公式の実装と段階ごとに比較するようにしました。
たとえばIrodori-TTSでは、テキストの処理、DiT、デコードの段階ごとに、次のように比べています。
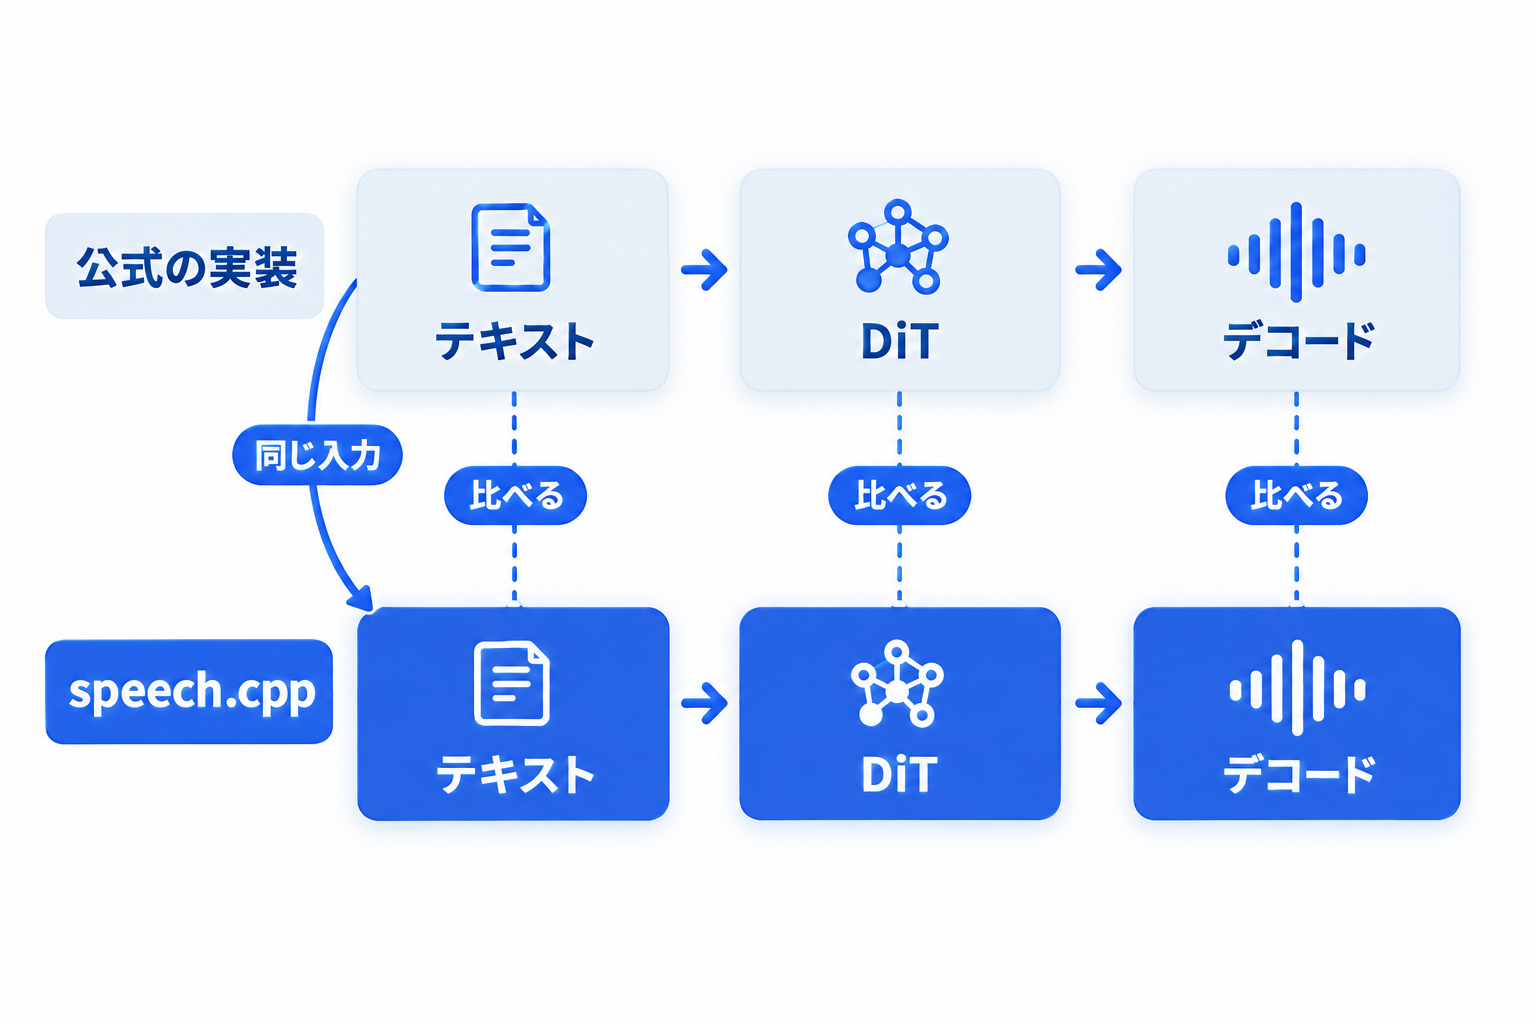
- 公式の実装をCPUのfloat32で、ノイズを固定して動かし、各段階の入力と出力をファイルに書き出す
- 移植したほうの各段階に、書き出した同じ入力を渡す
- 出力を比較する。数値はSNR (誤差が信号よりどれだけ小さいか) で、トークンや文字列は完全に一致するかで見る
ほかのモデルも、段階の分け方が違うだけで同じように比べています。Qwen3-TTSはサンプリングせずにgreedyで動かして比べ、音声認識のモデルは、音声の特徴量、エンコーダー、デコーダーの段階ごとに比べます。
1段ずつ同じ入力から始めるので、どこでずれたかがすぐわかります。CPUのfloat32なら、Irodori-TTSはどの段階も公式と86 dB以上の精度で一致し、Qwen3-TTSはgreedyデコードで読ませると公式と同じ54フレームを出し、parakeetとReazonSpeechは音声から書き起こしたテキストがすべて公式と一致します (表はAppendixにあります)。
この比較をしていると、ほかの実装でずれてるとこにも気がつけるようになりました。
- llama.cppのQwen3-ASRは、公式と違うテキストを書くことがありました。10個の録音を書き起こさせると (言語を自動にした場合と指定した場合で、合わせて20回)、0.6Bで6回、1.7Bで4回が公式と違っていました。たとえば公式が「群島や湖では必ずしもヨット」と書いたところを、1.7Bは「軍港や湖ではカマザタ寿司もヨット」と書いています。原因は、モデルに渡す入力が公式と少しずつ違うことでした。最初に置く指示 (systemの発言) が抜けていて、音声の特徴量 (log-mel) が1フレーム多く、音声の最後の1秒に満たない部分をゼロで埋めて、その無音のぶんまで音声のトークンにしています
- qwentts.cppのQwen3-TTSは、少しずつ流しながら作ると、声に震えるような雑音が乗りました。同じテキストを一度に全部作ったときは乗りません。Qwen3-TTSのコーデックは、それまでの音声の続きとして次の音声を作る仕組みです。なので、チャンクをまたいでコーデックの途中の状態を引き継げば、少しずつ作っても一度に作ったときとほぼ同じ波形になります。speech.cppはそうしていて、1フレームずつ作った音声と一度に作った音声の差が、聞き分けられないほど小さい (133 dB) ことを確かめています
- CrispASRのReazonSpeechは、前後に無音の残る録音で、録音にない「あっ。」や「うん。」を書き足しました (Common Voiceの最初の10文のうち4文)。前後の無音を詰めると、4,479文のうち数文に減ります
- audio.cppのIrodori-TTSは、コーデックをMetalで動かすと、声の14 dB下に歪んだ同じ声が重なり、無音のはずの部分も持ち上がります
どれも、聞き比べただけでは気づきにくい違いです。逆に、段階ごとに公式と同じだと確かめられていれば、速くするために計算の形を変えても、結果が変わっていないことをすぐ確かめられます。次は、ユーザーの声を聞くほうです。
音声認識: きれいに移植できるようにがんばる
FastConformerを1回だけ移植する
音声認識のモデルで最初に移植したのは、NVIDIAのNeMoのモデルです。parakeet-tdt_ctc-0.6b-ja (日本語)、parakeet-tdt-0.6b-v3 (ヨーロッパの25言語)、ReazonSpeech NeMo v2 (日本語) の3つは、どれもFastConformerという同じ形をしています。log-melの特徴を作り、畳み込みで時間方向を8分の1にして、24層のConformerに通し、最後のデコーダーでトークンにします。
違いは細かいところだけです。
| parakeet-ja | parakeet-v3 | ReazonSpeech | |
|---|---|---|---|
| melのbin | 80 | 128 | 80 |
| attention | 録音全体 | 録音全体 | 前後10.24秒 (local attention) |
| デコーダー | TDT | TDT | RNN-T のビームサーチ |
なので、FastConformerを1回だけ移植して、違うところはGGUFのファイルに書いた設定で切り替えるようにしました。
デコードのやり方は、NeMoのtranscribe()がデフォルトで使うものに合わせています。parakeet-jaにはCTCの頭もついているのですが、NeMoはデフォルトでTDTを使い、2つは一部の発話で違うテキストを書くので、TDTだけを移植しました。ReazonSpeechも、NeMoのgreedyデコードではなく、モデルの設定にあるビームサーチ (幅4) を使います。greedyデコードだと、句読点が抜けたり別の言葉になったりする発話があったからです。ただgreedyのほうがずっと軽いので、頼めばgreedyでもデコードできるようにしました。Common Voiceの4,483文では、M5でCERが12.03%から12.50%に上がるかわりに、待ち時間の中央値は0.110秒から0.077秒になります。
Qwen3-ASRも組み込むことに
Qwen3-ASRは、音声のエンコーダーの後ろにQwen3の言語モデルがつながった形をしています。言語モデルの部分は、キャッシュを持って1トークンずつ書き出していくので、llama.cppがもともと得意なところです。なので最初は、Qwen3-ASRはllama.cppで動かして、speech.cppではFastConformerだけを動かすつもりでした。同じことを2回作る必要はないと考えたからです。
ところが、段階ごとに比較してみると、前に書いたとおりllama.cppのプロンプトは公式と違い、20回中4〜6回でテキストが変わりました。約270秒より長い発話も失敗します。それに、llama-serverを動かし続ける限り、ASISTはspeech.cppとは別の実行環境をもう1つ抱えることになります。
そこで考え直して、Qwen3-ASRもspeech.cppに移植しました。実はQwen3のデコーダーは、Qwen3-TTSのtalkerですでに移植していました。同じものなので、そのまま使い回せます。新しく作ったのは、8秒ずつのウィンドウの中だけを見る音声のエンコーダーと、公式のqwen-asrが書くとおりのプロンプトです。言語を指定すると、答えの書き出しにlanguage Japanese<asr_text>を置いてモデルを導くところまで、公式と同じにしています。こうすると、書き起こしのテキストは公式と同じになりました。
公式と同じ書き起こしが出せるようになったので、次はどのくらい正しく聞き取れているかを計測したくなります。ところが日本語では、この「正しさ」を計測すること自体にも難しさがありました。
表記の揺れを許して日本語の書き起こしの精度を計測する
音声認識の正しさは、ふつう書き起こしと参照のテキストの文字の誤り率 (CER) で計測します。ただ日本語は、同じ言葉にいくつもの書き方があります。参照が「三十分」で書き起こしが「30分」なら、聞き取りは合っているのに、CERでは誤りとして数えられてしまいます。
| 参照 | 書き起こし | 誤りとして数えるべきか |
|---|---|---|
| 27パーセント | 27% | 数えない (同じ言葉の別の書き方) |
| 三十分 | 30分 | 数えない |
| 今日 | きょう | 数えない |
| README | リードミ | 数えない |
| 機会 | 機械 | 数える (同じ音でも、意味がまったく違う言葉) |
| 3時半 | 3時30分 | 数える (意味は同じでも、話した言葉と違う) |
モデルが良くなるほど、CERは「聞き取れたか」より「参照と同じ書き方を選んだか」を計測するようになっていきます。
これは日本語に限った話ではなく、いくつも研究があります。
- Karita, Sproat, Ishikawa (CAWL 2023)は、日本語の参照のテキストを、ありうる書き方の組み合わせ (ラティス) に広げてから採点しています。人が見て95.4%の書き方を妥当と判断し、CERはタスクによって2.4〜3.1ポイント下がりました
- OIWER (ICASSP 2026)は、インドの言語で、LLMを使って書き方の揺れを拾っています。誤り率は平均で6.3ポイント下がり、人の感覚に近くなりました
- HiKE (EACL Findings 2026)は、韓国語と英語が混ざる話し言葉の評価セットで、外来語にラベルを付けています
- Kacprzak and Fraś (2026)は、ポーランド語で、数字を正規化するかどうかだけでWERが2ポイント以上動き、システム同士の差を上回ることがあると報告しています
- 昔からある評価ツールのNIST sclite も、参照に
{ a / b / @ }のように別の書き方を並べて書けるようになっています
そこで、計測に使っているspeech-benchでは、ふつうのCERのほかに、表記の揺れを許したCERも出すようにしました。参照のテキストの1文ごとに、次のような注釈を付けておきます。
- かなで書かれていない部分には、読みをかなで付ける:
明日《あした》、|Zoom《ズーム》 - 読みだけでは表せない別の書き方を並べる:
[九《く》時《じ》/9時] - 「えーと」のようなフィラーは、なくてもよいことにする:
[えーと/えっと/]
書き起こしは、この注釈から作れる書き方のうち、いちばん近いものと比較して誤りを数えます。分母は参照のテキストの文字数のままなので、表記の揺れを許したCERは、ふつうのCERより大きくなることはありません。同じ音でも意味の違う言葉 (機会 と 機械) や、意味は同じでも話した言葉と違うもの (3時半 と 3時30分) は許さないので、本当の聞き間違いは誤りとして残ります。
Common Voice 8.0の日本語のテスト (4,483文) に付けた注釈は、sakasegawa/common-voice-ja-accepted-spellingsとしてHugging Faceに公開しています (CC0)。採点するスクリプトも付けていて、speech-benchと同じ誤りを数えることを、17,932件の書き起こしで確かめています。Common Voiceの音声とテキストはそれぞれの配布元から取ってきて、このデータセットの注釈と合わせて使います。
表記の揺れを許すと、たとえばCommon VoiceでのQwen3-ASR 1.7BのCERは9.25%から4.56%になります。誤りとして数えられていたもののおよそ半分が、書き方の違いだったということです。このあとの表では、両方のCERを並べています。
精度を比較するためのベンチマークはこれで準備できました。ただ、移植した直後のspeech.cppは、llama.cppより遅かったのです。
llama.cppと同程度になるまで速くする
M5でQwen3-ASR 0.6Bを動かすと、speech.cpp 0.7.0は1秒に123〜132トークンを書き出し、llama.cppは158〜165トークンでした。音声認識の時間の9割はこのデコードなので、ここを詰めないとllama.cppより遅いままです。
やったことは2つです。
1つ目はflash attentionです。speech.cppのQwen3のデコーダーは、attentionを2回の行列積とsoftmaxで計算していました。ggmlのggml_flash_attn_extはスコアを溜めずにまとめて計算するので、GPUではこちらのほうが速くなります。M5のMetalでは、キャッシュが2,000位置なら2.62ミリ秒が2.20ミリ秒に、8,000位置なら9.59ミリ秒が8.10ミリ秒になりました。ただCPUでは逆に、8,000位置で22.1ミリ秒が51.2ミリ秒と遅くなります。なので、モデルを読み込むときに、そのGPUのバックエンドがflash attentionを計算できるか (ggml_backend_supports_op) を見て、できるときだけ使うようにしました。
flash attentionは、attentionを小さなブロックに分けて、softmaxを少しずつ更新しながら計算し、大きなスコアの行列をメモリに置かない計算のやり方の名前です (Dao et al., 2022)。CUDAのライブラリのFlashAttention-2はRTX 30シリーズ以降向けですが、ggmlは同じやり方をMetalやVulkanのシェーダーで自前で書いているので、RTX 2080のVulkanでも使えます。
2つ目は、デコードの1ステップごとの計算グラフを、トークンの間で使い回すことです。ggmlでは計算グラフを組み立てるのにも時間がかかるので、形が同じあいだは組み立て直さないようにしました。
これで、M5のデコードは0.6Bで1秒に146〜158トークン (llama.cppは147〜157)、1.7Bで58〜63トークン (同じく58〜62) と並びました。RTX 2080では、0.7.0より13〜25%速くなりました。
Common Voice 8.0の日本語のテスト (4,483文) を、RTX 2080のWindowsで書き起こしてみた結果がこちらです。前後の無音はVADで詰めています。CERは書き起こしの文字の誤り率で、その右の列が前の章の表記の揺れを許したCERです。待ち時間は、要求を送ってからテキストが返るまでです。NVIDIAが出しているNeMo-Speech.cppも、speech.cppと同じくggmlでFastConformerを動かす実装なので、一緒に比べました。
| モデル | 実装 | 重み | CER | 表記の揺れを許したCER | 待ち時間 (中央値) | 待ち時間 (p90) |
|---|---|---|---|---|---|---|
| Qwen3-ASR 1.7B | speech.cpp | Q8_0 | 9.50% | 4.68% | 0.155秒 | 0.286秒 |
| Qwen3-ASR 1.7B | llama.cpp b11246 | Q8_0 | 9.28% | 4.60% | 0.173秒 | 0.289秒 |
| Qwen3-ASR 0.6B | speech.cpp | Q8_0 | 11.90% | 7.04% | 0.087秒 | 0.158秒 |
| Qwen3-ASR 0.6B | llama.cpp b11246 | Q8_0 | 11.80% | 6.94% | 0.105秒 | 0.167秒 |
| parakeet-tdt_ctc-0.6b-ja | speech.cpp | F16 | 7.88% | 2.98% | 0.069秒 | 0.130秒 |
| parakeet-tdt_ctc-0.6b-ja | CrispASR v0.8.38 | Q8_0 | 7.93% | 3.01% | 0.189秒 | 0.280秒 |
| ReazonSpeech NeMo v2 | speech.cpp (ビームサーチ) | F16 | 12.03% | 7.14% | 0.157秒 | 0.268秒 |
| ReazonSpeech NeMo v2 | speech.cpp (greedy) | F16 | 12.48% | 7.68% | 0.092秒 | 0.149秒 |
| ReazonSpeech NeMo v2 | CrispASR v0.8.38 | Q8_0 | 11.72% | 6.79% | 0.196秒 | 0.302秒 |
| ReazonSpeech NeMo v2 | NeMo-Speech.cpp v0.2.0 (greedy) | F16 | 11.81% | 6.99% | 0.059秒 | 0.101秒 |
Qwen3-ASRは、精度がllama.cppとほぼ同じで、待ち時間は1.7Bで10%、0.6Bで17%短くなりました。parakeetは、精度がCrispASRと同じで、待ち時間は3分の1です。重みがspeech.cppではF16、CrispASRではQ8_0なので、差の一部は重みの違いかもしれません。
ReazonSpeechは、NeMo-Speech.cppがいちばん速く、精度も少し上でした。greedyどうしで比べても、speech.cppより1.6倍速いです。M5でも1.4倍の差があり、parakeet-v3でもNeMo-Speech.cppのほうが速かったので (表はAppendixにあります)、FastConformerのどこで差がついているかを調べて、次のリリースで詰めるつもりです。CrispASRのReazonSpeechは、前の章で書いたように前後の無音に「あっ。」を書き足しますが、無音を詰めたこの条件では、speech.cppのビームサーチより少し正確でした。Common Voiceは文を読み上げた録音なので、会話の話し言葉ではまた違う結果になりえます。
ちなみに、M5ではまだllama.cppのほうが少し速いところがあります。Common Voiceの4,483文では待ち時間の中央値が並び、p90はllama.cppのほうが8%短くなりました。長い発話ほど差が出ていて、25.5秒の日本語の発話では、0.6Bはspeech.cppが0.80秒、llama.cppが0.75秒でした。デコードは並んだので、差が出ているのは音声のエンコーダーとプロンプトの読み込みです。llama.cppはここの行列積をMetal 4のtensor APIで計算していて、speech.cppはそれを使っていません。使わなかったのはちょっとしたバグが理由でした。以下でそれについて軽く説明します。
M5で見つけた不具合
Irodori-TTSの移植が終わって完成と思ったころ、M5で読ませた64本のうち1本だけ、音声の後半が雑音になりました。「暗証番号は4桁で、8264です。」の「8264です」がザーッという音に埋もれています。同じテキストをCPUやRTX 2080で読ませると、きれいに出ます。
調べると、原因はggmlのMetalの行列積でした。M5以降のチップでは、ggmlはMetal 4のtensor APIで行列積を計算します。このkernelが、出力の列の数を128で割って64余るとき (64、192、320…) だけ、出力の外まで書き込んでいました。はみ出した書き込みが隣のテンソルを書き換えるので、毎回違う結果になります。
雑音になった音声は、ちょうどこの条件に当たっていました。そのころはコーデックを48フレームずつ、前後に10フレームずつ足してデコードしていたので、114フレームの音声の3つ目のウィンドウが50〜114フレーム、つまりぴったり64フレームだったのです。
ggml自身のテスト (test-backend-ops) は通っていました。この形のケースがなかったからです。64列と192列のケースを足すとtensor APIでは失敗し、GGML_METAL_TENSOR_DISABLE=1でtensor APIを止めると通りました (speech.cpp#13)。
本体が直る前にできることは限られています。speech.cppではM5で同じ20文を読ませて比較してみてこの差は受容できる(というか、するしかない)と考え、tensor APIを止めています。
| tensor API | 止めたとき | |
|---|---|---|
| Irodori-TTS MF、最初の音声まで (中央値) | 0.19秒 | 0.23秒 |
| Irodori-TTS 16ステップ、最初の音声まで (中央値) | 0.85秒 | 1.12秒 |
| Qwen3-TTS 0.6B、最初の音声まで (中央値) | 0.045秒 | 0.043秒 |
| Irodori-TTSのコーデック、公式とのSNR | 47.6 dB | 68.0 dB |
声が出るまでは0.04秒遅くなりましたが、雑音の心配がなくなり、ついでに公式との差も小さくなりました。前の章のM5での音声認識の差もこれが大きいです。ggmlの新しいバージョンでこの形のケースが通るようになったら、tensor APIを使うように戻して計測し直すつもりです。
OpenAIのRealtime Transcriptionに対応する
さて、ここまでは1つの発話を書き起こす話でした。使っていると、会議のような長尺の録音を書き起こしたり、話しているそばから文字を出したりしたくなります。0.8.0では、この2つを入れました。
長尺の録音を丸ごと渡すと文が消える
試すページで書き起こしていると、話したはずの文がまるごと抜けることがありました。ページは音声を20秒ずつに切ってサーバーに送っていて、その20秒に3つか4つの文が入っていると、ReazonSpeechが前の2文を落としていたのです。公式のNeMoに同じ音声を渡しても同じ文を落としたので、移植の誤りではなく、モデルの性質です。
どれくらい落ちるのかを測りました。FLEURSとCommon Voiceの日本語のテストの文を、0.3〜1.0秒の間をあけてつないで数分の録音を作り、丸ごとと、話している区間ごとに書き起こしました (作り方はAppendixに書きました)。半分以上の文字が消えた文を「落ちた」と数えています。
| モデル | 丸ごと (FLEURS 321文 / Common Voice 600文) | 区間ごと (同じく) |
|---|---|---|
| ReazonSpeech NeMo v2 | 67文 / 522文 | 4文 / 46文 |
| parakeet-tdt_ctc-0.6b-ja | 264文 / 266文 | 0文 / 11文 |
| Qwen3-ASR 0.6B | 1文 / 1文 | 0文 / 2文 |
FastConformerの2つは、数分を丸ごと渡すと文をまとめて落とします。いっぽうQwen3-ASRはほとんど落とさず、CERも丸ごとのほうが少しよいくらいでした (FLEURSで9.80%と11.44%)。LLMのデコーダーが、前後の文脈を長く使えるからだと思います。区間ごとでもCommon VoiceでReazonSpeechが46文落としているのは、話す人の違う短い文が1つの区間に入ってしまうためで、つないだ録音ならではの数字です。
そこで、音声のどこで人が話しているかを見つけるSilero VADを移植して、区間ごとに書き起こしてつなぐようにしました。Silero VADは1.2 MBの小さなモデルで、公式のget_speech_timestampsと同じ区間をサンプル単位で返します。区間の終わりの決まりはOpenAIのserver_vadの既定に合わせて、0.5秒の無音で区切ります。間の短い話し方だと1つの区間が20秒を超えるので、区間の長さの上限を8秒から30秒まで変えて測り、平均のCERがいちばん低かった10秒にしました。
HTTPサーバーでは、OpenAIの書き起こしのAPIのchunking_strategyで区間ごとになります。まず、音声認識とVADの両方のモデルを読み込んでサーバーを起動します。前の例のサーバーが動いていれば、Ctrl+Cで止めてから実行してください。
speech serve reazonspeech-v2 silero-vad
別のターミナルから、OpenAIのPythonのSDKで呼び出せます。
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8080/v1", api_key="unused")
with open("meeting.wav", "rb") as f:
print(client.audio.transcriptions.create(model="reazonspeech-nemo-v2", file=f, chunking_strategy="auto").text)
話しているそばから文字を出す
もう1つは、話しているそばから文字を出すことです。形はOpenAIのRealtime APIの書き起こしに合わせたので、OpenAIのクライアントは接続先を変えるだけで使えます。
Realtime APIでは、話している途中の文字はdeltaというイベントで送ります。deltaは後ろに足していくことしかできず、前に送った文字を書き換える手段がありません。OpenAIのgpt-live-transcribeも、deltaを足していき、話し終わりのcompletedで全体を置き換える形です。speech.cppは、話している途中の音声を読み直すたびに前回の結果と比べて、2回続けて同じだった先頭の部分だけをdeltaで送り、話し終わったらcompletedで確定した文を送ります。
M5でほかに何も動かさず、6つの発話をつないだ音声を実時間で3回ずつ流して計りました。
| ReazonSpeech NeMo v2 | Qwen3-ASR 0.6B | |
|---|---|---|
| 話し始めを知らせるまで (話し始めから) | 0.25〜0.27秒 | 0.25〜0.27秒 |
| 最初の文字まで (話し始めから) | 0.69〜1.32秒 | 0.50〜1.15秒 |
| 確定した文まで (話し終わりから) | 0.70〜0.79秒 | 0.72〜0.90秒 |
話し終わりから確定までのうち0.6秒は、0.5秒の無音が続くまで待つ時間です。silence_duration_msで短くできますが、そのぶん息つぎで発話が切れやすくなります。最初の文字が少し遅いのは、2回の読み直しが一致するのを待っているからです。
コマンドの--liveは、マイクから同じように書き起こします。マイクはminiaudioを実行ファイルに組み込んで読んでいるので、SDL2やPortAudioを入れなくても動きます。
ちなみにASISTはこの仕組みを使っていません。話し終わったかどうかを相槌の分類器やMaAIの話し終わりの予測も使って自分で決めているからです。ASISTでは自分で切った発話をspeech.cppのワーカーに渡しています。
ひとつにまとめてよかったこと
ここまで、音声合成と音声認識を別々に見てきましたが、ぜんぶが同じエンジンに入っていることにもいいことがあります。
まず、配るものが少なくて済みます。speech.cppは、実行ファイルspeechが1つと、モデルのファイルが1つあれば動きます。実行ファイルはMacの0.8.2で約6.7 MB、WindowsではVulkanのシェーダーを中に持つので48 MBです。モデルは、コーデックも含めて1つのGGUFのファイルにまとめました。Releasesには、macOS (Metal)、Windows (Vulkan)、Linux (VulkanとCPU) 向けのビルドを置いていて、インストーラーがPCに合うものを選んで入れます。CUDAもPythonも要りません。
起動してから話せるようになるまでも速いです。ASISTはマイクを入れたときだけ音声のモデルを読み込むので、ここが遅いとマイクを入れてもしばらく話せません。
M5で起動してから最初の要求を受け付けられるようになるまでを計測しました (モデルのファイルはOSのキャッシュに載っている状態です)。
| 実装 | 動かすのに要るもの | 起動してから準備ができるまで |
|---|---|---|
| speech.cpp | 実行ファイル1つ | 0.4秒 |
| mlx-audio | Python 3.12とMLX | 2.3〜3.1秒 |
| audio.cpp | サーバーの実行ファイル | 2.0〜3.8秒 |
| 公式の実装 | Python 3.10とPyTorch | 9.0〜11.0秒 |
どのモデルも、同じやり方で呼び出せます。
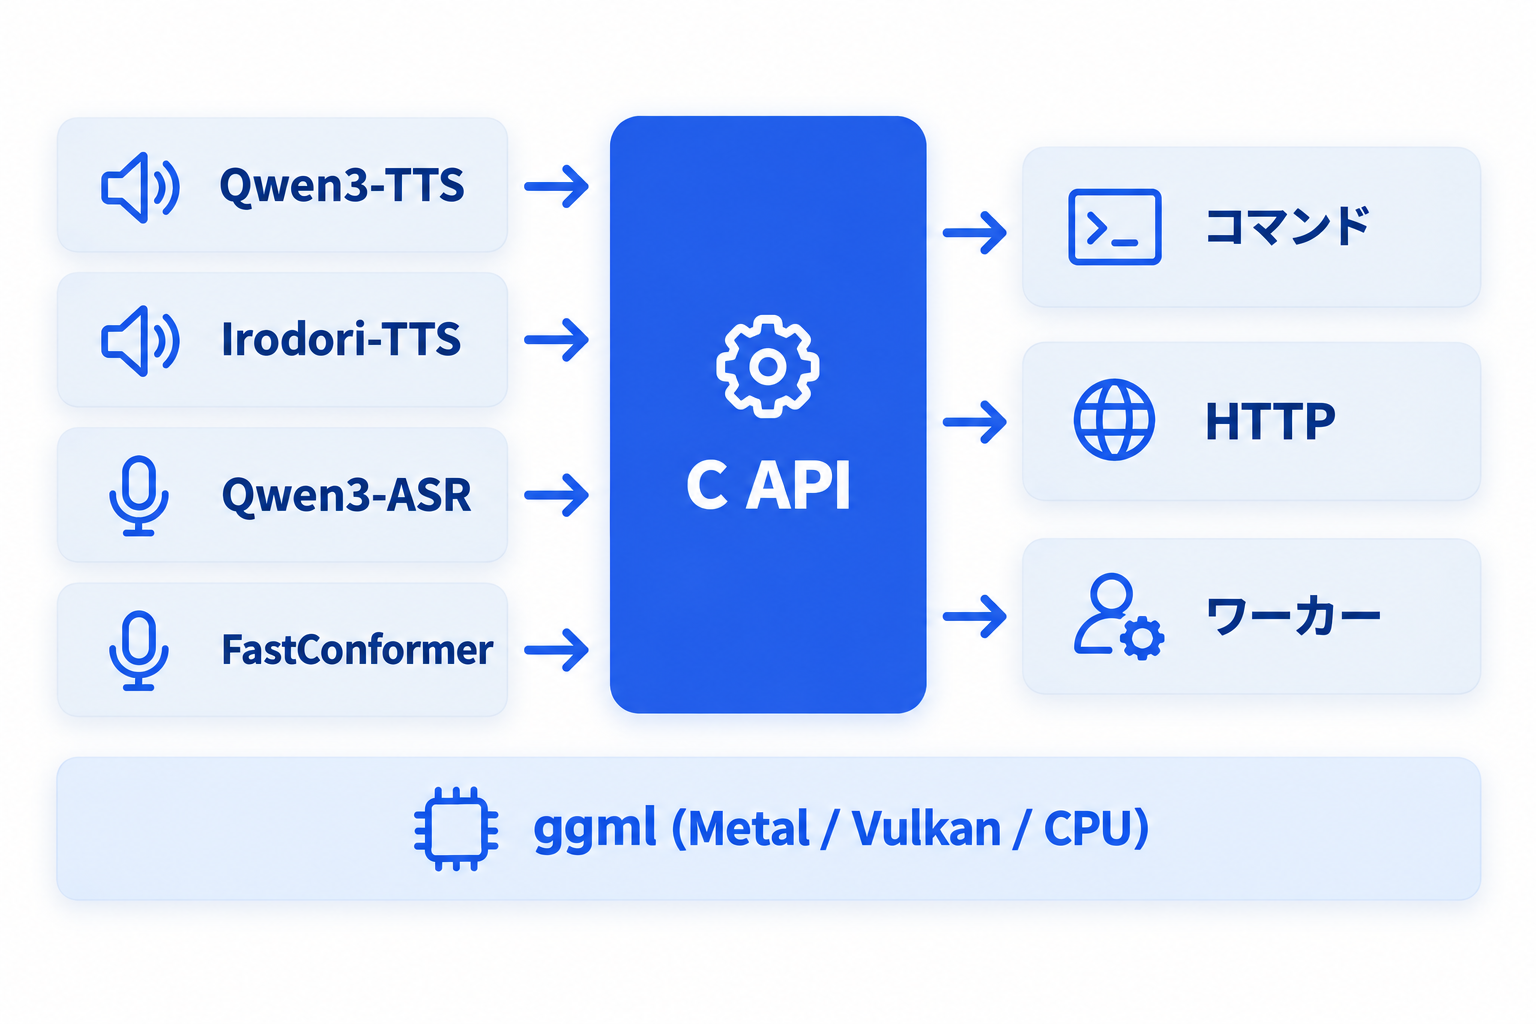
呼び出し方は4つあります。
speechコマンド: テキストを読むspeech tts、音声を書き起こすspeech asr、参照音声から声のファイルを作るspeech voiceなど- HTTPサーバー (
speech serve): OpenAIの音声のAPI (/v1/audio/speechと/v1/audio/transcriptions) と、Realtime APIの書き起こし (/v1/realtime) と同じ形で答える - ワーカー (
speech worker): 標準入出力でJSON Linesをやりとりする。ASISTはこれで動かしている - C API (
speech.h): 上の3つも、すべてこのC APIの上に作っている
ASISTは、読み上げも音声認識もspeech.cppのワーカーで動かすようになり、llama-serverを同梱するのをやめました。
まとめ
- 音声合成と音声認識の9つのモデルと音声区間検出のSilero VADを、ggmlで動くひとつのエンジンにまとめ、MacとWindowsとLinuxで実行ファイル1つで動くようにしました
- 公式の実装と段階ごとに比較して同じ結果を出すことを確かめながら、M5でIrodori-TTSの声が出るまでを0.25秒にし、RTX 2080ではQwen3-ASRをllama.cppより速くしました
- M5のtensor APIの不具合は、速さより正しさを取って、tensor APIを止めて避けました。FastConformerの速さはNeMo-Speech.cppにまだ負けているので、次に詰めます
- 長尺の録音はSilero VADの区間ごとに書き起こすことで文が落ちることが大きく減り、話しているそばからの書き起こしはOpenAIのRealtime APIと同じ形で使えるようになりました
Appendix
計測方法
実装どうしの比較には、自分で作っているspeech-benchを使いました。speech.cppは0.8.0の候補 (コミットf5ab84c) で、M5では手元のビルド、RTX 2080ではCIのビルドを使い、すべての実装を2026-10-08の同じ日に計測しています。
音声合成は、M5 (32 GB、macOS 26.2) と、RTX 2080 (8 GB、ドライバー591.86) のWindows 11で計測しました。テキストはspeech-benchのprompts/speak-ja-JP.jsonの20文で、相槌、返事、長めの説明、英単語まじりのテキストが入っています。Irodori-TTSの声はspeech-benchで作った約10秒の参照音声 (voice-bright-young-woman) で、seedは1です。Qwen3-TTSは用意された声のono_annaで、seedは毎回変わります。GPUを初めて使うときの時間を除くため、最初の1文は一度読ませてから計測しています。CERは、合成した音声をQwen3-ASR 1.7Bで書き起こして数えました。
ASISTの再生時間は、2026-10-09に公開版0.8.0 (同梱のspeech.cppは0.8.2) を同じM5で測りました。各モデルで1文をウォームアップしたあと、上と同じ20文を1回ずつ再生し、相槌とつなぎの一言は切っています。Qwen3-TTSの声はono_anna、Irodori-TTSはASISTに同梱するcalm-young-womanです。会話APIが指定どおりの文を返したことも全60文で確認しました。合成開始の時刻は、アプリが報告する合成時間を画面側で受け取った時刻から引いて推定しています。声の始まりは、再生する音声の20 msごとのRMSが0.004以上になる最初の区間としました。プロセス間通信の遅れが誤差に入り、機器の出力遅延は含めません。
途切れないかの確認は、speech.cppのワーカーに同じ20文を読ませて、チャンクが届いた時刻を記録して数えています。最初のチャンクが届いた時刻に再生を始めたとして、それぞれのチャンクが、その前までの音声を鳴らし終える時刻より前に届いていれば途切れません。
音声認識は、Common Voice 8.0の日本語のテスト (4,483文、参照の文字は93,471文字) を、M5とRTX 2080で、どの実装にも同じ順に聞かせました。音声の前後の無音は、silero-vad v4で声のある範囲を見つけて、前後に0.2秒ずつ残して詰めています (声が見つからなかった4文は除いています)。Qwen3-ASRには言語にjaを指定し、待ち時間には読み込みを含めていません。
M5での音声認識の結果です。
| モデル | 実装 | 重み | CER | 表記の揺れを許したCER | 待ち時間 (中央値) | 待ち時間 (p90) |
|---|---|---|---|---|---|---|
| Qwen3-ASR 1.7B | speech.cpp | Q8_0 | 9.49% | 4.67% | 0.309秒 | 0.544秒 |
| Qwen3-ASR 1.7B | llama.cpp b11246 | Q8_0 | 9.29% | 4.62% | 0.307秒 | 0.499秒 |
| Qwen3-ASR 0.6B | speech.cpp | Q8_0 | 11.89% | 7.05% | 0.132秒 | 0.231秒 |
| Qwen3-ASR 0.6B | llama.cpp b11246 | Q8_0 | 11.79% | 6.95% | 0.133秒 | 0.212秒 |
| parakeet-tdt_ctc-0.6b-ja | speech.cpp | F16 | 7.88% | 2.98% | 0.059秒 | 0.086秒 |
| parakeet-tdt_ctc-0.6b-ja | CrispASR v0.8.38 | Q8_0 | 8.03% | 3.12% | 0.071秒 | 0.088秒 |
| ReazonSpeech NeMo v2 | speech.cpp (ビームサーチ) | F16 | 12.03% | 7.13% | 0.110秒 | 0.167秒 |
| ReazonSpeech NeMo v2 | speech.cpp (greedy) | F16 | 12.50% | 7.69% | 0.077秒 | 0.104秒 |
| ReazonSpeech NeMo v2 | CrispASR v0.8.38 | Q8_0 | 11.79% | 6.88% | 0.074秒 | 0.097秒 |
| ReazonSpeech NeMo v2 | NeMo-Speech.cpp v0.2.0 (greedy) | F16 | 11.93% | 7.10% | 0.054秒 | 0.075秒 |
parakeet-tdt-0.6b-v3を、FLEURSの英語の300文で比べた結果です。
| 環境 | 実装 | 重み | WER | 待ち時間 (中央値) | 待ち時間 (p90) |
|---|---|---|---|---|---|
| M5 | speech.cpp | F16 | 8.76% | 0.103秒 | 0.167秒 |
| M5 | NeMo-Speech.cpp v0.2.0 | F16 | 9.06% | 0.085秒 | 0.134秒 |
| RTX 2080 | speech.cpp | F16 | 8.78% | 0.152秒 | 0.221秒 |
| RTX 2080 | NeMo-Speech.cpp v0.2.0 | F16 | 9.06% | 0.094秒 | 0.130秒 |
NeMo-Speech.cppには公開されたF16のファイルがないので、speech-benchがNeMo-Speech.cppの変換スクリプトでF16に変換したファイルを使っています。
長尺の録音の計測は、speech.cppのmeasure/region_cap_compare.pyでM5 (Metal) を使って行いました。FLEURSの日本語のテストの321文 (各文の読み1つ) と、Common Voice 8.0の日本語のテストの最初の600文の録音を、それぞれSilero VADで声のある範囲に切り、音量を-23 dBFSにそろえて、0.3〜1.0秒の間をあけてつないでいます。4つに1つの間は2〜8秒の無音にして、間と無音には-60 dBFSの雑音を入れました。こうして作った105.6分の録音を、言語を日本語に決めて書き起こし、NFKCで正規化して句読点と空白を除いたCERを数えています。区間の長さの上限ごとの結果はこちらです (FLEURS / Common Voice)。
| 上限 | ReazonSpeech CER | 落ちた文 | parakeet-ja CER | 落ちた文 | Qwen3-ASR 0.6B CER | 落ちた文 |
|---|---|---|---|---|---|---|
| 丸ごと | 25.29% / 86.01% | 67 / 522 | 83.39% / 44.87% | 264 / 266 | 9.80% / 14.48% | 1 / 1 |
| なし | 11.97% / 16.81% | 12 / 42 | 6.39% / 10.82% | 3 / 19 | 10.55% / 14.21% | 0 / 2 |
| 20秒 | 11.32% / 16.81% | 10 / 42 | 6.06% / 10.82% | 1 / 19 | 10.65% / 14.21% | 0 / 2 |
| 15秒 | 10.90% / 16.96% | 9 / 43 | 5.99% / 10.36% | 2 / 16 | 10.71% / 14.11% | 0 / 2 |
| 10秒 | 10.25% / 17.17% | 4 / 46 | 5.75% / 9.97% | 0 / 11 | 11.44% / 14.17% | 0 / 2 |
| 8秒 | 10.31% / 17.38% | 2 / 44 | 6.21% / 9.58% | 0 / 8 | 11.63% / 14.28% | 0 / 1 |
話しながらの書き起こしの時間は、ダンプを無音でつないだ音声を24 kHzにして、20ミリ秒ずつ実時間で/v1/realtimeに送って計りました。話し始めと話し終わりは、余白を除いた区間の端から数えています。
段階ごとの比較の結果
Irodori-TTSの各段階を、公式の実装の書き出した入力から動かしたときの結果です (Apple M5)。
| 処理 | CPU、F32 | Metal、F32 |
|---|---|---|
| テキストの正規化とトークナイザ (164文) | すべて一致 | すべて一致 |
| テキストの条件 | 118〜123 dB | 65〜123 dB |
| 話者の条件 | 111 dB | 51 dB |
| 長さの予測 | すべて一致 | すべて一致 |
| DiTの各ステップ | 95 dB以上 | 46 dB以上 |
| サンプラーの出力 (MF) | 86〜122 dB | 36〜67 dB |
| コーデックのデコード | 119 dB | 68 dB |
| ウィンドウに分けてデコードしたときと一度にデコードしたとき | 一致 | 一致 |
MetalがCPUより低いのは、ggmlのMetalの行列積が入力を半精度に丸めるからです。MFは4回の大きなステップで進むので、その差が潜在表現に残ります。そのためMetalでは、波形は同じにならず、同じ内容を話す音声になります。
FastConformer (parakeet-tdt_ctc-0.6b-ja) を、FLEURSの日本語の3つの発話 (6.36秒、10.50秒、25.50秒) で比較した結果です。
| 処理 | CPU、F32 | Metal |
|---|---|---|
| 特徴量 | 117〜127 dB | 同じ (CPUで計算) |
| 畳み込みでの間引き | 123 dB | 68〜70 dB |
| エンコーダーの出力 (24層のあと) | 114〜118 dB | 63〜64 dB |
| 公式のエンコーダーの出力からのトークン | 一致 | 一致 |
| 音声からの文 (すべての段階が移植したもの) | 3つとも一致 | 3つとも一致 |
GGUFの中身
speech.cppのモデルは、どれもコーデックまで含めた1つのGGUFのファイルです。モデルの名前や言語は、GGUFの仕様にある標準のキーにそのまま書いているので、GGUFを読めるツールならモデルの情報を表示できます。
| キー | 中身 |
|---|---|
general.architecture |
どのコードで動かすか (qwen3-tts、irodori-tts、fastconformer、qwen3-asr) |
general.name、general.organization、general.size_label など |
モデルの名前、公開している組織、パラメータの数 |
general.source.url |
変換したもとのリポジトリと、そのリビジョン |
general.languages |
話せる、または聞ける言語 (ISO 639のコード) |
speech.layout、speech.requires |
ファイルの形のバージョンと、それを読める最初のspeech.cppのバージョン |
speech.task、speech.sample_rate |
音声合成か音声認識か、音声のサンプリングレート |
読み込むときは、重みを読む前に、キーとテンソルの名前、形、型がすべてそろっているかを確かめ、足りないものや余計なものがあれば名前を出して断ります。speech infoを使うと、重みを読まずにこれらの情報だけを表示できます。
tensor APIの不具合の再現
ggmlのtest-backend-opsに、出力の列の数が64と192の行列積のケースを足して、M5で動かすと再現します。tensor APIでは結果がずれて失敗し、環境変数GGML_METAL_TENSOR_DISABLE=1でtensor APIを止めると通ります。くわしい手順はspeech.cpp#13に書いています。
References
- speech.cpp
- モデル
- OpenAI
- Paper
- Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow
- Mean Flows for One-step Generative Modeling
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- Fast Conformer with Linearly Scalable Attention for Efficient Speech Recognition
- Universals and cultural variation in turn-taking in conversation
- Lenient Evaluation of Japanese Speech Recognition: Modeling Naturally Occurring Spelling Inconsistency
- Towards Orthographically-Informed Evaluation of Speech Recognition Systems for Indian Languages
- HiKE: Hierarchical Evaluation Framework for Korean-English Code-Switching Speech Recognition
- The Hidden Cost of Digits: Number Normalization and WER in ASR Systems
- Echo-TTS
- Qwen3-TTS Technical Report
- ほかの実装
- Irodori-TTSを速くする記事
- ONNX Runtime