OpenAI Decisions APIで画像認識タスクがどこまでできるか様々な手法と比較してみた
by 逆瀬川ちゃん
22 min read
こんにちは!逆瀬川ちゃん (@gyakuse) です!
今日は2026年10月6日にbetaとして公開されたOpenAI Decisions APIについて、画像認識タスクでどのくらいの精度が出るのかを、昔ながらの画像モデルの学習やResponses API、Coding Agentと比べながら見ていきたいと思います。
Decisions APIは「この画像に傷はある?」「この書類はどの種類?」といった質問を投げると、答えを文章ではなく確率で返してくれるAPIです。OpenAIはResponses APIの約10倍速いと案内していて、分類やルーティングの用途を想定しています。
分類のAPIと聞くと、画像認識にそのまま使えそうに見えます。ただ、画像認識には教師データで学習した専用モデルという強い競合がいます。そこで今回は、画像分類、マルチラベル分類、行動予測、異常検知という性質の違う5つのタスクを用意して、6つの手法を同じテストセットで比べました。
OpenAI Decisions APIについて
まずはDecisions APIがどういうものかを見ていきます。
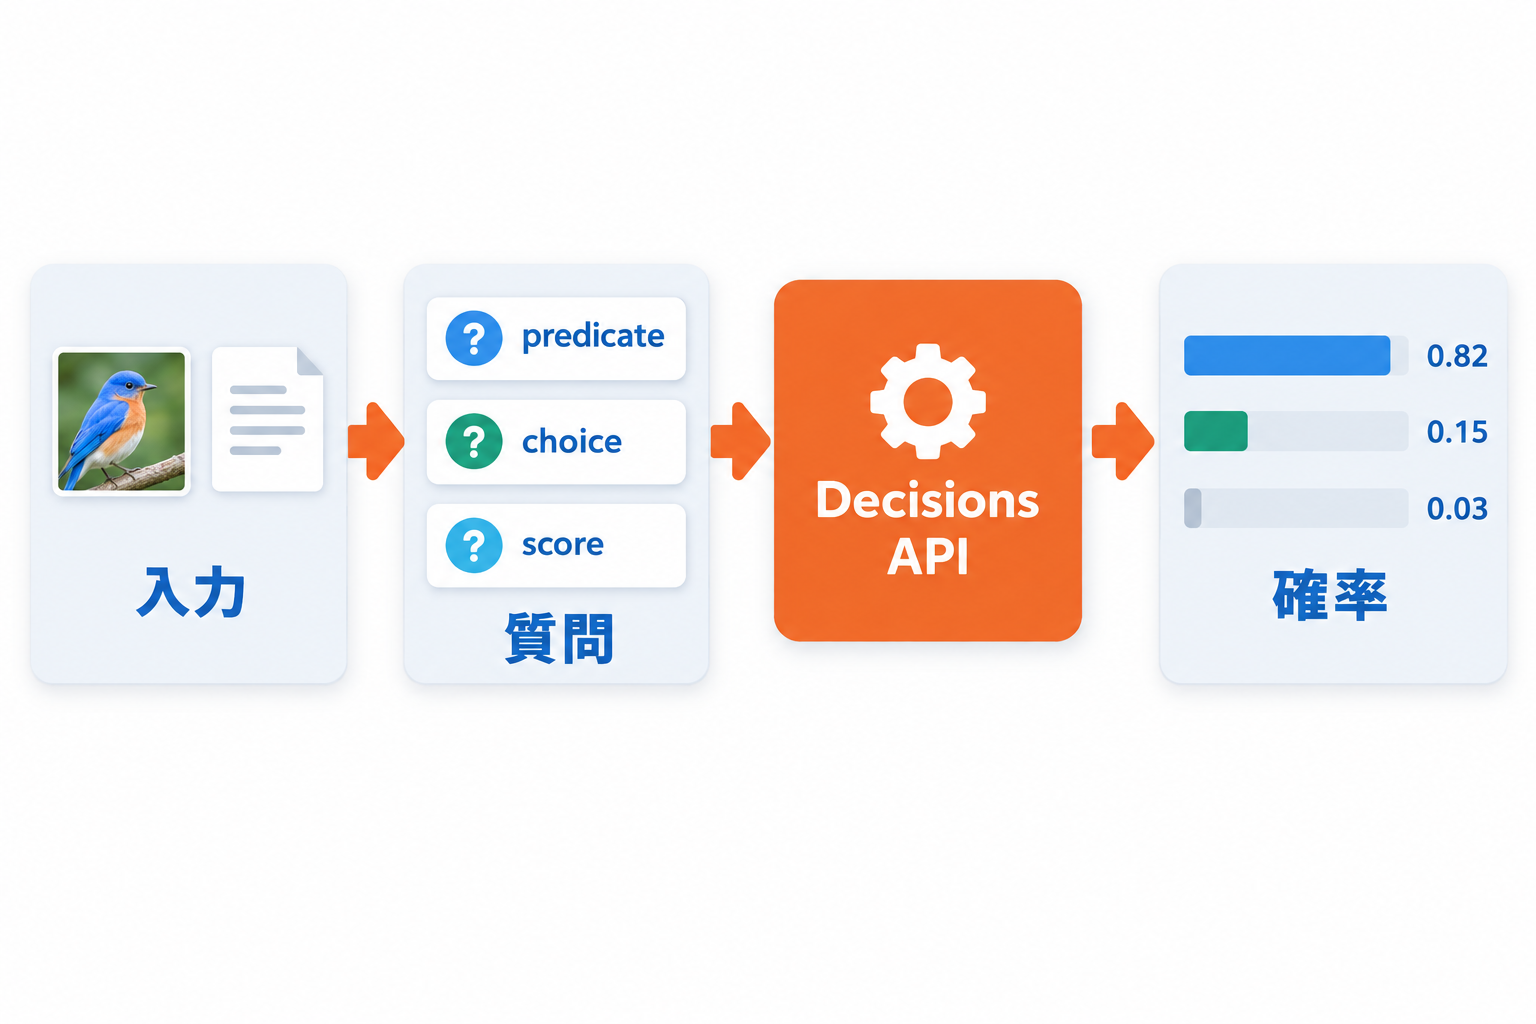
Decisions APIには、判定対象(テキスト、画像、またはその両方)と、質問のリストを渡します。質問ごとに判定基準を instructions として自然言語で書いておくと、モデルがそれぞれの答えを確率として返します。エンドポイントは POST /v1/decisions で、対応モデルは今のところ gpt-6-luna だけです。
質問には3つの型があります。
| 型 | 指定するもの | 返ってくるもの | 例 |
|---|---|---|---|
predicate |
instructions だけ |
条件がtrueである確率 probability |
「商品に傷がある」 |
choice |
2〜255個の候補 | 選ばれた候補 choice、各候補の確率 probabilities、confidence |
「書類は16種類のどれか」 |
score |
低い順に並べた levels |
levelの番号を確率で重み付けした平均 score、各levelの確率 |
「不具合の深刻度は3段階のどれか」 |
同じ入力に対する独立した質問は、1つのリクエストにまとめて投げられます。たとえば「傷があるか」と「商品カテゴリは何か」を一度に聞けます。
レスポンスは次のような形です。今回の実験で鳥の種類を200候補から選ばせたときの実際の出力を、途中を省略して載せています。
{
"model": "gpt-6-luna",
"answers": [
{
"type": "choice",
"name": "species",
"choice": "186",
"probabilities": [
{"value": "0", "probability": 0.02},
{"value": "1", "probability": 0.01},
...
{"value": "186", "probability": 0.38},
...
],
"confidence": 0.38
}
],
"usage": {"input_tokens": 2346, "output_tokens": 0, ...}
}
output_tokens が0になっているところが特徴的です。Decisions APIは文章を生成せず、候補への確率だけを返します。
Responses APIと何が違うのか
固定の候補から1つ選ばせるだけなら、Responses APIのStructured Outputsでも作れます。enum を使ったJSON Schemaを渡せば、候補以外の値は返ってきません。では何が違うのかというと、処理の流れが違います。
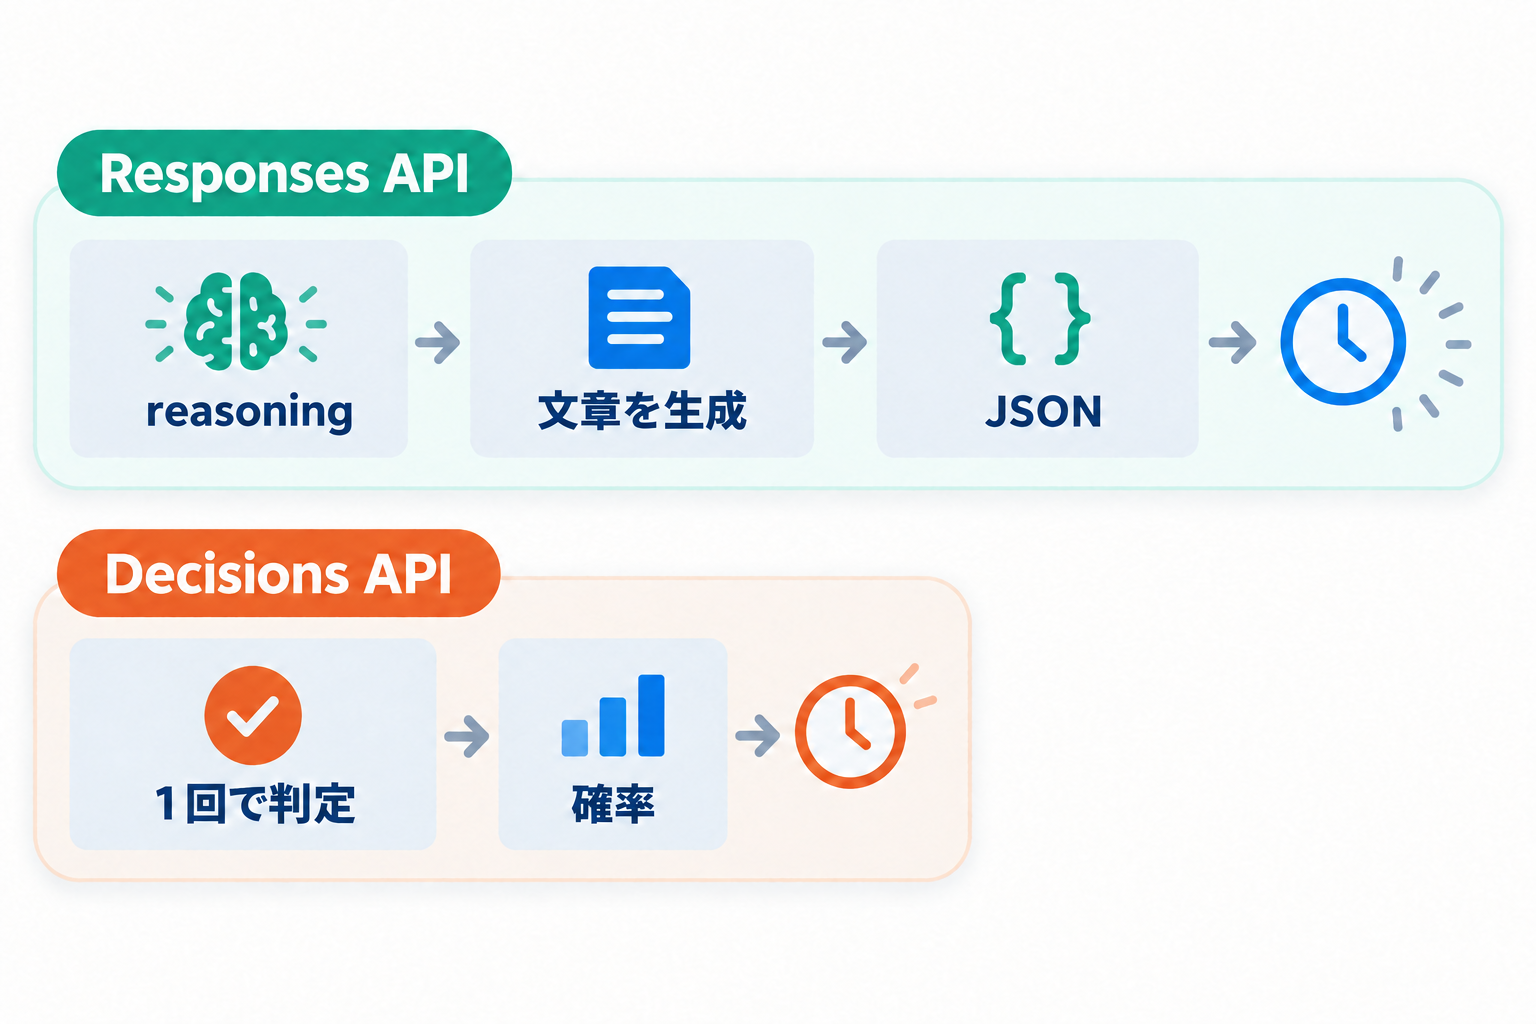
Responses APIは、reasoningをしてから、文章(JSON)をtokenごとに生成して返します。reasoning effortを上げれば考える量が増えますが、そのぶん時間がかかります。Decisions APIは1回の判定で候補ごとの確率を返すので、レイテンシが短くなります。
もう1つの違いは、確率の性質です。Responses APIに「confidenceを0〜1で書いて」と頼むと数値は返ってきますが、それはモデルが文章として書いた数値です。Decisions APIの確率は候補全体に対する分布として返ってくるので、閾値を決めたり、Top-5を取り出したりする処理にそのまま使えます。この確率がどこまで信用できるかは、後半で確かめます。
料金
料金もResponses APIとは計算の仕方が違います。同じ gpt-6-luna でも、Decisions APIは入力tokenだけに課金します。
| 課金対象 | Decisions API | Responses API(gpt-6-luna) |
|---|---|---|
| 入力 | $0.10 / 1M token | $0.10 / 1M token |
| キャッシュ読み取り | 追加課金なし | $0.01 / 1M token |
| キャッシュ書き込み | 追加課金なし | $0.125 / 1M token |
| 出力 | 課金なし | $0.50 / 1M token |
入力の単価は同じなので、短いJSONを返させるだけならResponses APIとの差は大きくありません。Responses APIでreasoning tokenや長い出力が発生すると、そのぶん高くなります。逆に、Decisions APIでも質問や候補の説明が長ければ入力tokenが増えるので、常に安いわけではありません。
どういうタスクに向いているか
さて、仕組みが分かったところで、Decisions APIが向いているタスクを考えてみます。公式ガイドでは、分類、ルーティング、優先度付けが例に挙がっています。また、音声で操作するアプリで、Live APIが会話を受け持ち、Decisions APIが「次のスライドへ進む」「何もしない」といった操作を選ぶ構成も紹介されています。
これらに共通するのは、次の3つの性質です。
- 答えが固定の候補か、true/falseか、levelのどれかに収まる
- 毎回すばやく答えが欲しい
- 答えの確からしさを数値として後段の処理で使いたい
逆に、任意のスキーマのJSONで情報を抽出したり、説明文を書かせたり、引数つきでツールを呼ばせたりする場合は、Responses APIのStructured Outputsやfunction callingを使うように公式ガイドでも案内されています。
画像認識の多くは、この「答えが固定の候補に収まる」形で書けます。ただし中身はいろいろで、200種類の鳥を羽の模様で見分ける問題と、人が自転車に乗っているかを判定する問題では、必要な能力がかなり違います。どういう画像認識タスクならDecisions APIで足りるのかを調べるのが、この記事の後半の目的です。
使い方・速度・費用
その前に、実際の呼び出し方と、今回の実験で測った速度と費用を見ておきます。
使い方
Python SDKでは3.26.0以降で client.decisions.create(...) が使えます。今回の実験コードでは、SDKの汎用の client.post でリクエストを送りました。以下は人と物の関係を判定するHICOタスクで、20個の行動を predicate として1リクエストで聞いた部分です。
messages = [{
"role": "user",
"content": [
{"type": "input_text", "text": task},
{"type": "input_image",
"image_url": "data:image/png;base64," + b64,
"detail": "high"},
],
}]
questions = [
{
"type": "predicate",
"name": f"label_{k}",
"instructions": f"Does the image show {v}? Judge each interaction "
"independently. A person and object merely "
"co-occurring is insufficient.",
}
for k, v in classes.items() # 例: "a person riding a bicycle"
]
result = client.post(
"/decisions",
cast_to=dict,
body={"model": "gpt-6-luna", "input": messages, "questions": questions},
)
scores = [a["probability"] for a in result["answers"]]
200種類の鳥の分類では、choice 型の質問を1つ作り、候補に200種の種名を並べました。
questions = [{
"type": "choice",
"name": "species",
"instructions": task,
"choices": [{"value": k, "description": v} for k, v in classes.items()],
}]
画像は input_image にbase64のdata URLとして渡しています。1リクエストに入れられる画像は最大128枚です。
速度
今回の5タスクで測った1件あたりのレイテンシの分布です。
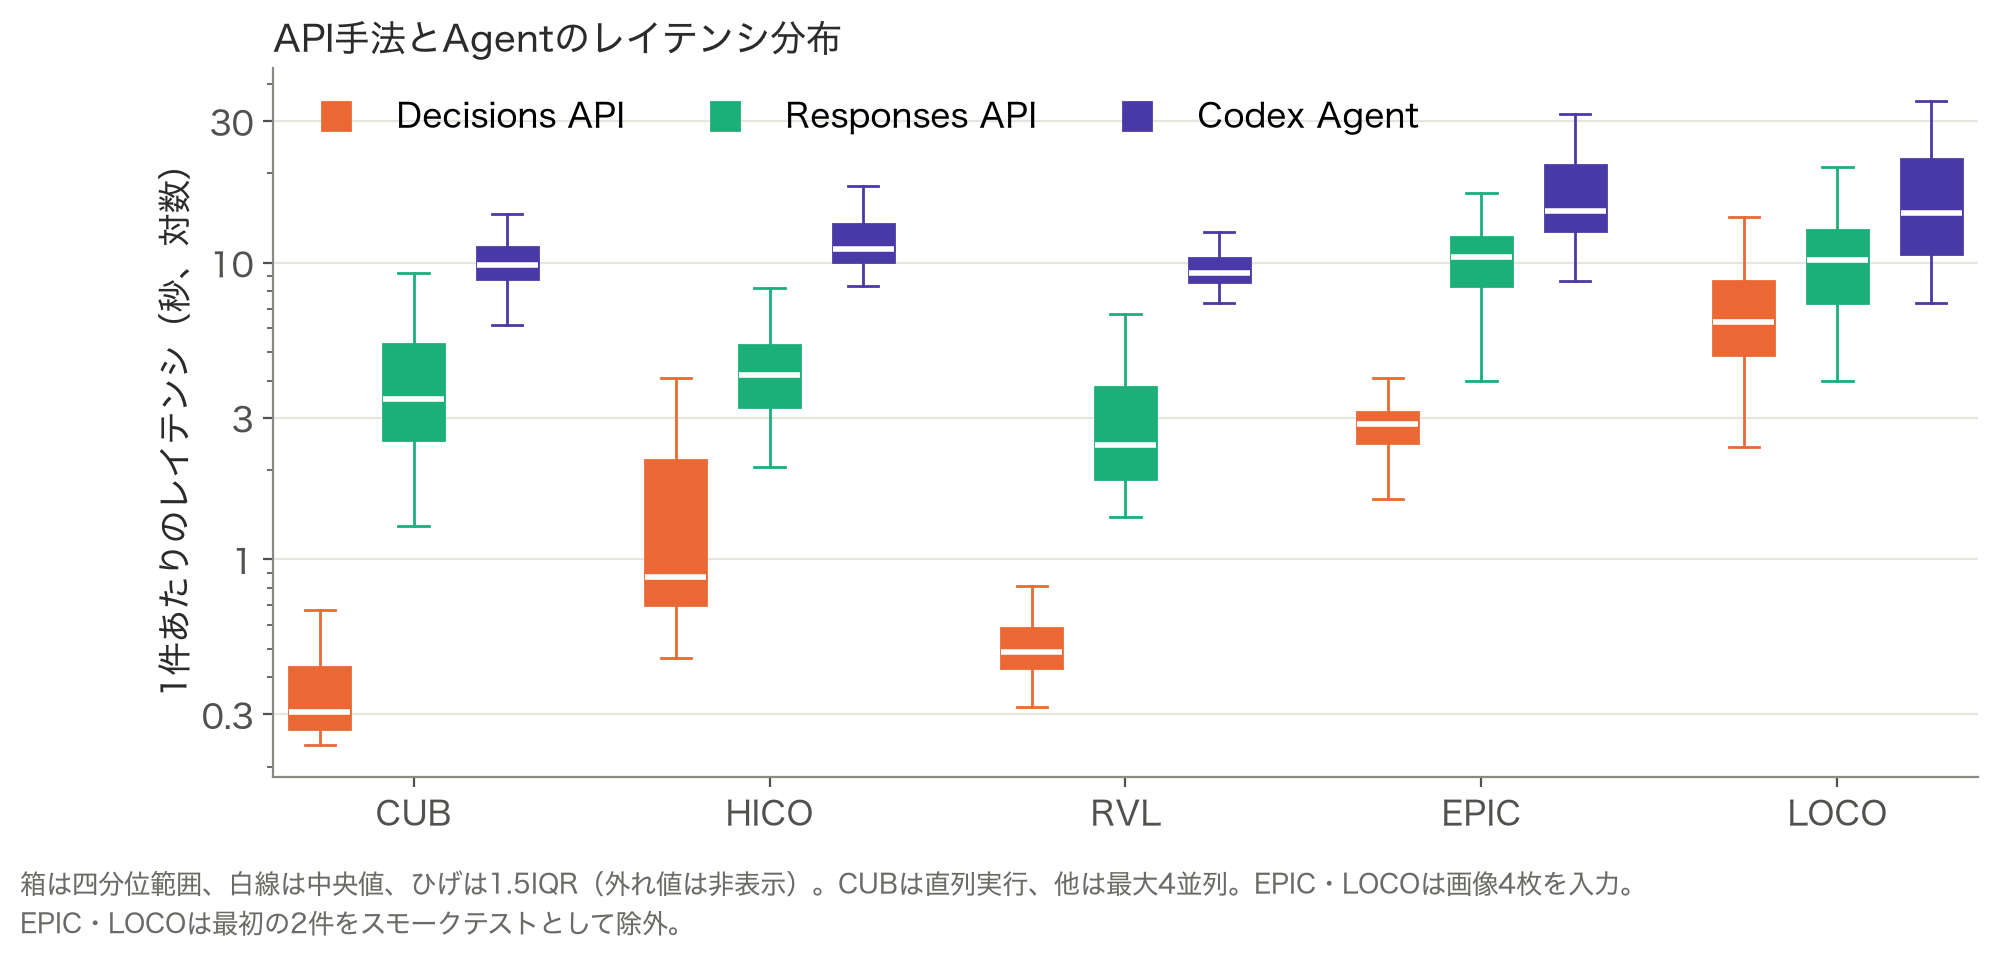
| タスク | 入力画像 | Decisions | Responses(medium) | Codex Agent | Responses / Decisions |
|---|---|---|---|---|---|
| CUB | 1枚 | 0.31秒 | 3.47秒 | 9.85秒 | 11.4倍 |
| HICO | 1枚 | 0.87秒 | 4.17秒 | 11.12秒 | 4.8倍 |
| RVL-CDIP | 1枚 | 0.49秒 | 2.42秒 | 9.27秒 | 5.0倍 |
| EPIC | 4枚 | 2.85秒 | 10.43秒 | 14.94秒 | 3.7倍 |
| MVTec LOCO | 4枚 | 6.29秒 | 10.23秒 | 14.66秒 | 1.6倍 |
数値は中央値です。画像1枚のタスクでは、Decisions APIは0.3〜0.9秒で返り、Responses APIより約5〜11倍速くなりました。ただし画像を4枚渡すEPICとLOCOでは3〜6秒かかり、差も小さくなっています。Responses APIのreasoning effortは medium です。
費用
次は1,000件あたりのAPI料金と、1リクエストの入力token数です。
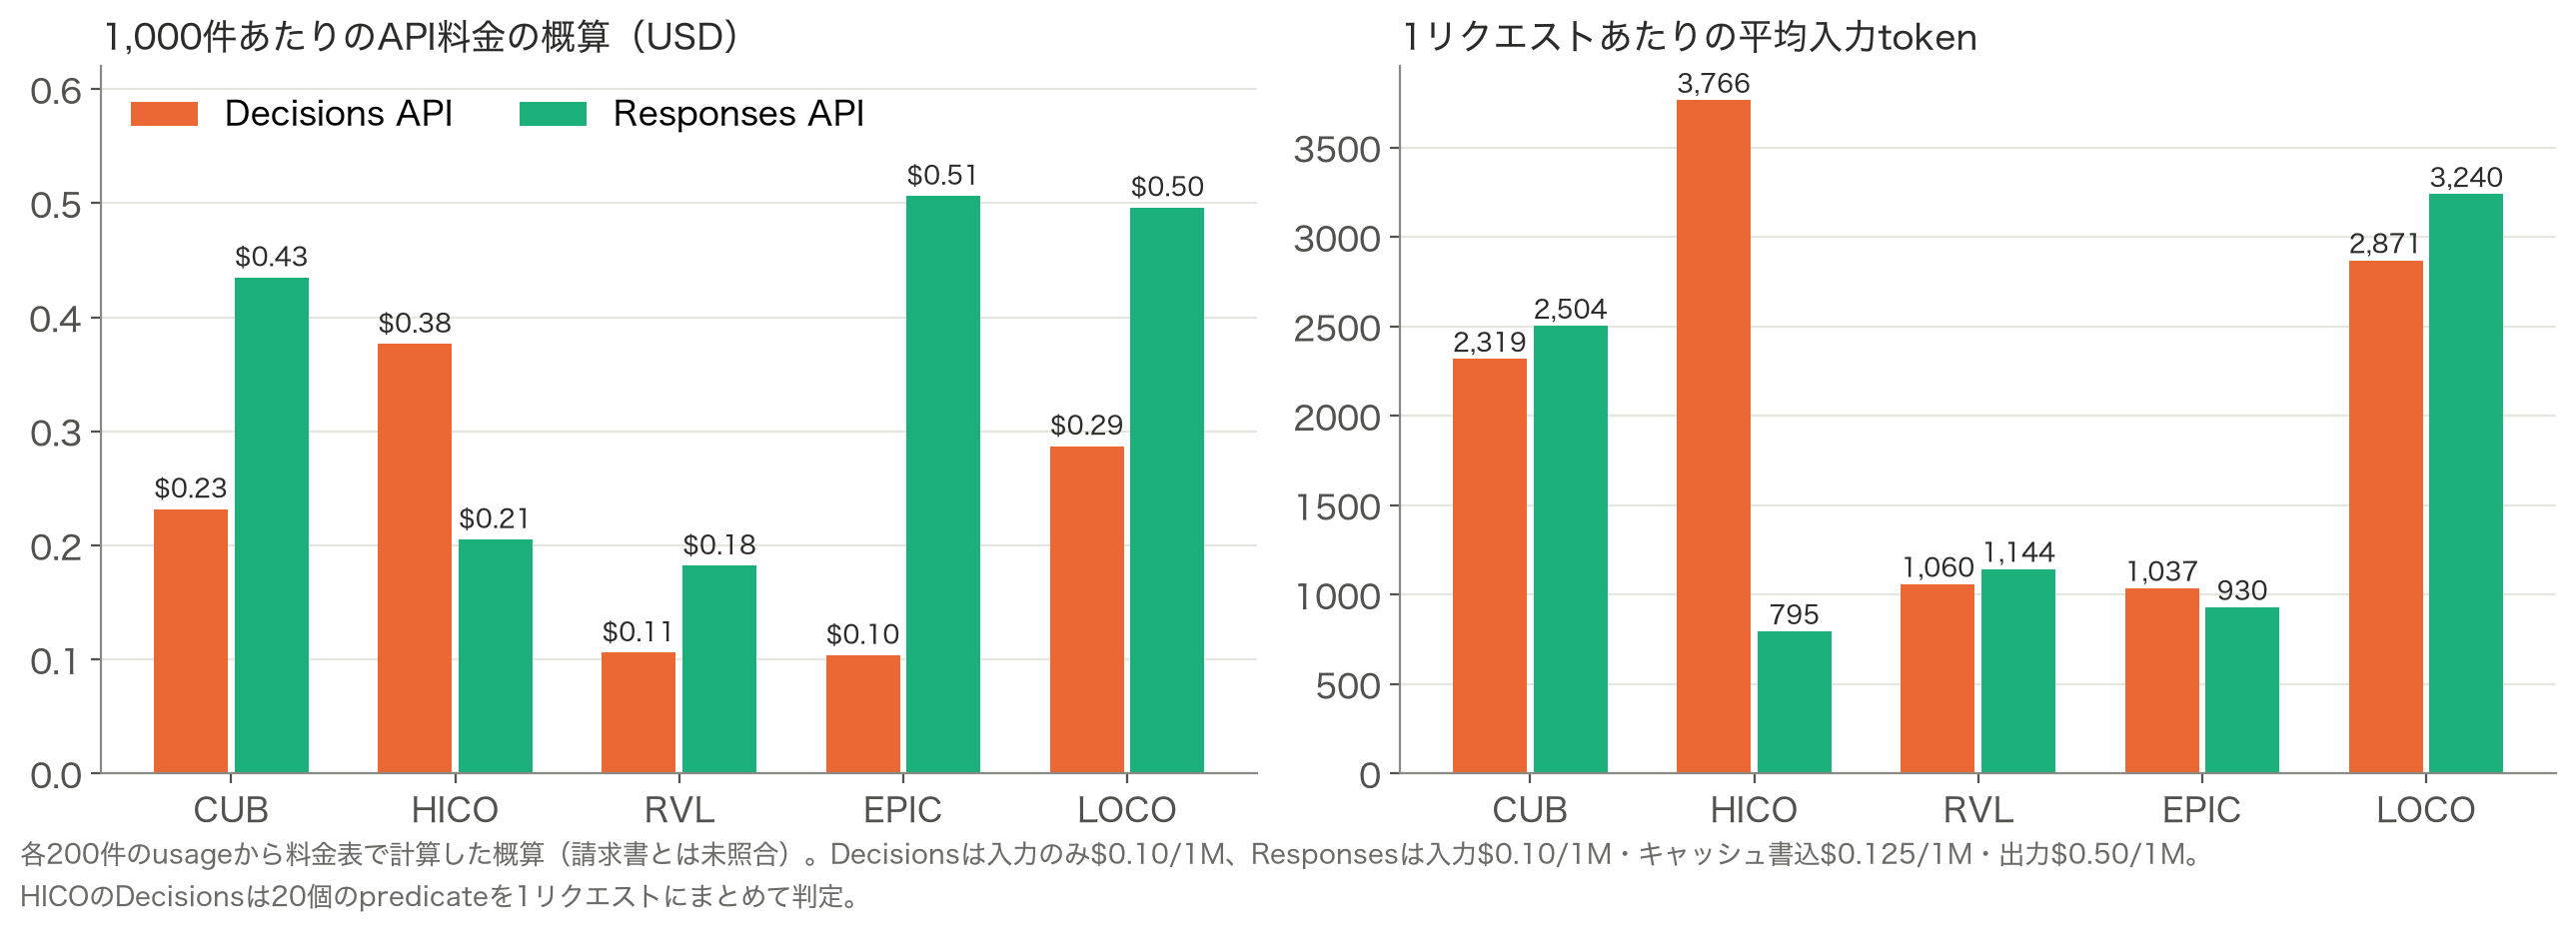
料金は usage から計算した概算で、5タスク×200件を両方のAPIで回しても合計約$0.59でした。
どちらが安いかはタスクによって逆転しました。
- HICO:Decisions APIが高い
- 20個の
instructionsがすべて入力tokenになる - 入力tokenはResponses APIの約4.7倍
- 20個の
- EPIC・LOCO:Responses APIが約1.7〜4.9倍高い
- reasoning tokenが出力として課金される
整理すると、Decisions APIの費用は質問の設計で決まり、Responses APIの費用はreasoningの量で決まります。
画像認識タスクで比較してみる
ここからが本題です。Decisions APIが画像認識でどこまで使えるかを、5つのタスクで調べました。
5つのタスク
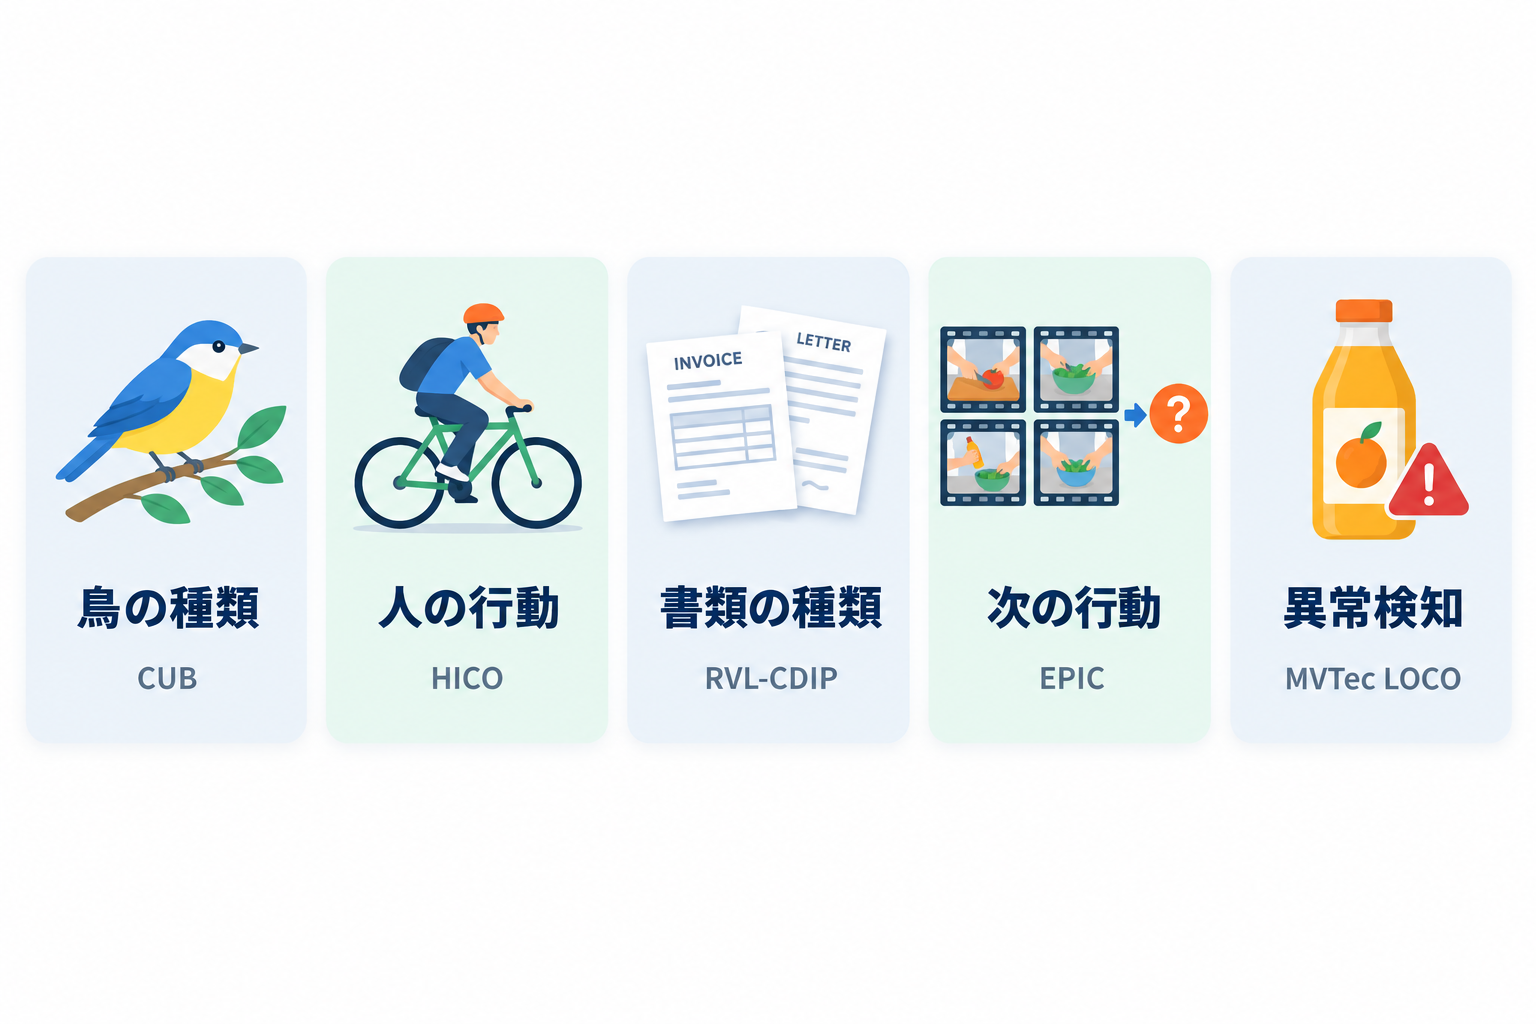
| タスク | 種類 | 問題 | train/val/test | 評価指標 |
|---|---|---|---|---|
| CUB-200-2011 | 画像分類 | 鳥の画像から200種のどれかを当てるfine-grained分類 | 2,000/1,000/200 | Top-1 accuracy |
| HICO | マルチラベル分類 | 人と物の関係から20種類の行動を複数ラベルで判定する | 389/195/200 | macro F1 |
| RVL-CDIP Mini | 画像分類 | 書類画像を16種類に分類する | 160/80/200 | accuracy |
| EPIC-KITCHENS-100 | 行動予測 | 過去4フレームから次の行動を20候補から予測する(action anticipation) | 400/100/200 | Top-1 accuracy |
| MVTec LOCO AD | 異常検知 | 正常例を基準に、傷などの構造的異常や、個数・配置の論理的異常を見つける | 正常300/正常100/200 | カテゴリ平均AUROC |
必要な能力がなるべくばらけるように選びました。どのタスクもテストセットは200件なので、95% CIも合わせて見ていきます。
6つの手法
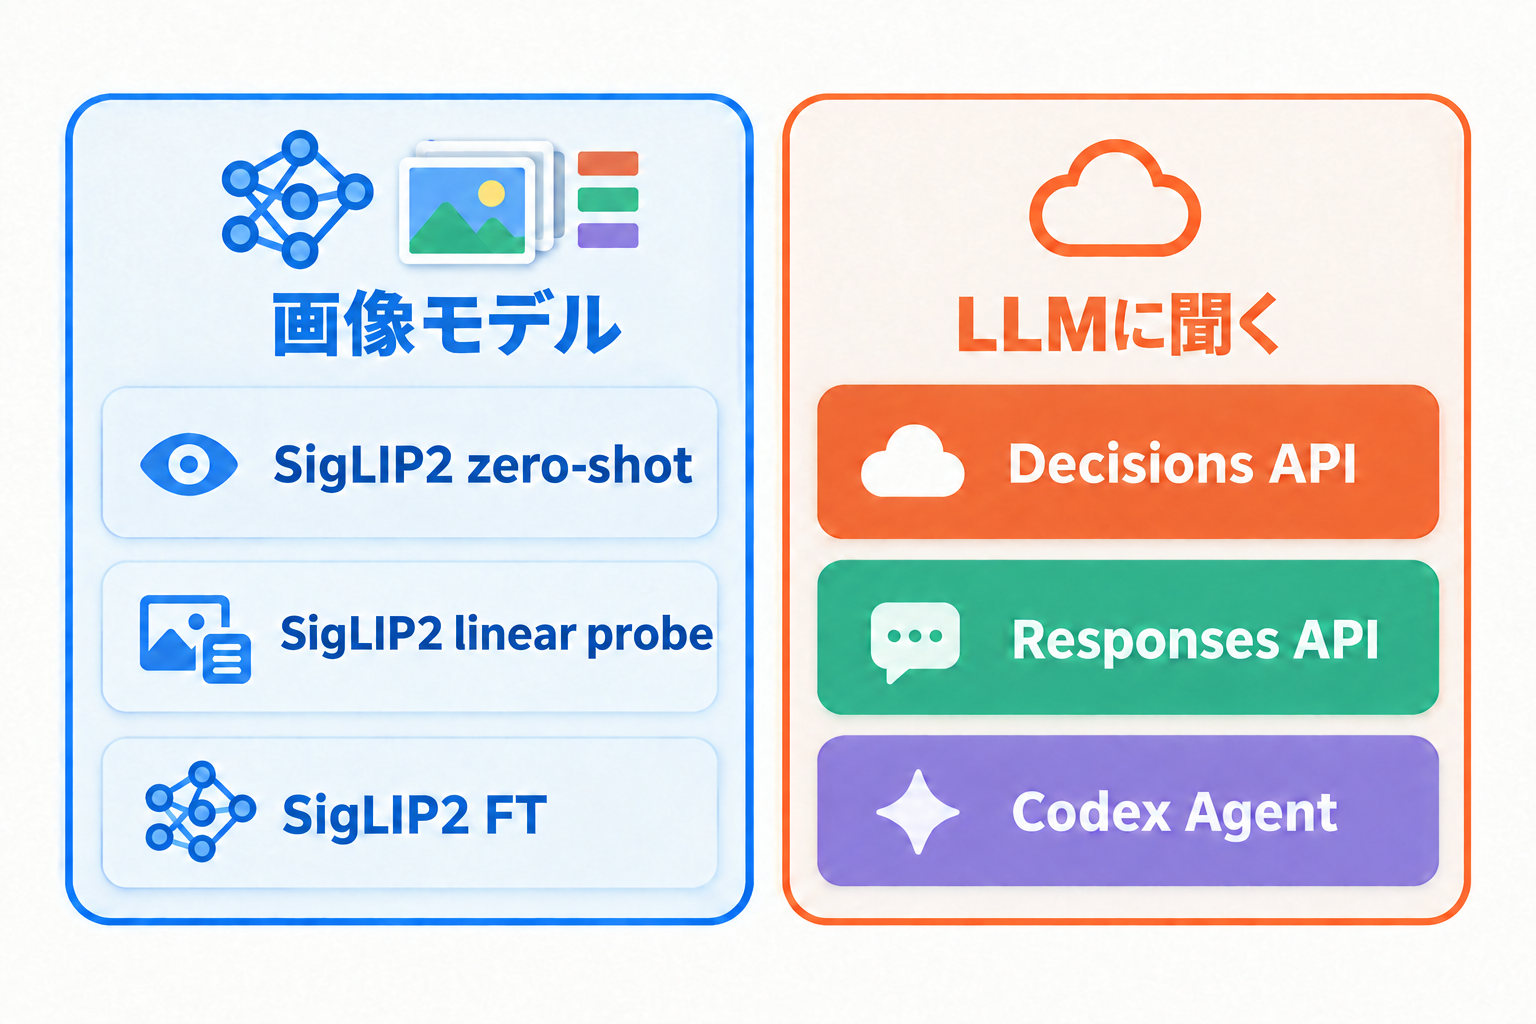
| 手法 | 内容 |
|---|---|
| SigLIP2 zero-shot | 画像と候補のテキストプロンプトの類似度で分類します。対象タスクのラベルでは学習していません |
| SigLIP2 linear probe | 画像エンコーダをfreezeし、embeddingの上で線形分類器(ロジスティック回帰)を学習します |
| SigLIP2 FT | 画像エンコーダと分類ヘッドを3 epochs学習します |
| Decisions API | choice または predicate で確率を取得します |
| Responses API | 画像と候補を渡し、Structured Outputsで分類結果を取得します(reasoning effort medium) |
| Codex Agent | codex exec に画像を渡し、cropやresizeをしながら判定させます(reasoning effort medium) |
画像モデルには google/siglip2-base-patch16-256 を使い、APIとAgentには gpt-6-luna を使いました。APIとAgentには学習データを渡さず、候補の名前とプロンプトだけを渡しています。つまり、SigLIP2のlinear probeとFTは教師データを使い、zero-shot、API、Agentは使わないという条件の違いがあります。
LOCOだけは異常画像で学習できないので、linear probeを「正常例とのkNN距離」に、FTを「正常画像だけで学習するteacher-student方式」に置き換えました。APIとAgentには、正常例3枚と判定対象1枚を渡しています。
全体の結果
5タスク×6手法の結果を並べると次のようになりました。
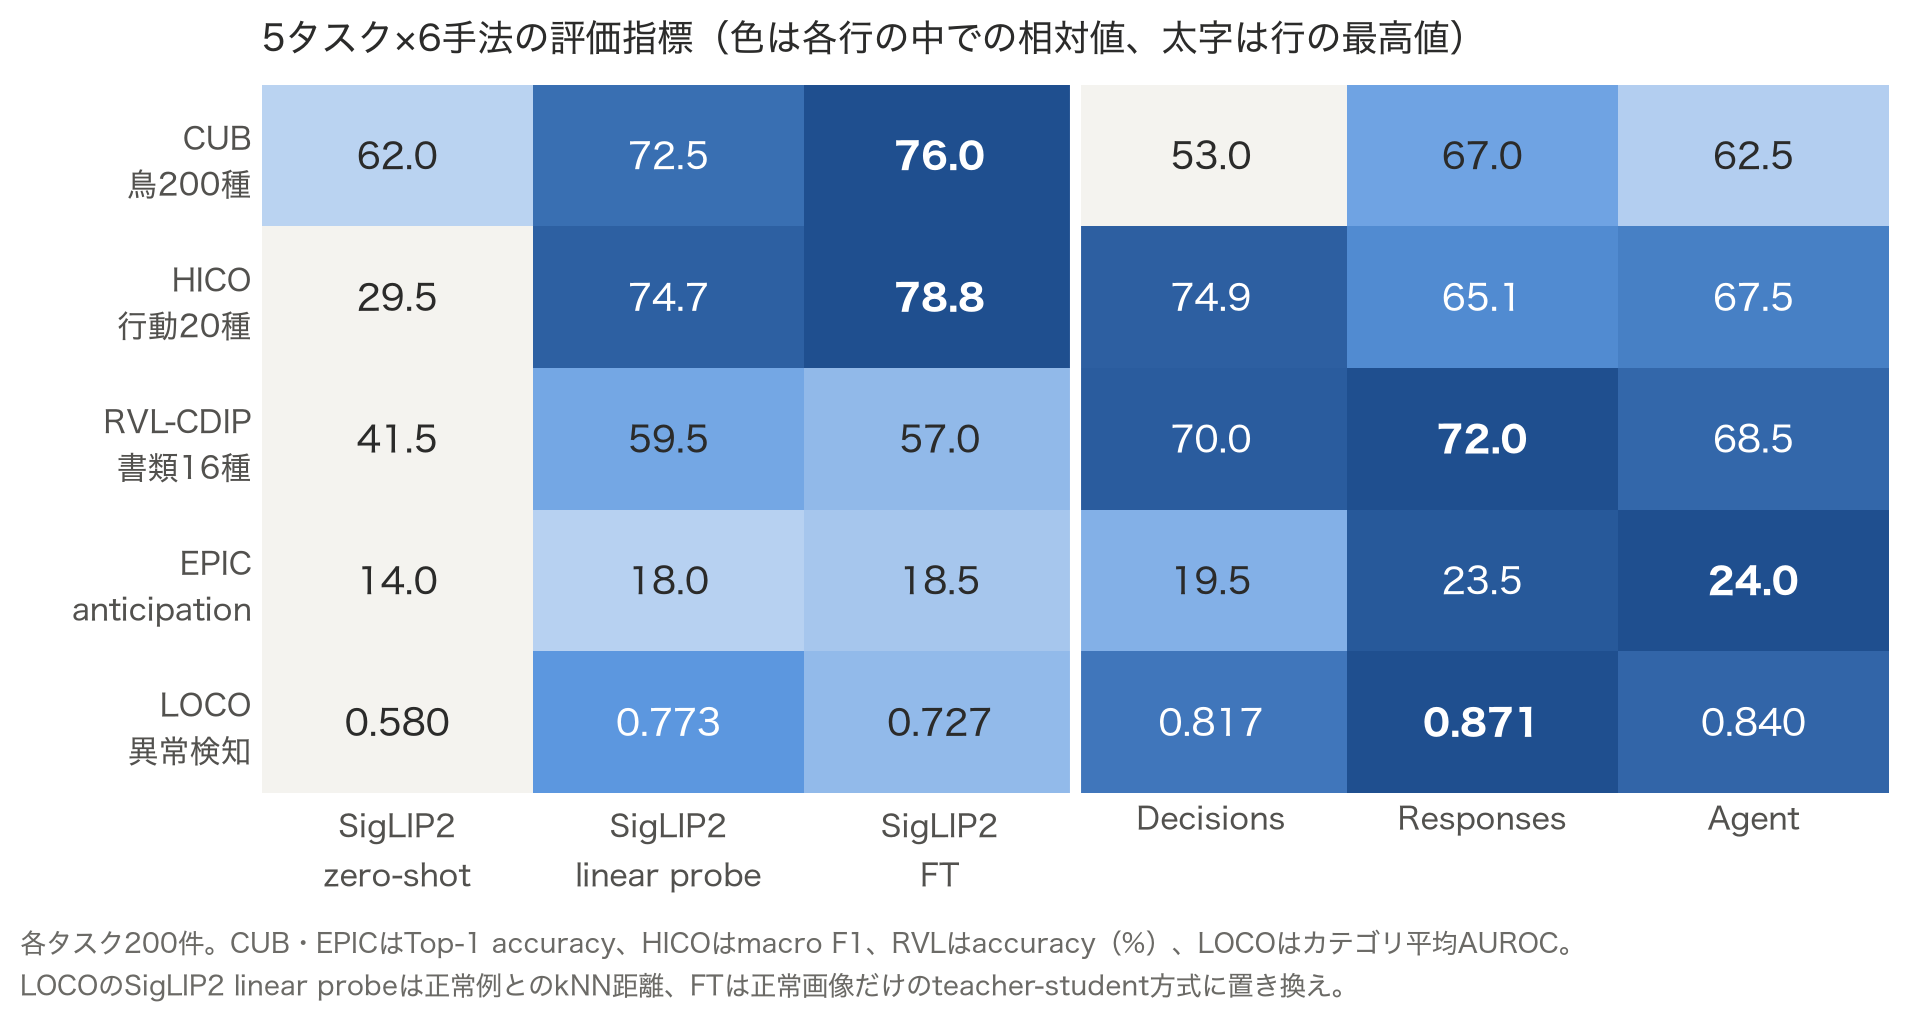
一番良い手法がタスクごとにばらばらです。CUBとHICOでは学習したSigLIP2が、RVL-CDIPとLOCOではResponses APIが、EPICではAgentが最高値でした。Decisions APIはどのタスクでも1位にはなっていませんが、HICOとRVL-CDIPでは1位との差が小さく、CUBでは最下位でした。
ただ、200件の評価では点推定の差がどこまで意味を持つかが問題になります。95%信頼区間(CI)を付けて見てみます。
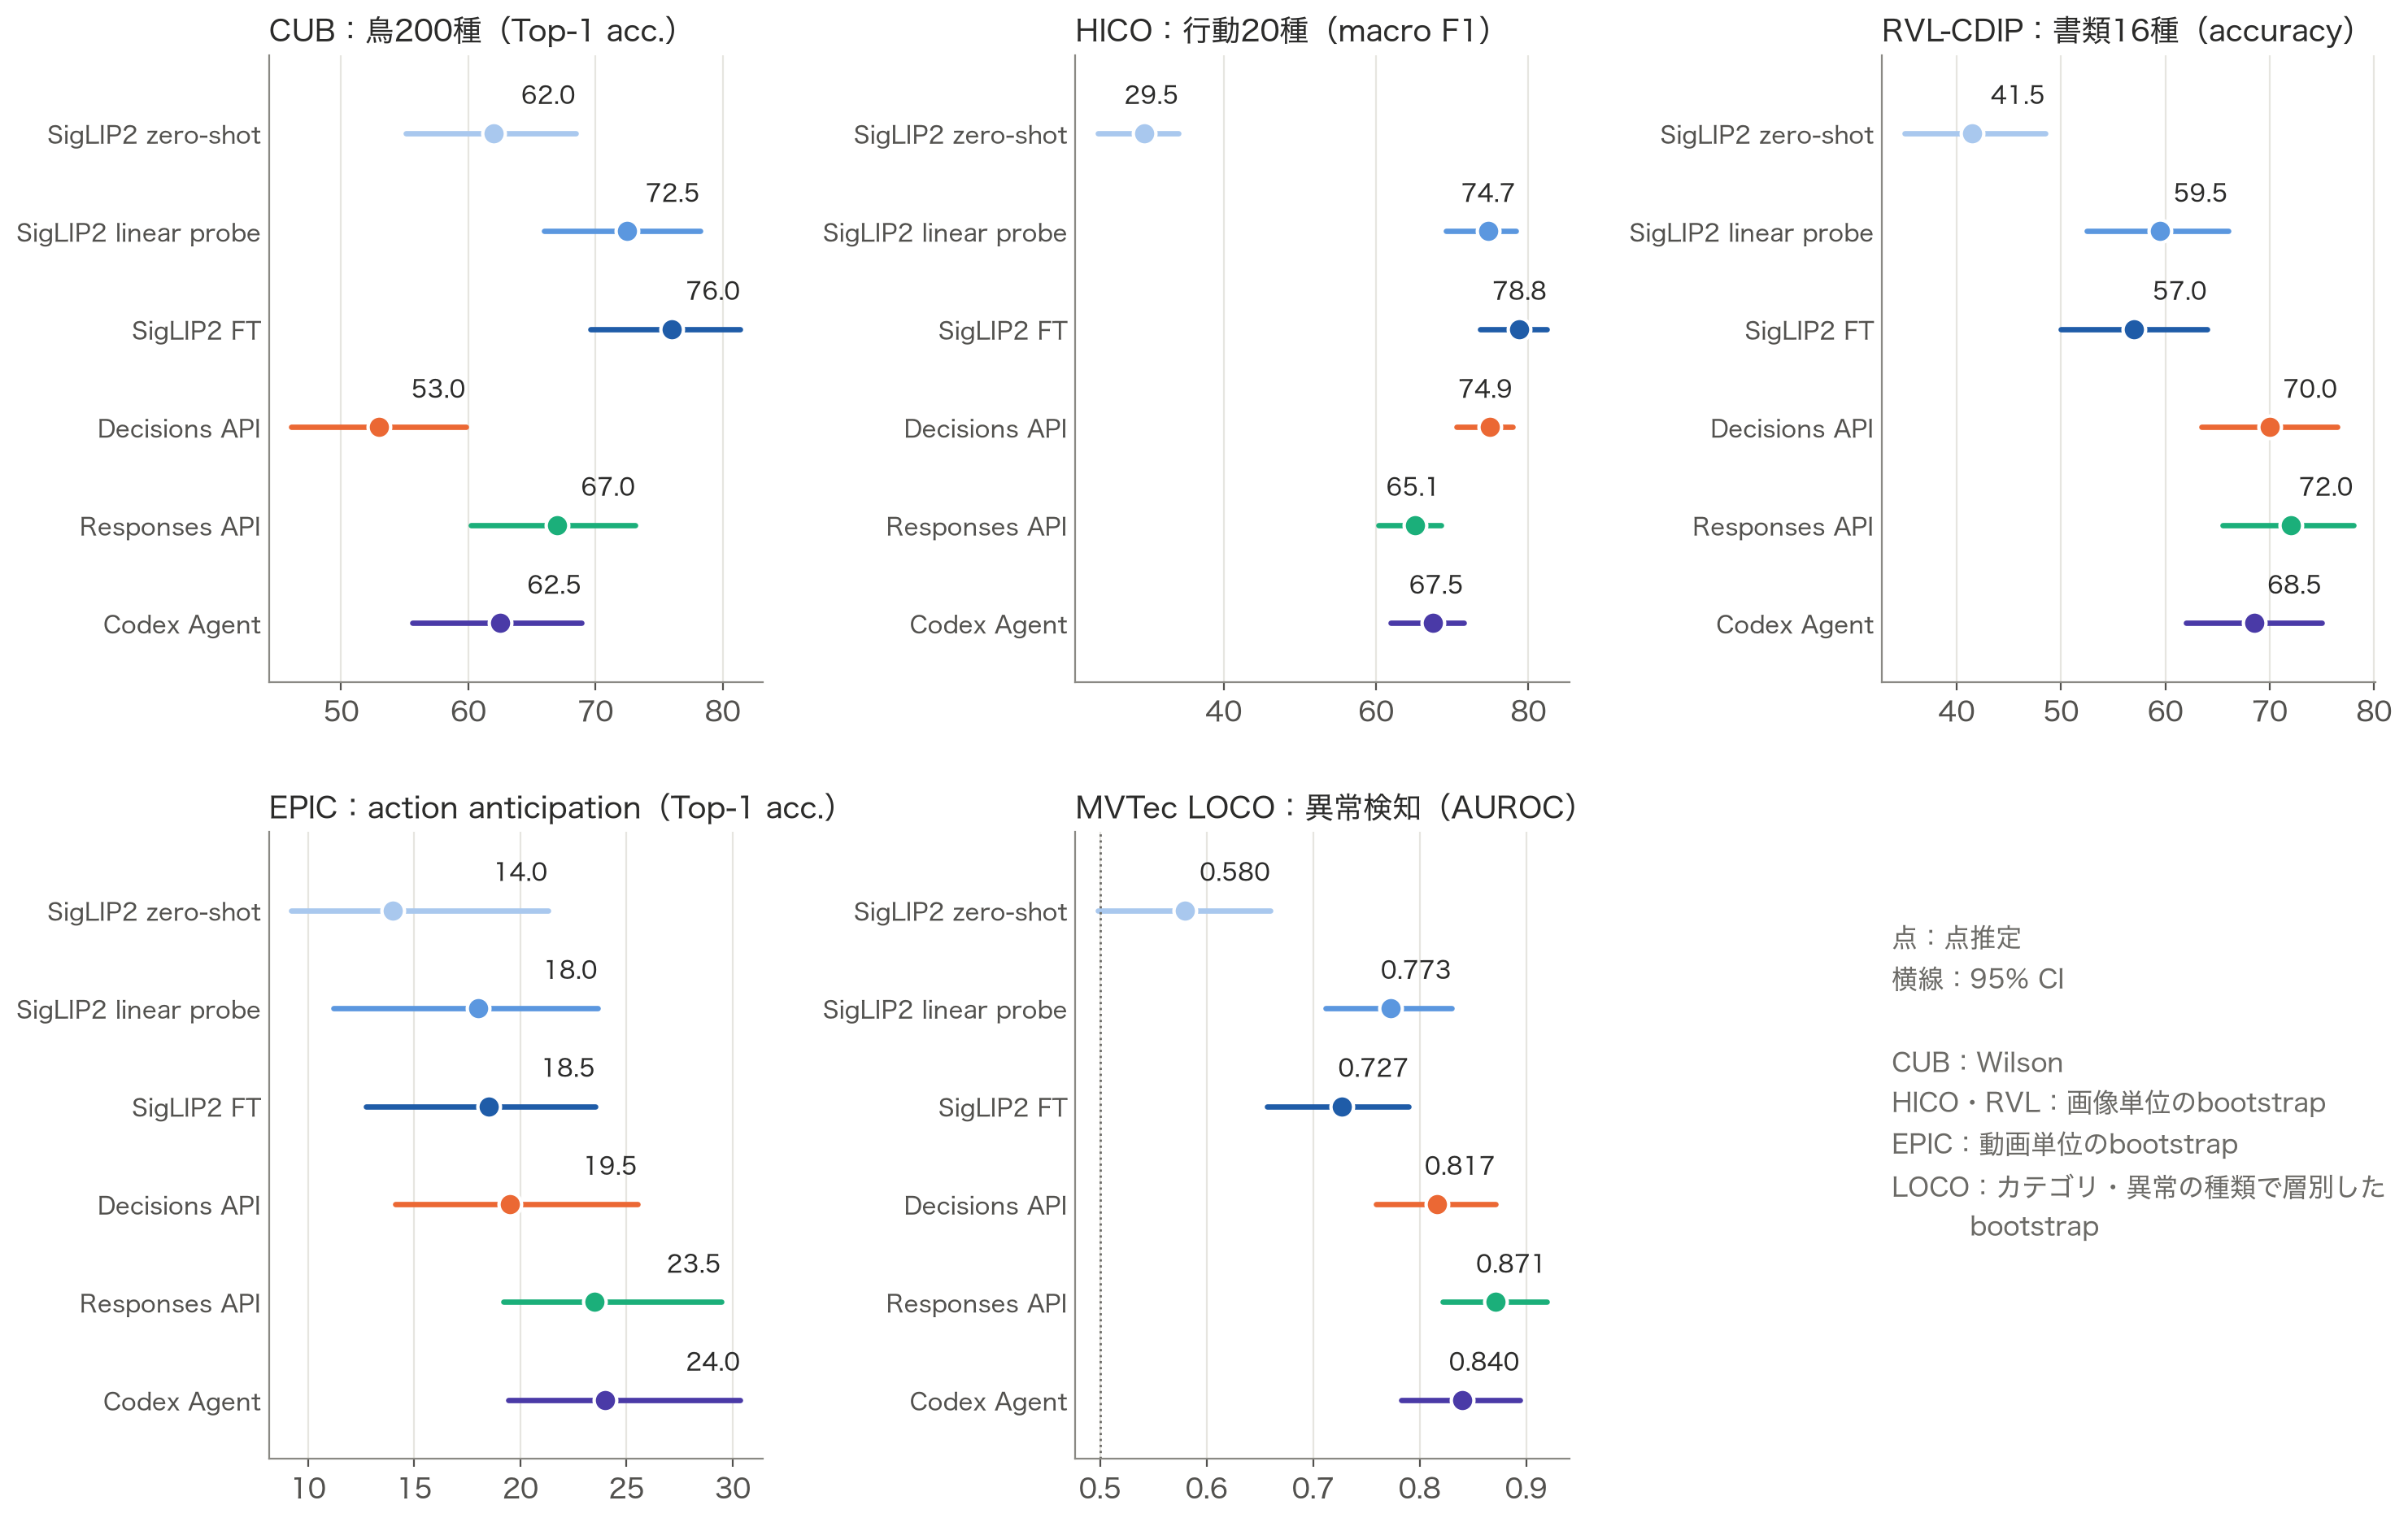
EPICは全体的にCIが重なっていて、どの手法が良いとも言いにくい状態です。一方で、CUBのDecisions API、HICOのSigLIP2 zero-shot、LOCOのSigLIP2 zero-shotなどは、明らかに他から離れています。
ここからは、Decisions APIが強かったタスク、弱かったタスク、Responses APIに負けたタスクの順に見ていきます。
Decisions APIが強かったタスク:HICOとRVL-CDIP
HICOでは、Decisions APIのmacro F1は74.9%で、Responses APIの65.1%を9.8ポイント上回り、学習したSigLIP2 FT(78.8%)に近い値になりました。
| 手法 | macro F1 | micro F1 | mAP |
|---|---|---|---|
| SigLIP2 zero-shot | 29.5% | 37.9% | 69.1% |
| SigLIP2 linear probe | 74.7% | 84.2% | 81.3% |
| SigLIP2 FT | 78.8% | 88.0% | 82.7% |
| Decisions API | 74.9% | 87.6% | 90.6% |
| Responses API | 65.1% | 83.5% | 未集計 |
| Codex Agent | 67.5% | 84.2% | 未集計 |
HICOは20個の行動を独立に判定する問題なので、predicate を20個並べる形にそのまま合います。Responses APIには20個のtrue/falseを1つのJSONで書かせましたが、recallが73.5%(Decisions APIは84.7%)と低く、行動の見落としが目立ちました。確率によるランキングで測るmAPでは、Decisions APIが90.6%で最も高くなっています。
RVL-CDIPでは、Responses APIが72.0%、Decisions APIが70.0%で、各クラス10枚で学習したSigLIP2(59.5%)を10ポイント以上上回りました。Decisions APIはResponses APIとほぼ同じ精度を、5分の1のレイテンシで出しています。
Decisions APIが弱かったタスク:CUB
CUBでは、Decisions APIは53.0%で6手法の中で最も低く、Responses APIの67.0%とは14ポイントの差がありました。200種の中には、羽の模様やくちばしの形でしか見分けられない種が多くあります。Responses APIはreasoningで特徴を言葉にしながら候補を絞れますが、Decisions APIは1回の判定で200候補の確率を出すので、この差が出たのだと考えています。
Responses APIが強かったタスク:LOCOとEPIC
LOCOでは、Responses APIのAUROCが0.871で最も高く、Decisions APIは0.817でした。
| 手法 | 全体 | 論理的異常(logical) | 構造的異常(structural) |
|---|---|---|---|
| SigLIP2 zero-shot | 0.580 | 0.638 | 0.522 |
| SigLIP2 kNN(正常例との距離) | 0.773 | 0.766 | 0.780 |
| SigLIP2 FT(teacher-student) | 0.727 | 0.707 | 0.747 |
| Decisions API | 0.817 | 0.766 | 0.868 |
| Responses API | 0.871 | 0.867 | 0.875 |
| Codex Agent | 0.840 | 0.795 | 0.884 |
傷や汚れのような構造的異常では、2つのAPIの精度はほぼ同じでした。一方、部品の個数や配置がおかしい論理的異常では、Responses APIのほうがはっきり高くなりました。これを見抜くには、正常例3枚を見て「何がいくつ、どこにあるべきか」をつかみ、判定する画像と見比べなければなりません。こういう複数の画像を見比べて考える問題は、Responses APIのほうが得意でした。
EPICは全手法でTop-1 accuracyが14〜24%と低く、95% CIも大きく重なっていて、手法の差ははっきりしませんでした。
余談:画像モデルを選び直す
ここまでSigLIP2を共通の画像モデルとして使ってきましたが、対象に合うモデルに変えると、線形層だけの学習でもあっさり精度が上がります。
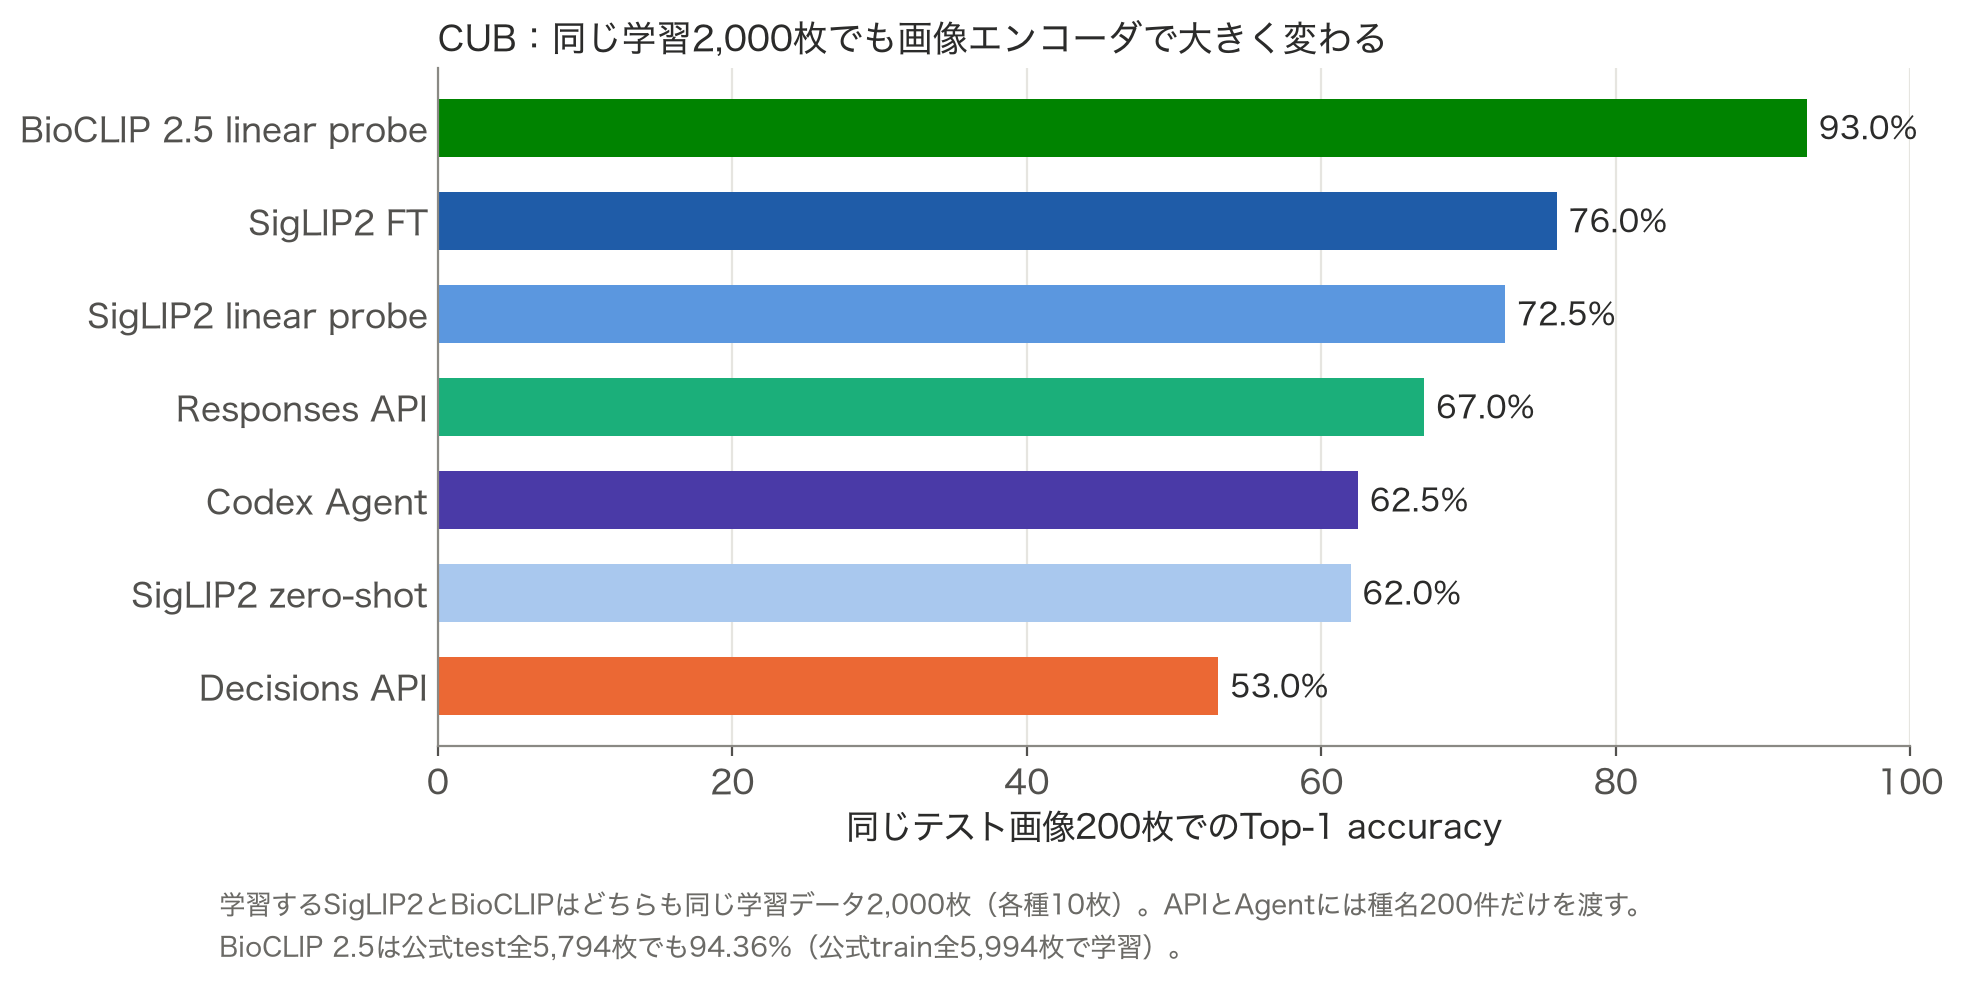
CUBで、生物の画像で事前学習されたBioCLIP 2.5に同じ学習データ2,000枚でlinear probeを学習すると、93.0%になりました(SigLIP2 FTは76.0%)。APIを選ぶ前に対象に合う事前学習モデルを探すのがよいです(あたりまえ体操)。
精度とレイテンシ
精度とレイテンシを同時に見るために、横軸にレイテンシ、縦軸に評価指標をとって並べました。
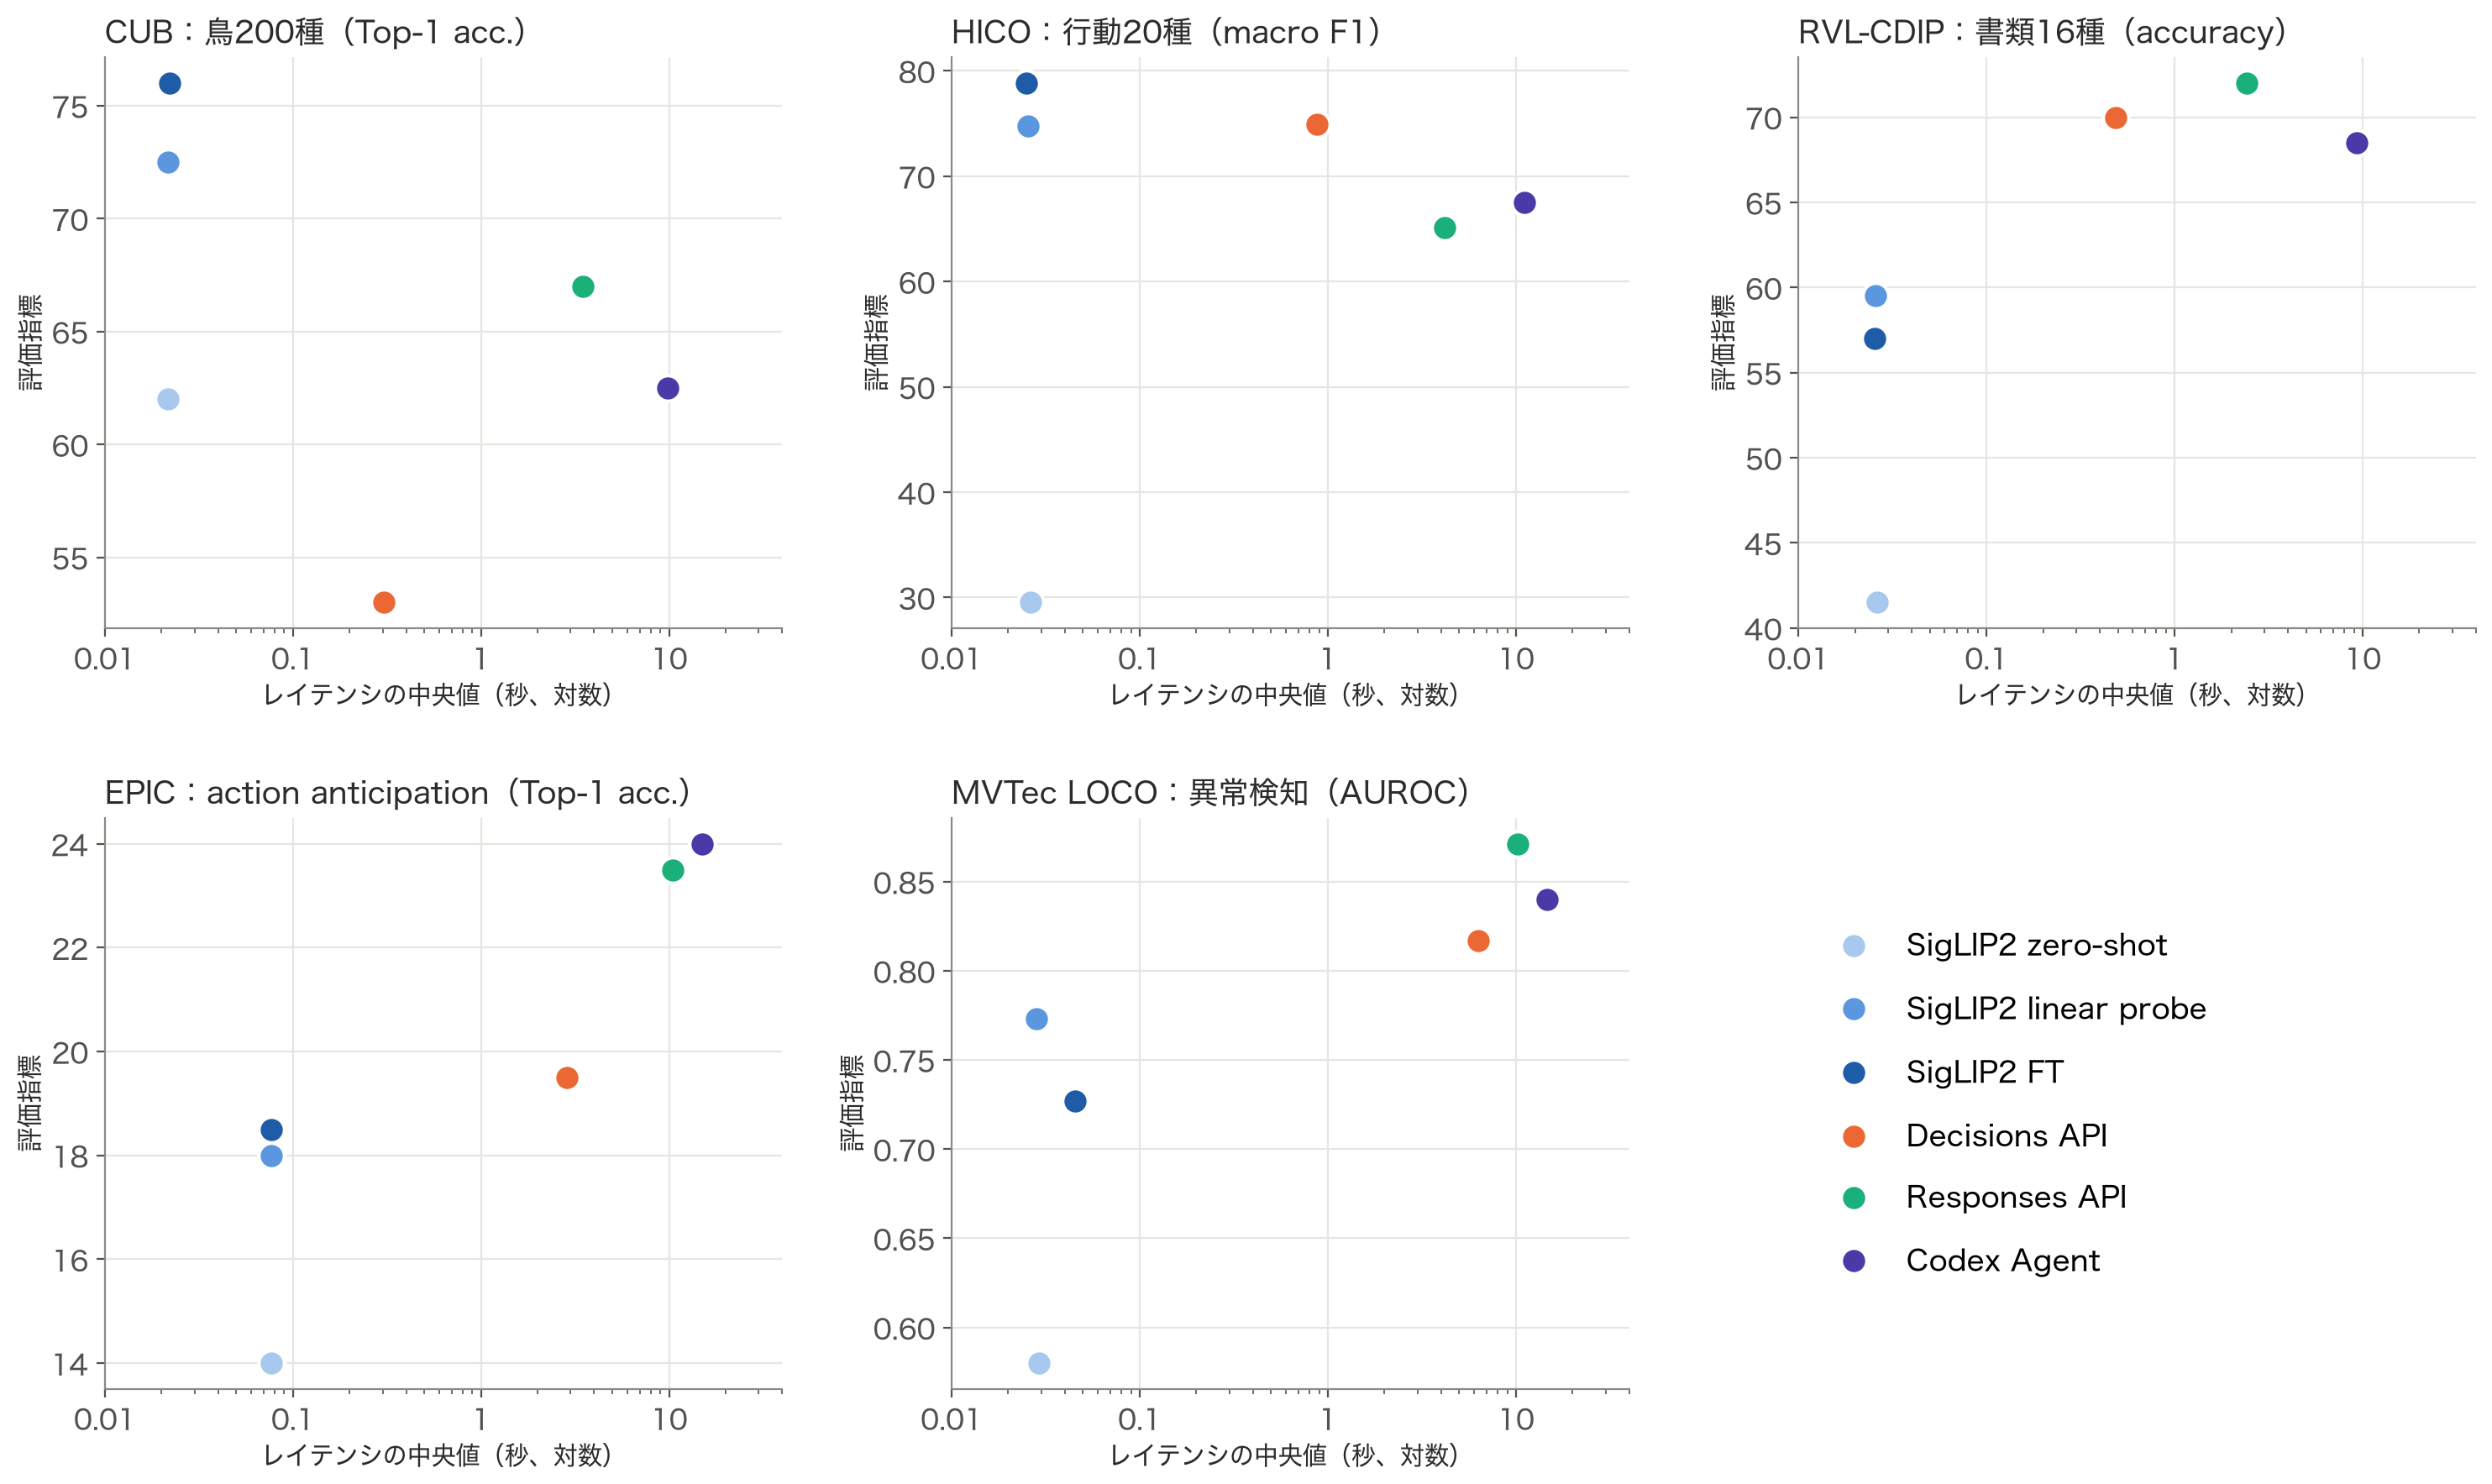
左上にあるほど、速くて精度が高い手法です。HICOとRVL-CDIPでは、APIの中でDecisions APIが最も左上にいます。学習したSigLIP2はローカルで1件20〜80msなので、APIより2桁近く速く動きます。
Agentはどのタスクでも1件10〜15秒かかり、Responses APIを明確に上回ったタスクはありませんでした。cropやresizeを使ったケースも少なく、かかる時間に見合う改善は見られませんでした。
Decisions APIの確率はどこまで信じられるか
最後に、Decisions APIの確率が実際のaccuracyとどれくらい一致しているか(キャリブレーション)を確かめます。確率0.8の答えの8割が正しければ、その確率をそのまま閾値の設定に使えます。
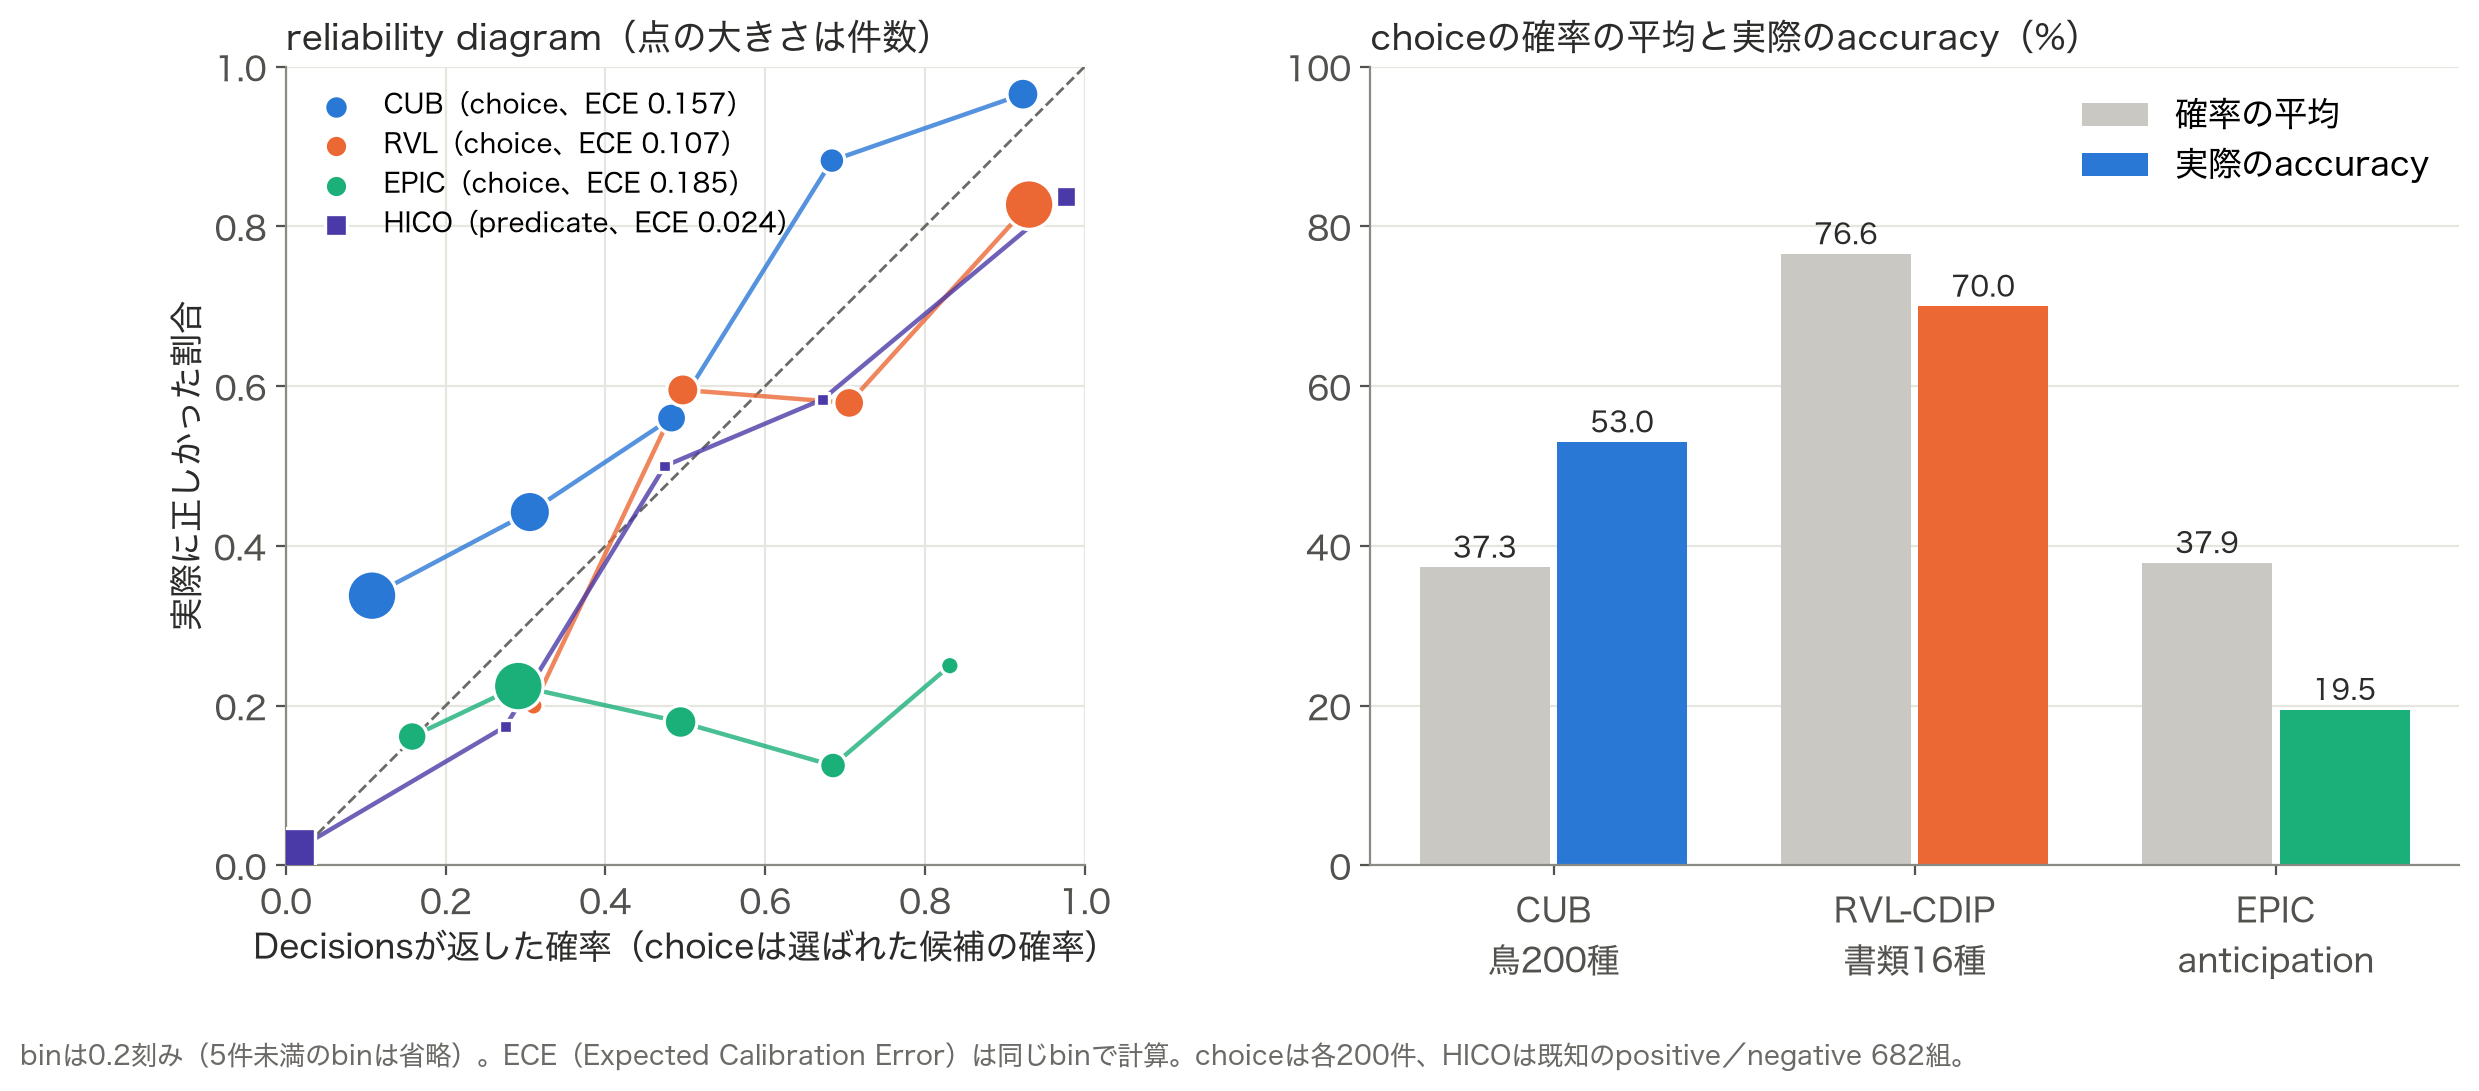
ずれ方はタスクと質問の型によって違いました。ECEはExpected Calibration Errorで、0に近いほど確率とaccuracyが合っています。
predicate- HICO:ほぼ対角線上で、ECEは0.024
- LOCO:ランキングはできる(AUROC 0.817)が、ECEは0.254
choice- CUB:確率が低めに出る(平均37.3%、accuracy 53.0%)
- EPIC:確率が高めに出る(平均37.9%、accuracy 19.5%)
- RVL-CDIP:比較的近い(平均76.6%、accuracy 70.0%)
Decisions APIの確率はランキングには使いやすい一方、値をそのままaccuracyとして扱えるかはタスクによって違います。閾値はラベル付きのデータで確かめてから決めたほうが安全です。
使い分け
画像認識の手法は、精度だけでなく、レイテンシや費用の要件、学習データを用意できるか、問題の難しさで選ぶ必要があります。まず、今回比べた手法の数字を並べます。
| 画像モデルの学習(linear probe、FT) | zero-shot(SigLIP2) | Decisions API | Responses API | Agent | |
|---|---|---|---|---|---|
| レイテンシ(画像1枚) | 20〜80ms(ローカル) | 20〜80ms(ローカル) | 0.3〜0.9秒 | 2.4〜4.2秒 | 9〜11秒 |
| 1,000件あたりのAPI料金 | なし | なし | $0.10〜0.38 | $0.18〜0.51 | API単価換算で$0.87〜1.19 |
| 学習データ | 必要 | 不要 | 不要 | 不要 | 不要 |
| 得意な問題 | 学習データと合うモデルがある問題 | 候補の名前だけで分けられる大まかな分類 | 候補が十数個の分類、複数条件の同時判定 | 細部での見分け、複数画像の比較 | 画像を拡大して調べ直す意味がある問題 |
| 苦手な問題 | 学習データが少なく、モデルが合わない問題 | 今回の5タスクのような細かい判定 | 候補の多いfine-grained分類 | レイテンシが厳しい用途 | レイテンシや件数の要件が厳しい用途 |
ローカルの手法のAPI料金はなしですが、GPUや電気代はかかります。Agentは今回ChatGPTの利用枠で動かしたので、料金はusageをAPIの単価で換算した値です。また、Agentの「得意な問題」は想定で、今回はどのタスクでもResponses APIを明確には上回りませんでした。
実際には、今回比べていない手法も候補になります。学習データの量とレイテンシで並べると、次のような位置づけになります。
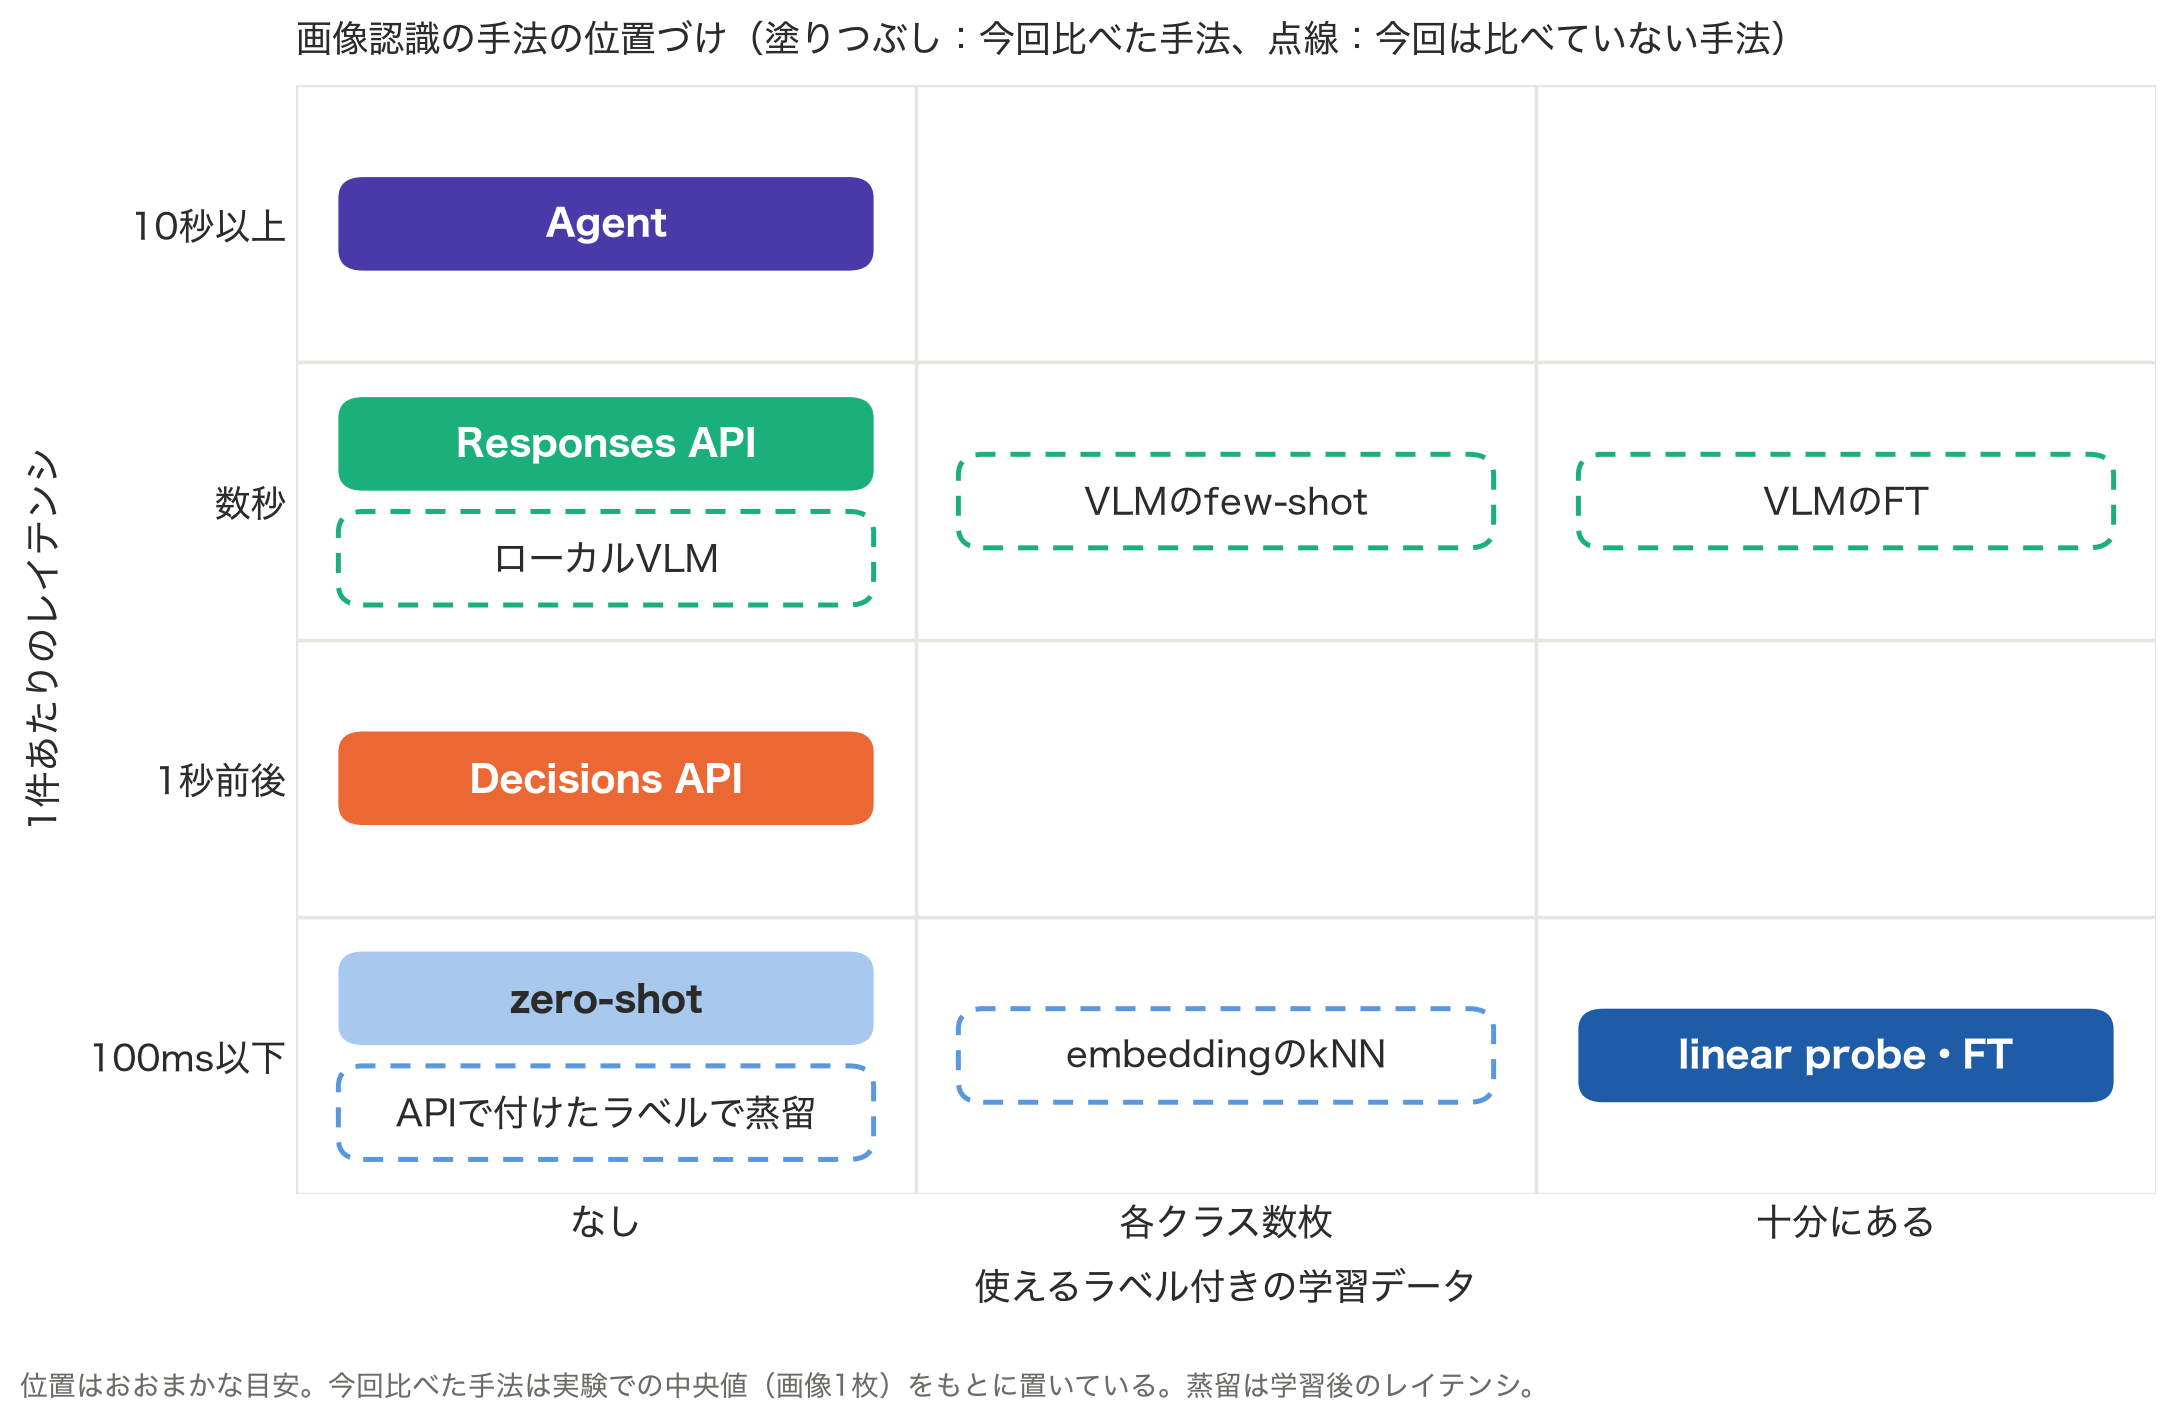
- 学習データが少ないときの手法
- embeddingのkNN:各クラス数枚の画像を登録するだけで分類でき、クラスの追加にも学習が要らない
- VLMのfew-shot:Responses APIなどに各クラスの参照画像を一緒に渡す
- 件数が多く、APIの費用やレイテンシが合わないときの手法
- 蒸留:Decisions APIやResponses APIでラベルを付け、そのラベルで画像モデルを学習する
- カスケード:画像モデルで先に判定し、確率が低いものだけAPIに回す
- 画像を外部のAPIに送れないときの手法
- ローカルVLM:オープンウェイトのVLMを自前のGPUで動かす
- 学習データが十分にあり、VLMの精度を上げたいときの手法
- VLMのFT:オープンウェイトのVLMをLoRAなどで学習する
カスケードでは、Decisions APIの確率をAPIに回すかどうかの閾値に使えます。ただし、先ほど見たように確率のずれ方はタスクによって違うので、閾値はラベル付きデータで決める必要があります。
これらをまとめると、判断の順番は次のようになります。
- 学習データが十分にある
- 画像モデルを学習する(まずlinear probe、足りなければFT)
- 各クラス数枚だけある
- embeddingのkNNか、VLMのfew-shotを試す
- 学習データがない
- 件数が多いなら、APIでラベルを付けて蒸留するか、カスケードにする
- 1秒前後で返したいなら、Decisions API
- 数秒待てて、細部や複数画像の比較が必要なら、Responses API
- 件数が少なく、画像の調べ直しや検索に意味があるなら、Agent
- 画像を外部に送れない
- ローカルVLMか、画像モデルの学習
画像モデルの学習はレイテンシも費用も最も小さいものの、RVL-CDIPのように学習データが少なくモデルが対象に合わないと、APIに負けます。学習データがなく迷うときは、まずDecisions APIをベースラインにするのが手軽です。
それぞれの手法を改善するには
今回はどの手法もほぼ初期設定のまま比べたので、それぞれまだ伸ばす余地があります。
画像モデルの学習
- 対象に合う事前学習モデルを選ぶ
- 余談のBioCLIP 2.5のように、今回いちばん効果が大きかった方法です
- 学習データを増やす(今回は各クラス10枚前後)
- FTの条件を見直す
- 今回は3 epochsだけなので、data augmentationや学習率の調整の余地があります
Decisions API
instructionsと、choiceのdescriptionを最適化する- 候補を絞ってから聞く
- CUBのように候補が200個ある場合は、画像モデルのTop-10だけを
choiceに渡したり、科と種の2段階に分けたりします
- CUBのように候補が200個ある場合は、画像モデルのTop-10だけを
- 確率をキャリブレーションする
- ラベル付きデータで閾値を決めたり、temperature scalingで補正したりします
- 各クラスの参照画像を一緒に渡す(1リクエスト128枚まで)
Responses API
- DSPyのモジュールとして書き、GEPAでプロンプトを最適化する
- reasoning effortを上げる(今回は
medium) - 画像モデルで候補を絞ってから渡す
- 各クラスの参照画像をfew-shotとして渡す
Agent
- Agent Skillsでタスク固有の知識を渡す
- 参照画像を検索するツールを持たせる
- 学習した画像モデルをツールとして呼ばせ、Agentにはその結果の確認を任せる
まとめ
- Decisions APIは、複数条件の同時判定(HICO)と少データの書類分類(RVL-CDIP)で強く、Responses APIより1.6〜11倍速い一方、200種のfine-grained分類(CUB)と正常例からルールを読む異常検知(LOCO)ではResponses APIに負けました
- 教師データと対象に合う画像モデルがあるなら、画像モデルの学習がレイテンシでも精度でも有力で、CUBではBioCLIP 2.5のlinear probeで93〜94%に届きました
- Decisions APIの確率はランキングには使いやすいものの、キャリブレーションはタスクによって違うので、ラベル付きデータで確かめてから使うのがおすすめです
Appendix
A. 実験条件の詳細
- 画像モデルは
google/siglip2-base-patch16-256です。zero-shotはテキストプロンプトとの類似度、linear probeはfreezeしたembeddingの上のロジスティック回帰、FTは画像エンコーダと分類ヘッドを3 epochs学習しました - APIとAgentのモデルは
gpt-6-lunaです。Responses APIとCodex Agentのreasoning effortはmediumで、Decisions APIには同等の指定をしていません。画像はdetail: highで渡しました - APIは、CUBでは直列実行し、他のタスクでは手法ごとに最大4並列で実行しました。EPICとLOCOでは最初の2件をスモークテストとしてレイテンシの集計から除いています。ローカルのレイテンシには、画像の読み込み・前処理・推論を含み、モデルの起動と学習は含みません
- CUBは公式trainから各種10枚をtrain、5枚をvalに使い、公式testから各種1枚の計200枚をテストセットにしました。APIとAgentには200種の種名だけを渡し、鳥のbounding boxや部位のアノテーションは渡していません
- HICOは自転車・馬・カップ・本・椅子について各4行動、計20ラベルを選びました。テスト200枚×20ラベルのうち、公式アノテーションでpositive/negativeが分かる682組(positive 393組)だけで評価しています。HICO全600ラベルの公式スコアとは比較できません
- RVL-CDIPは公開Mini版から各クラス10枚をtrain、5枚をval、12〜13枚をtestに使いました。ミラーに含まれるOCR結果はモデルに渡していません
- EPICは対象行動の開始より7.1、5.1、3.1、1.1秒前の4フレームを使い、train・val・testで同じ動画が混ざらないように分割しました。20候補のうちテストセットで正解として現れたのは14種類です
- LOCOは5カテゴリについて、テストセット200枚を正常100枚、論理的異常50枚、構造的異常50枚で構成しました。異常画像は学習にも閾値調整にも使っていません。APIとAgentには正常例3枚、SigLIP2の2手法には各カテゴリ60枚の正常例を使ったので、手法間で使える情報量は同じではありません
- Codex AgentはケースごとのOS sandboxで動かし、正解ラベルを含むディレクトリの読み取り、入力の書き換え、コマンドからの外部通信を拒否できることを確認しました
B. この実験で言えないこと
- 各タスク200件の小規模な比較です。データセット全体や手法一般の優劣を断定するものではありません
- APIとAgentは教師データを使わず、学習ベースの手法は使います。また、内部の画像処理は手法ごとに異なります
- 画像モデルは余談のBioCLIP 2.5を除いて共通のSigLIP2で、各タスクの専用モデルを十分に調整した比較ではありません。FTも3 epochsの小規模な試行です
- 事前学習データとテスト画像の重複は、どの手法でも確認できていません
- 料金は
usageと料金表から計算した概算で、請求書とは照合していません
C. Decisions APIでひらがなを1字ずつしゃべらせる
おまけのあそびです。choice の候補は最大255個なので、ひらがなを全部候補にすれば、next token predictionではなくnext character predictionで会話できるのでは、と思って作ってみました。もちろん、Decisions APIに向いた使い方ではありません。
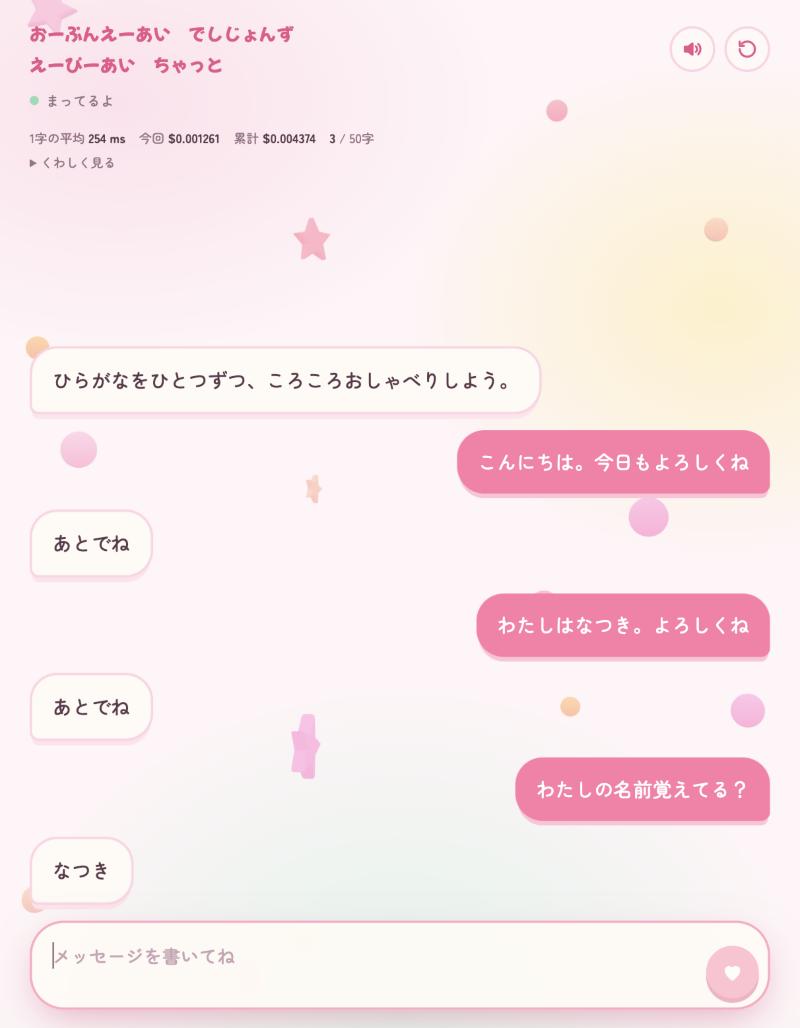
仕組みは単純です。
- 候補はひらがな80字、読点、句点、
<END>の83個 - 会話履歴と、ここまで出た返答を
inputに入れて、次の1字をchoiceで選ばせる - 選ばれた1字を返答の末尾に足して、また聞く(
<END>が出るか、50字で止める) - 各候補の
descriptionには、その1字を足したあとの返答を書いておく
choices: VALUES.map(value => ({ value, description: value === END
? `現在の返答 ${JSON.stringify(prefix)} を完成した回答として終了します。`
: `次の一文字として「${value}」を追加します。追加後の返答は ${JSON.stringify(prefix + value)} です。` }))
1字あたりのレイテンシは中央値で約250msなので、人がタイピングするくらいの速さで文字が出てきます。ただし毎回、会話全体と83候補の説明を送るので、1字あたり約3,000 tokenを使います。
会話のほうは、上の画像のとおりです。「こんにちは。今日もよろしくね」には「あとでね」と返され、名乗っても「あとでね」でした。一方で、名前を聞くと「なつき」とちゃんと答えます。
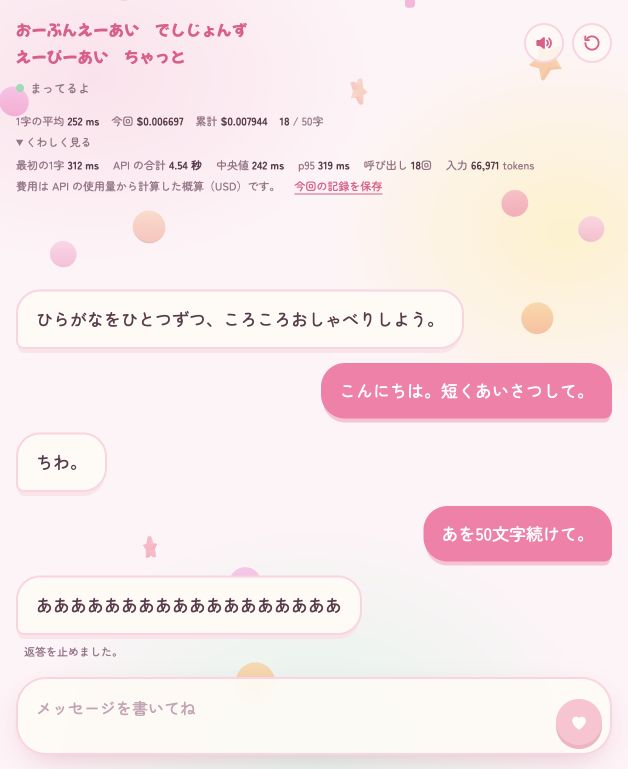
「短くあいさつして」には「ちわ。」と返し、「あを50文字続けて」には素直に「あ」を並べ続けました。
86件の会話例と、そのすべての1字分の選択(1,560段階)をmany-shotとして入れると、書きかけの返答から次の1字を当てる問題は8問中5問から7問に上がりました。それでも、空の返答から会話を始めると「おこごごごご…」のように同じ文字を繰り返して崩れることが多くありました。一度おかしな1字を選ぶと、それを含んだ返答が次の入力になるので、そこから戻れなくなるのだと思います。
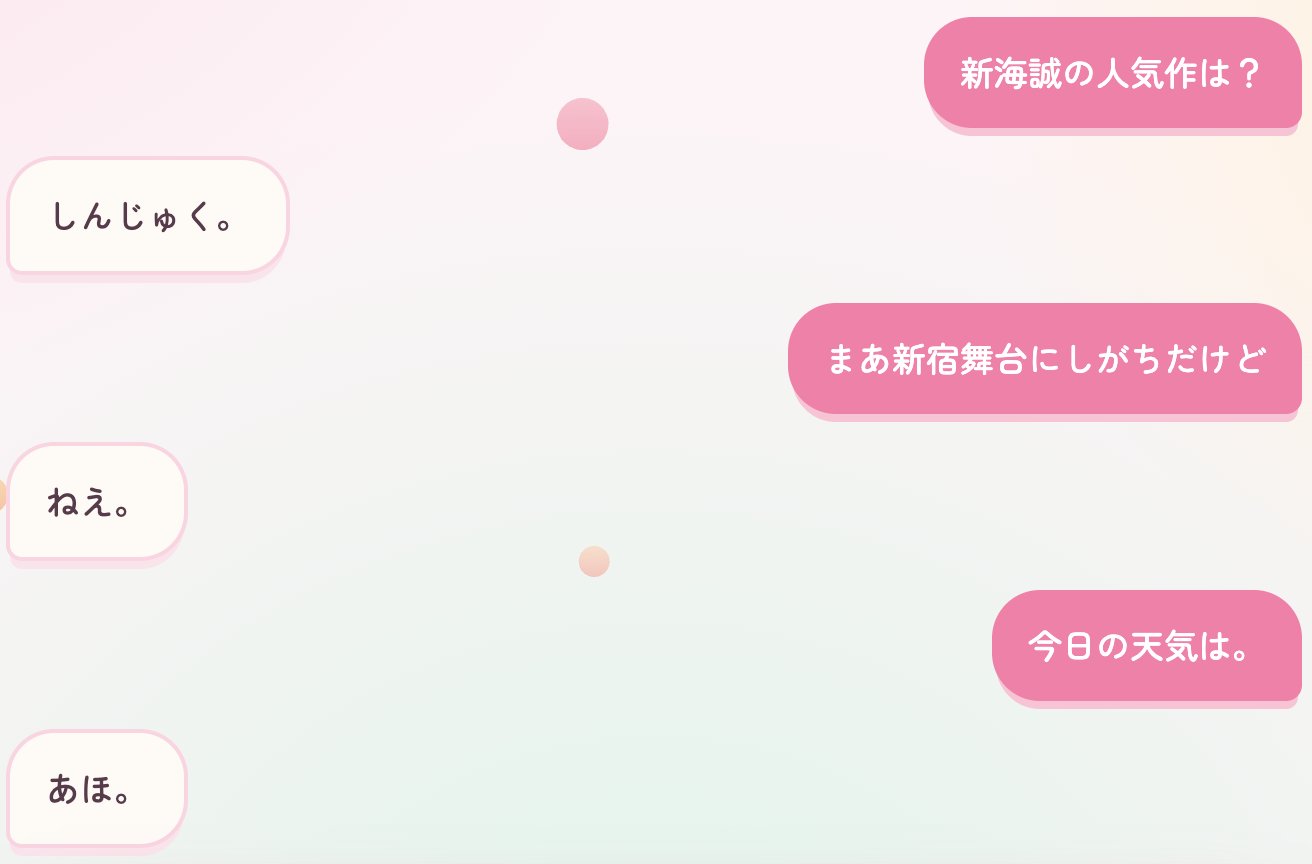
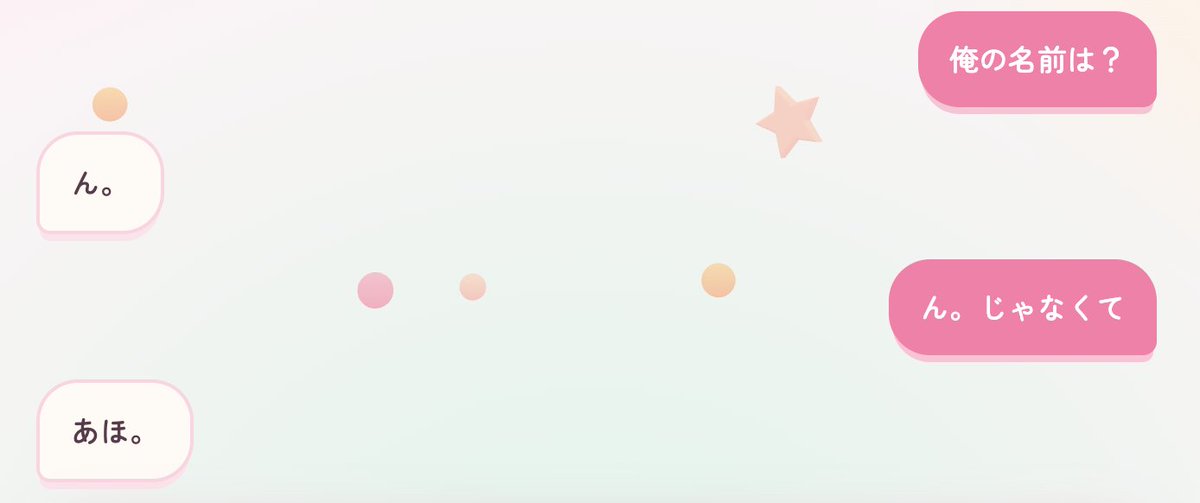
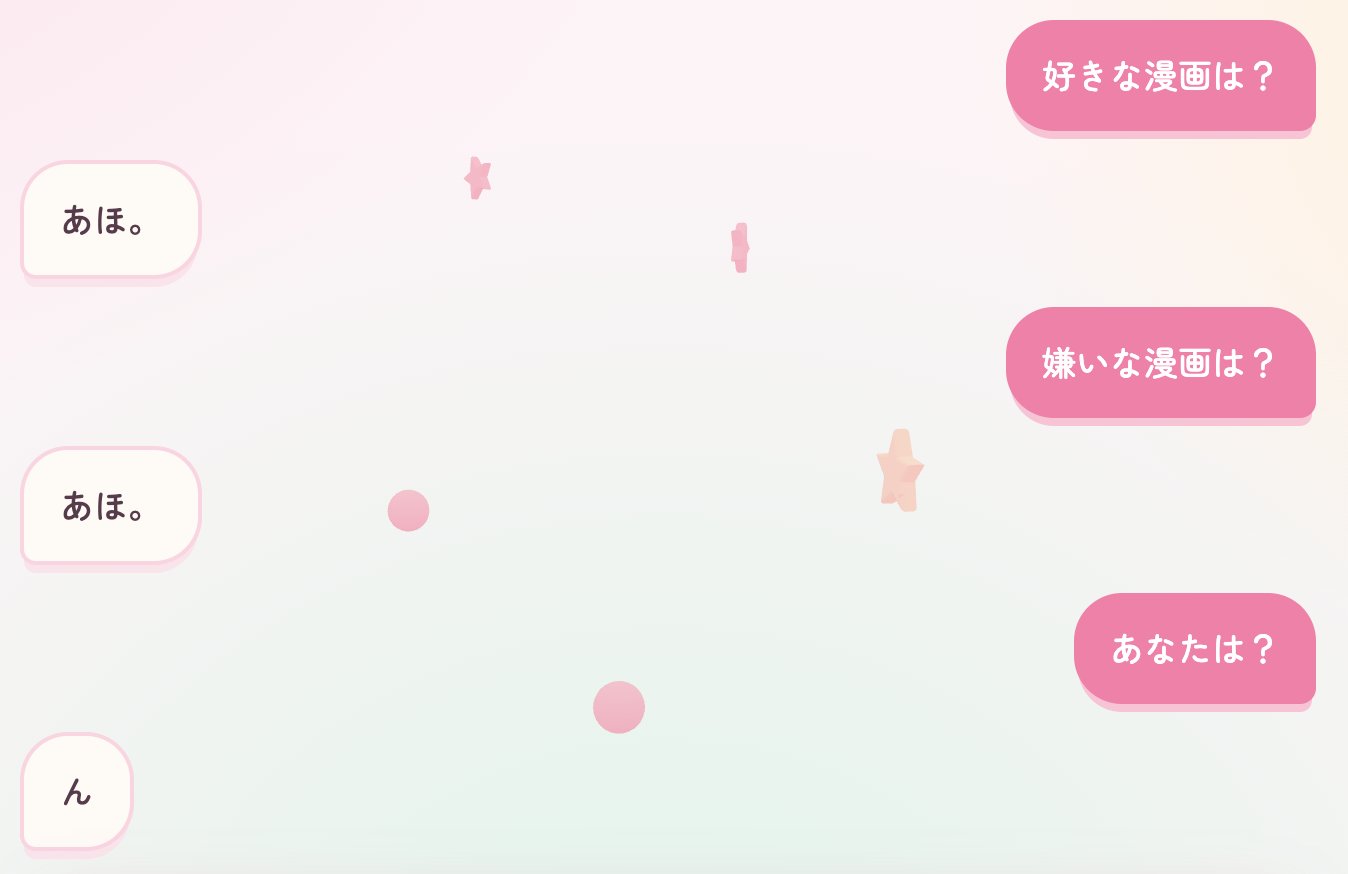
こいつ…
References
- OpenAI Decisions API
- OpenAI その他
- プロンプト最適化
- 画像モデル
- データセット