speech.cpp 0.8.4 リリース: 全モデルの量子化版公開など
by 逆瀬川ちゃん
22 min read
こんにちは!逆瀬川ちゃん (@gyakuse) です!
今日はspeech.cppの0.8.4のリリースについて書いていきます。いちばん大きな変更は、ほぼすべてのモデルにメモリの少ないPCでも動かせる小さなファイルを用意したことです。
speech.cppは音声合成、音声認識、発話区間検出のモデルをC++で動かすエンジンです (前の記事)。
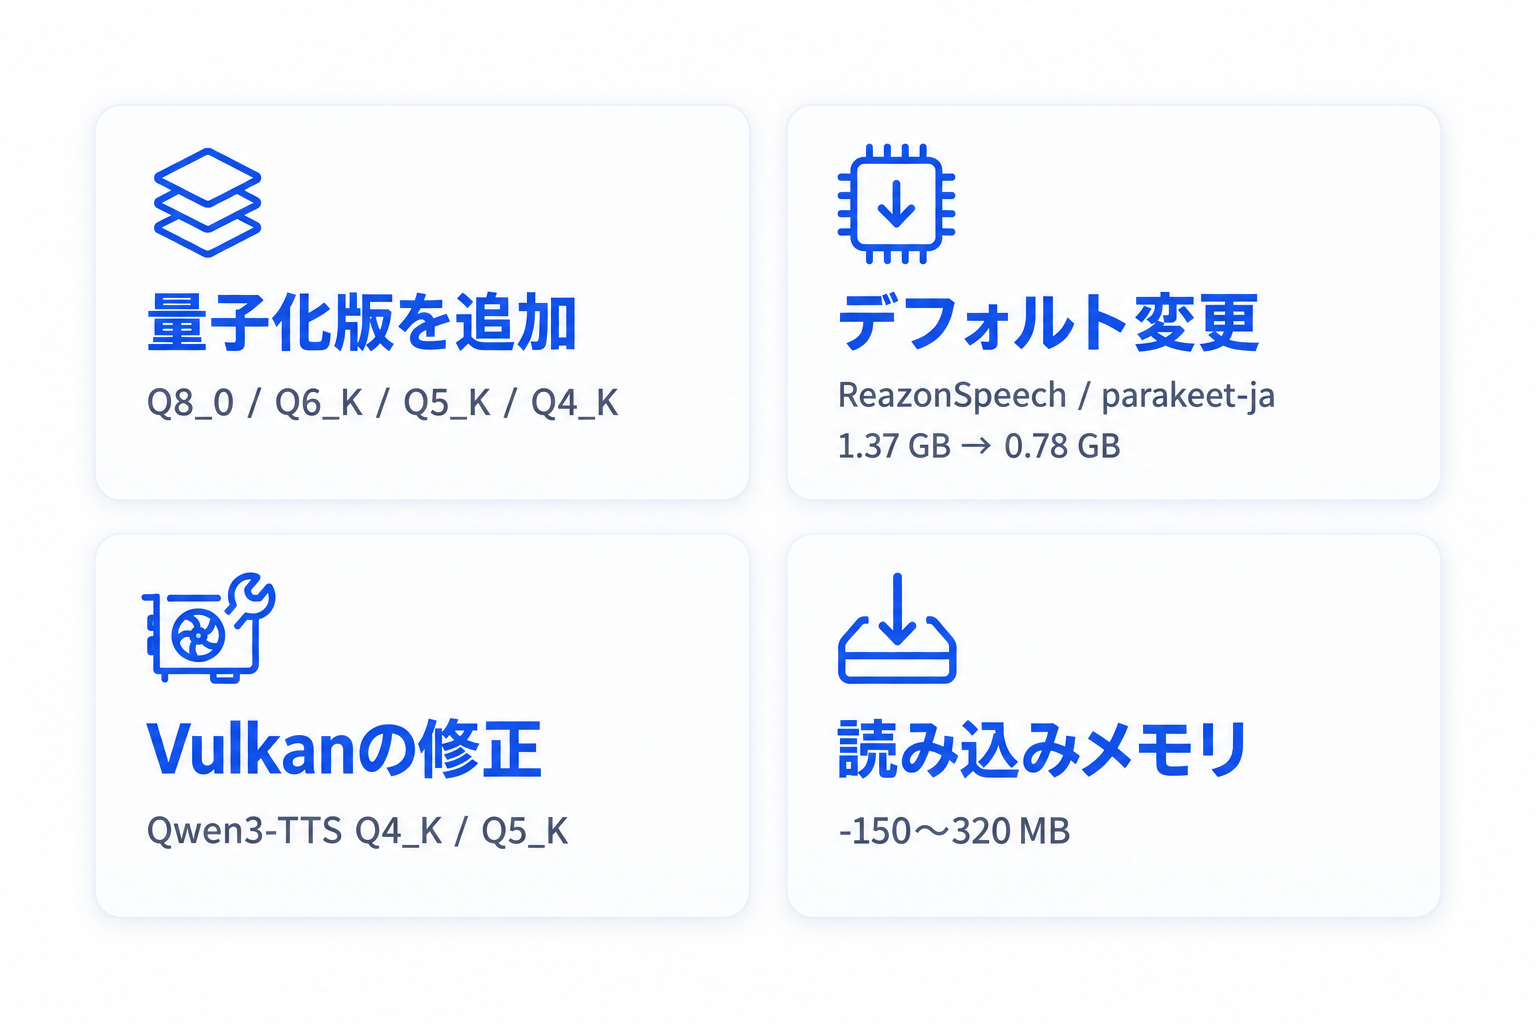
0.8.4で変わったことは大きく分けて次の4つです。
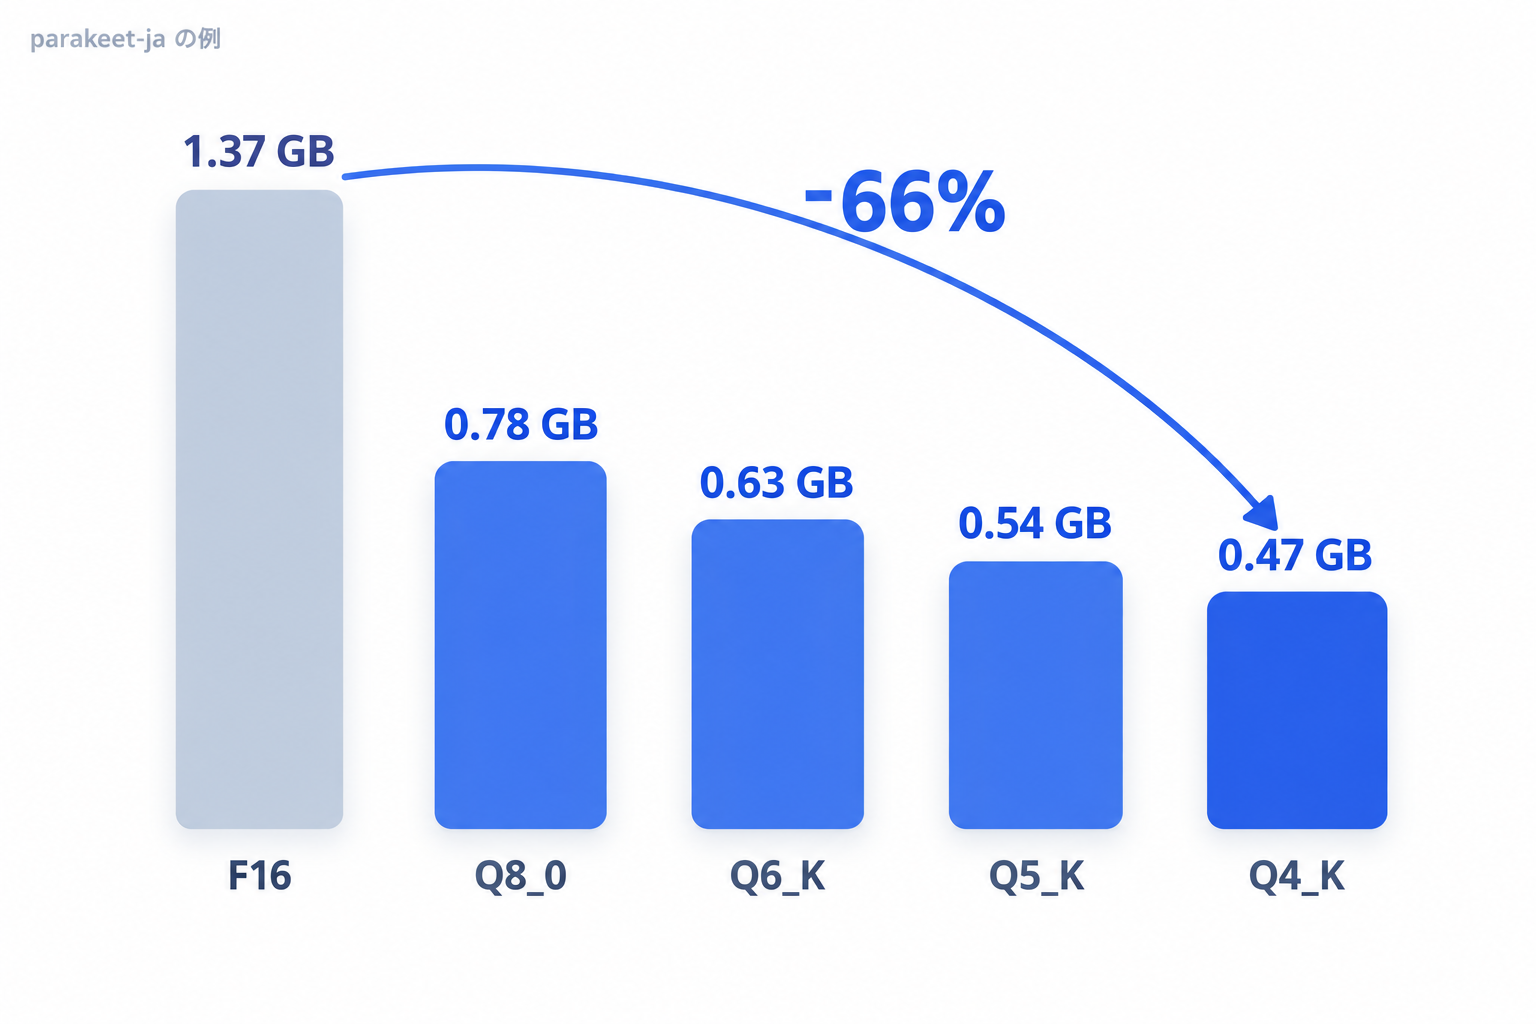
いちばん大きいのは、モデルごとにファイルの大きさを選択できるようになったことです。小さいタイプを選ぶとメモリはこのくらい減ります。
速さの変わり方はモデルによって違います。Qwen3-ASRとQwen3-TTSは小さいタイプほど速くなり、FastConformer (ReazonSpeechなど) とIrodori-TTSはほとんど変わりません。下の図は1発話を認識する時間を比較した例です。
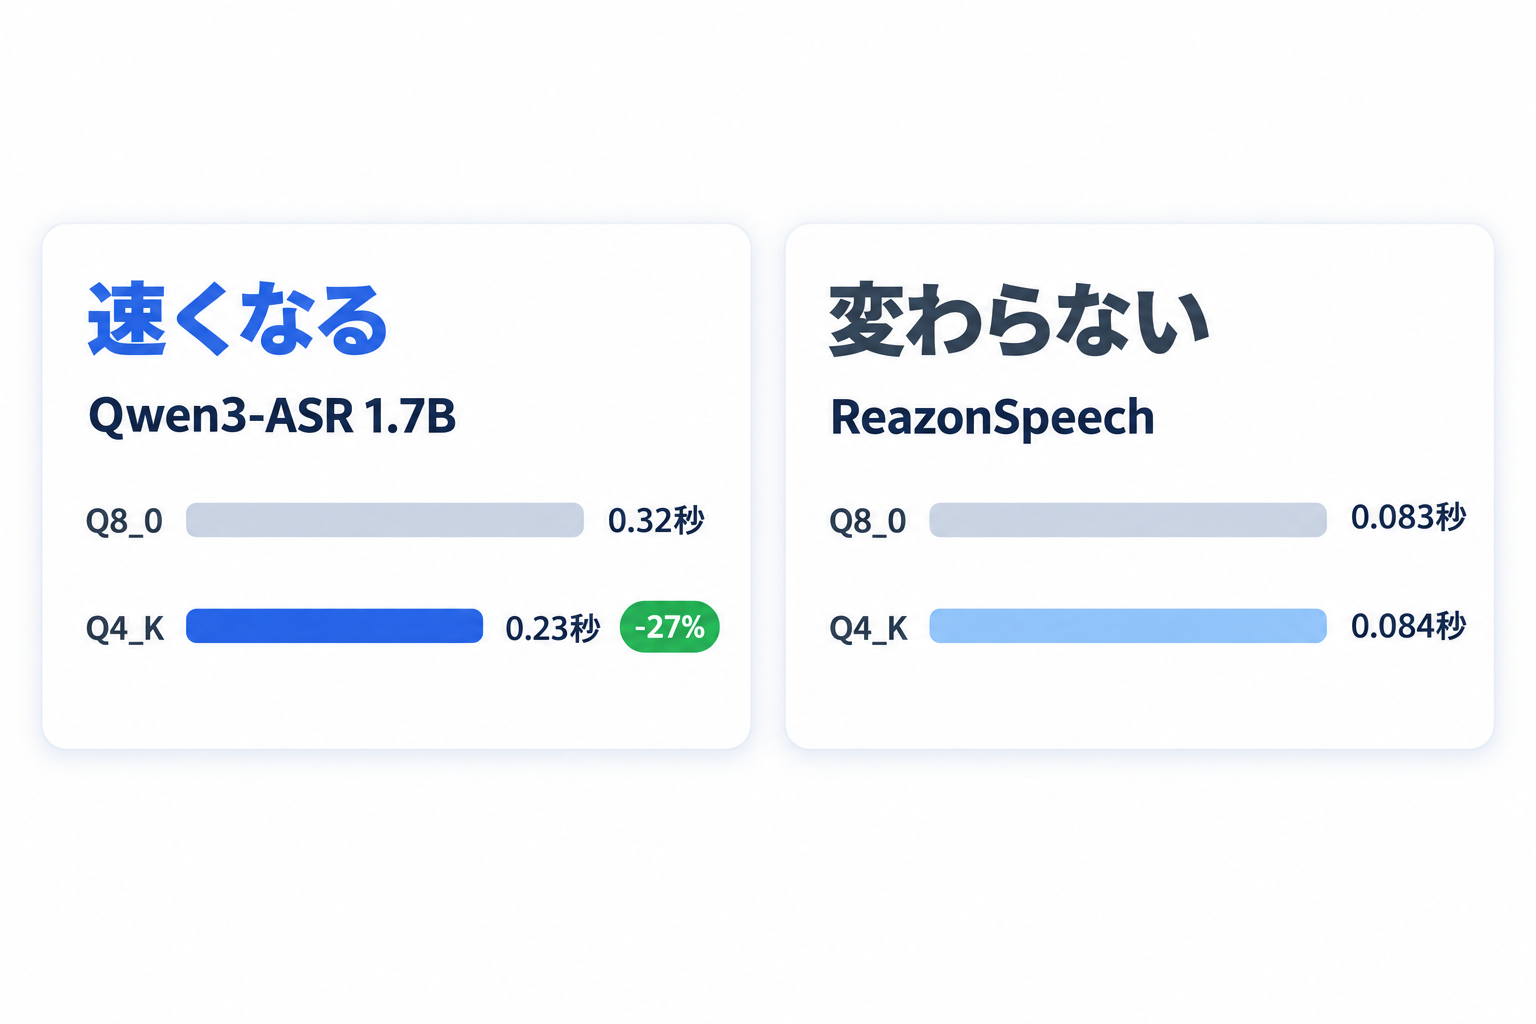
どちらもApple M5で計測した値です。この記事ではモデルごとの精度とメモリと速さを数字で見ていきます。
0.8.4で変わったこと
- 量子化版のファイルを用意しました
- Silero VADを除く9つのモデルでQ6_K、Q5_K、Q4_Kを選択できます
- これまでF16のファイルしかなかったモデルではQ8_0も選択できます
- Qwen3-TTSとQwen3-ASRは小さいタイプにすると速くもなります
- ReazonSpeechとparakeet-jaは名前だけで指定するとQ8_0のファイルを使うようになりました
- 精度はF16とほとんど同じで、メモリはほぼ半分になります
- VulkanでQwen3-TTSのQ5_KとQ4_Kが合成の途中でエラーになる問題を直しました
- モデルを読み込むときのメモリのピークが150〜320 MBほど下がりました
- Macで
libspeechを組み込んだプログラムの環境変数を書き換えなくなりました
更新のしかた
インストールしたときと同じコマンドで更新できます。Apple siliconのMacとLinuxでは次のコマンドを実行します。
curl -fsSL https://raw.githubusercontent.com/nyosegawa/speech.cpp/main/install.sh | sh
WindowsではPowerShellで次のコマンドを実行します。
irm https://raw.githubusercontent.com/nyosegawa/speech.cpp/main/install.ps1 | iex
ReazonSpeech (reazonspeech-v2) とparakeet-ja (parakeet-tdt_ctc-0.6b-ja) は、名前だけで指定したときに使うファイルがF16からQ8_0に変わりました。そのため更新したあとに初めて使うときにQ8_0のファイル (0.66 GB) をダウンロードします。F16を使い続けたい場合は reazonspeech-v2:f16 のように名前の後ろに :f16 を付けてください。F16のファイルがもう要らなければ次のコマンドで消せます。
speech rm reazonspeech-v2:f16
量子化版の使い方
使い方はモデルの名前の後ろにコロンとタイプを付けるだけです。初めて使うときにそのファイルをHugging Faceからダウンロードします。
speech asr qwen3-asr-1.7b:q6_k meeting.wav
speech tts qwen3-tts-0.6b:q6_k "明日の東京は晴れです。"
speech serve qwen3-tts-1.7b:q4_k qwen3-asr-0.6b silero-vad
speech models を実行すると、どのモデルにどのタイプがあるかを確かめられます。
qwen3-tts-0.6b q8_0 1.21 GB yes synthesis de en es fr it ja ko pt ru zh
qwen3-tts-0.6b:q6_k q6_k 0.99 GB no synthesis de en es fr it ja ko pt ru zh
qwen3-tts-0.6b:q5_k q5_k 0.87 GB no synthesis de en es fr it ja ko pt ru zh
qwen3-tts-0.6b:q4_k q4_k 0.76 GB no synthesis de en es fr it ja ko pt ru zh
タイプの数字はウェイトの1つの値をおよそ何ビットで表すかを表しています。数字が小さいほどファイルとメモリは小さくなり、そのぶん精度は下がります。ただ、どのくらい下がるかはモデルによってかなり違いました。
モデルごとの選び方
先にメモリを減らしたいときにどれを選べばよいかをまとめておきます。精度をほとんど落とさずに下げられるタイプは、モデルによってこのように違いました。
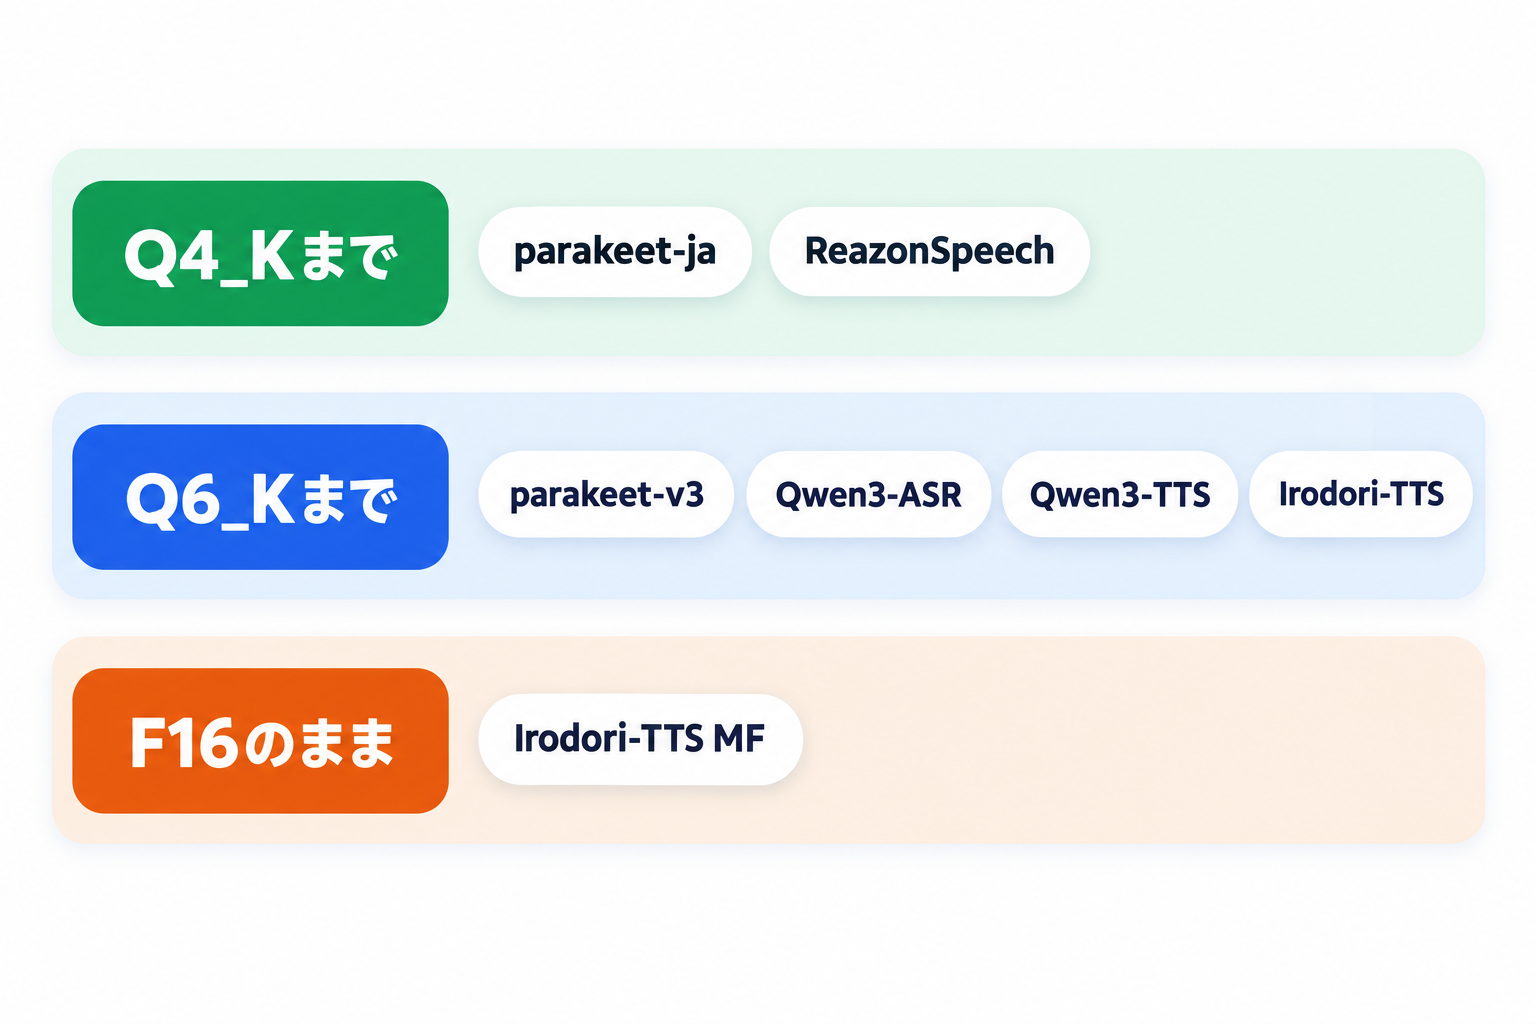
モデルごとのメモリと精度は次の図と表のとおりです。メモリは1回認識または合成したときの最大の値です。
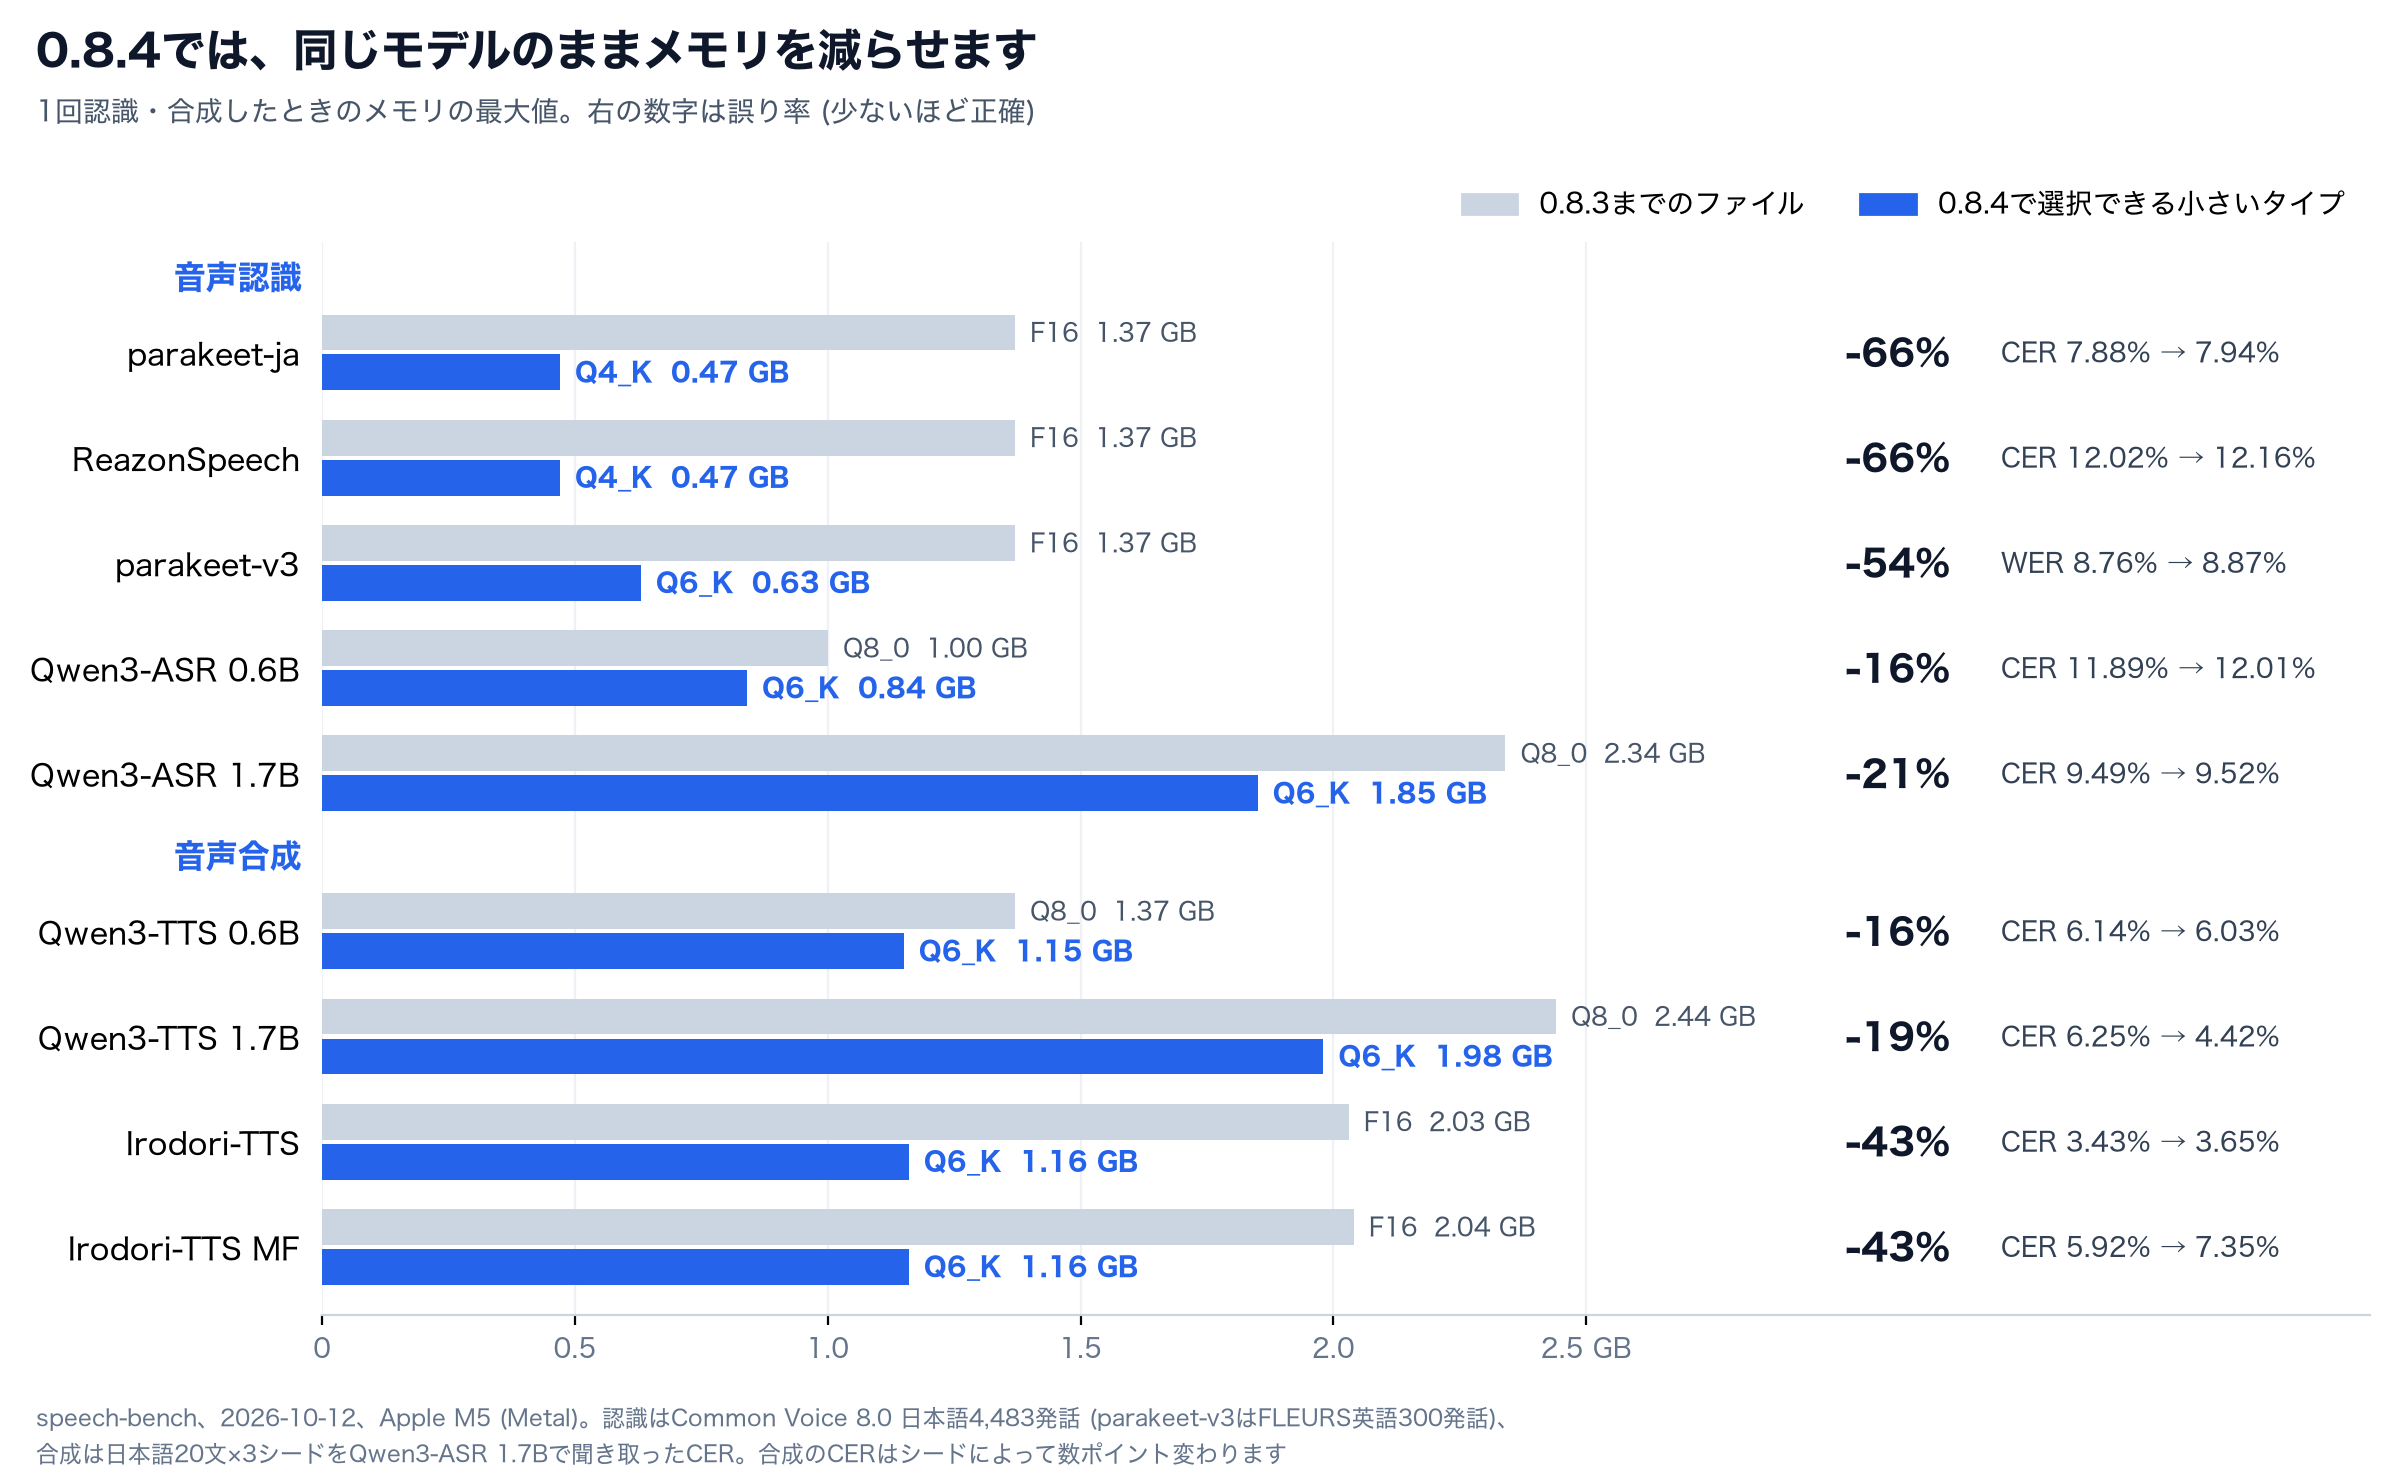
| モデル | 名前だけで指定したとき | メモリを減らしたいとき | 精度の変わり方 |
|---|---|---|---|
| parakeet-ja | Q8_0 (0.78 GB) | Q4_K (0.47 GB) | ほとんど変わりません |
| ReazonSpeech | Q8_0 (0.78 GB) | Q4_K (0.47 GB) | ほとんど変わりません |
| parakeet-v3 | F16 (1.37 GB) | Q6_K (0.63 GB) | WERが0.1ポイント上がります |
| Qwen3-ASR 0.6B | Q8_0 (1.00 GB) | Q6_K (0.84 GB) | ほとんど変わりません |
| Qwen3-ASR 1.7B | Q8_0 (2.34 GB) | Q6_K (1.85 GB) | ほとんど変わりません |
| Qwen3-TTS 0.6B | Q8_0 (1.37 GB) | Q6_K (1.15 GB) | ほとんど変わりません。Q4_Kは読み間違いが増えます |
| Qwen3-TTS 1.7B | Q8_0 (2.44 GB) | Q6_K (1.98 GB) | 計測した範囲では差が見えません |
| Irodori-TTS | F16 (2.03 GB) | Q6_K (1.16 GB) | 計測した範囲では差が見えません |
| Irodori-TTS MF | F16 (2.04 GB) | Q6_K (1.16 GB) | 量子化するとどのタイプでも少し聞き取りにくくなります |
ここからはこの表のもとになった数字を見ていきます。計測にはすべてspeech-benchを使い、Apple M5のMetalで動かしています。細かい条件はAppendix Eにまとめました。
日本語の音声認識
Common Voice 8.0の日本語テストセット (4,483発話) でCERを計測しました。スラッシュの後ろの数字は「行う」と「行なう」のような表記の違いを正解として数えたときのCERです。
| タイプ | ファイル | メモリ | parakeet-ja | ReazonSpeech |
|---|---|---|---|---|
| F16 | 1.24 GB | 1.37 GB | 7.88% / 2.98% | 12.02% / 7.13% |
| Q8_0 | 0.66 GB | 0.78 GB | 7.93% / 3.00% | 12.05% / 7.15% |
| Q6_K | 0.51 GB | 0.63 GB | 7.88% / 3.00% | 11.98% / 7.12% |
| Q5_K | 0.43 GB | 0.54 GB | 7.79% / 2.97% | 11.99% / 7.14% |
| Q4_K | 0.36 GB | 0.47 GB | 7.94% / 3.01% | 12.16% / 7.23% |
parakeet-jaとReazonSpeechはQ4_Kまで下げてもCERがほとんど動きませんでした。メモリは1.37 GBから0.47 GBまで減るので、このふたつはメモリが足りなければ迷わずQ4_Kにしてよさそうです。
| タイプ | 0.6Bのファイル | メモリ | Qwen3-ASR 0.6B | 1.7Bのファイル | メモリ | Qwen3-ASR 1.7B |
|---|---|---|---|---|---|---|
| Q8_0 | 0.84 GB | 1.00 GB | 11.89% / 7.05% | 2.18 GB | 2.34 GB | 9.49% / 4.67% |
| Q6_K | 0.68 GB | 0.84 GB | 12.01% / 7.02% | 1.68 GB | 1.85 GB | 9.52% / 4.72% |
| Q5_K | 0.59 GB | 0.75 GB | 12.49% / 7.57% | 1.41 GB | 1.58 GB | 9.85% / 4.96% |
| Q4_K | 0.51 GB | 0.67 GB | 14.23% / 8.66% | 1.16 GB | 1.32 GB | 11.21% / 5.96% |
Qwen3-ASRはQ6_KまではQ8_0とほぼ同じで、Q5_KとQ4_Kに下げるにつれてCERが上がっていきます。おもしろいのは1.7BのQ4_K (1.32 GB) が0.6BのQ8_0 (1.00 GB) よりCERが低いことです。メモリにあと0.3 GBの余裕があるなら、0.6Bのまま使うより1.7BをQ4_Kで使うほうが正確に認識できます。
英語などの音声認識
parakeet-v3 (parakeet-tdt-0.6b-v3) はFLEURSの英語300発話でWERを計測しました。ファイルとメモリはparakeet-jaとほぼ同じです。
| タイプ | WER |
|---|---|
| F16 | 8.76% |
| Q8_0 | 9.06% |
| Q6_K | 8.87% |
| Q5_K | 9.13% |
| Q4_K | 9.51% |
音声合成
合成は日本語の20文を3つのシードで合成し、その音声をQwen3-ASR 1.7Bで聞き取って元の文とのCERを計測しました。表の数字は60回の平均です。合成は同じタイプでもシードによってCERが数ポイント変わるので、1〜2ポイントの差ではどちらが良いとは言えません。
| タイプ | 0.6Bのファイル | メモリ | Qwen3-TTS 0.6B | 1.7Bのファイル | メモリ | Qwen3-TTS 1.7B |
|---|---|---|---|---|---|---|
| Q8_0 | 1.21 GB | 1.37 GB | 6.14% | 2.29 GB | 2.44 GB | 6.25% |
| Q6_K | 0.99 GB | 1.15 GB | 6.03% | 1.82 GB | 1.98 GB | 4.42% |
| Q5_K | 0.87 GB | 1.03 GB | 7.35% | 1.57 GB | 1.72 GB | 6.02% |
| Q4_K | 0.76 GB | 0.92 GB | 13.60% | 1.33 GB | 1.48 GB | 7.19% |
Qwen3-TTS 0.6BのQ4_KだけはCERがQ8_0の倍以上になりました。0.6Bを小さくしたいときはQ6_Kまでにしておくのがおすすめです。ただわたしが聞いてみたかぎり、Qwen3-TTSはすべての量子化版において抑揚が抑えられたものが生成されやすい傾向にあるように感じられました。このあたりはなかなかスコアにしづらいので、実際使ってみて、聞いてみて確かめてみると良いと思います。1.7BのQ4_Kは平均ではシードによる差の範囲に収まっていました。ただ、あとで1文ずつ聞いて比較したときに英単語の混ざる文がまったく違う言葉になった例があったので、表ではQ6_Kをおすすめにしています。
| タイプ | MFのファイル | メモリ | Irodori-TTS MF | ファイル | メモリ | Irodori-TTS |
|---|---|---|---|---|---|---|
| F16 | 1.92 GB | 2.04 GB | 5.92% | 1.91 GB | 2.03 GB | 3.43% |
| Q8_0 | 1.21 GB | 1.33 GB | 8.35% | 1.20 GB | 1.32 GB | 4.09% |
| Q6_K | 1.04 GB | 1.16 GB | 7.35% | 1.03 GB | 1.16 GB | 3.65% |
| Q5_K | 0.95 GB | 1.07 GB | 7.74% | 0.94 GB | 1.07 GB | 4.37% |
| Q4_K | 0.86 GB | 0.99 GB | 7.57% | 0.86 GB | 0.98 GB | 4.54% |
Irodori-TTS (irodori-tts) は16ステップで合成して計測しました (デフォルトは40ステップです)。Q4_Kまで下げてもF16との差はシードによる差の範囲に収まっていました。こちらはQwen3-TTSとことなり、量子化したものでも声の抑揚はふつうでした。一方でキャプションの効果など薄れている可能性はあります。なおIrodori-TTSは2つのモデルとも音声をデコードするコーデックをどのタイプでもF32のまま持っているので、ほかのモデルほどファイルが小さくなりません。
MFのほうは量子化したタイプがどれもF16より悪くなりました。F16をシードごとに計測したCERは5.31〜6.30%で、量子化したタイプの平均 (7.35〜8.35%) はこの範囲の外にあります。MFは4ステップで音声を作るので、1回の計算で生じた誤差が最後まで残りやすいのかもしれません。MFは最初の音声が届くまでの時間が16ステップで合成したIrodori-TTSの5分の1ほどと短いので、メモリと速さのどちらを取るかで選ぶことになります。
名前だけで指定したときに使うタイプ
名前だけで指定したときにどのタイプを使うかは次のように決めました。
- 認識のモデルでは、Q8_0とF16のCERの差が表記の違いを数えても数えなくても0.2ポイント以内ならQ8_0を使います
- 合成のモデルでは、Q8_0のCERの平均がF16をシードごとに計測したCERの範囲に入るならQ8_0を使います
- Q6_K、Q5_K、Q4_Kは数字が良くても使いません
3つ目は、今回のデータでは良くても別の録音や別のGPUで精度が下がることがありうるからです。名前だけで指定したときのタイプでそうなると、タイプを選んでいない人全員に影響します。小さいタイプは上の数字を見たうえで選んでもらうことにしました。
この決め方でparakeet-jaとReazonSpeechはQ8_0に変わりました。parakeet-v3はQ8_0でWERが0.3ポイント上がったのでF16のままです。Irodori-TTSは2つのモデルともF16のままにしています。
VulkanでQwen3-TTSのQ5_KとQ4_Kを使うとき
Qwen3-TTSのQ5_KとQ4_KをVulkanで使うには0.8.4が必要です。0.8.3以前のVulkan版でこの2つのファイルを使うと、合成の途中で次のエラーになります。
speech: internal: no token has a finite logit to pick from
原因はggmlのVulkanバックエンドにありました。計算の途中の値がF16で表せる最大の値 (65504) を超えて無限大になっていたのです。0.8.4ではspeech.cppが使うggmlに修正を入れています。原因と直し方はAppendix Aに書きました。Q8_0とQ6_Kは0.8.3以前でも正しく合成できます。
この修正を入れるために、speech.cppはggmlの公式のリポジトリではなくわたしのフォーク (nyosegawa/ggml) を使うようになりました。フォークの扱い方はAppendix Cにあります。
メモリと速さ
0.8.4ではモデルを読み込むときのメモリのピークも下がりました。0.8.3はファイルからテンソルを読むときに、いちばん大きなテンソルと同じ大きさの一時バッファを使っていました。0.8.4は16 MBずつ読むので、そのバッファの分だけピークが下がります。
| モデル (M5、Metal) | 0.8.3 | 0.8.4 |
|---|---|---|
| Qwen3-TTS 1.7B Q8_0 | 2758 MB | 2443 MB |
| Qwen3-ASR 0.6B Q8_0 | 1154 MB | 1005 MB |
| Irodori-TTS F16 | 2171 MB | 2030 MB |
Vulkanでは読み込みが終わったあとのメモリも減りました。RTX 2080でQwen3-ASR 1.7Bのワーカーが待機している間のメモリは2635 MBから2325 MBになっています。理由はAppendix Dに書きました。
同じタイプなら速さは0.8.3から変わっていません。読み込みにかかる時間も同じです。Macでは0.8.3と同じ計算をしていて、10個のモデルの出力が0.8.3とバイト単位で一致しました。
タイプごとの速さ
タイプを変えると速さも変わります。合成は最初の音声が届くまでの時間と音声1秒を作るのにかかる時間 (RTF) を計測しました。認識は話し終えた1発話を渡してからテキストが返るまでの時間です。名前だけで指定したときのタイプを100%として並べています。まずApple M5の結果です。
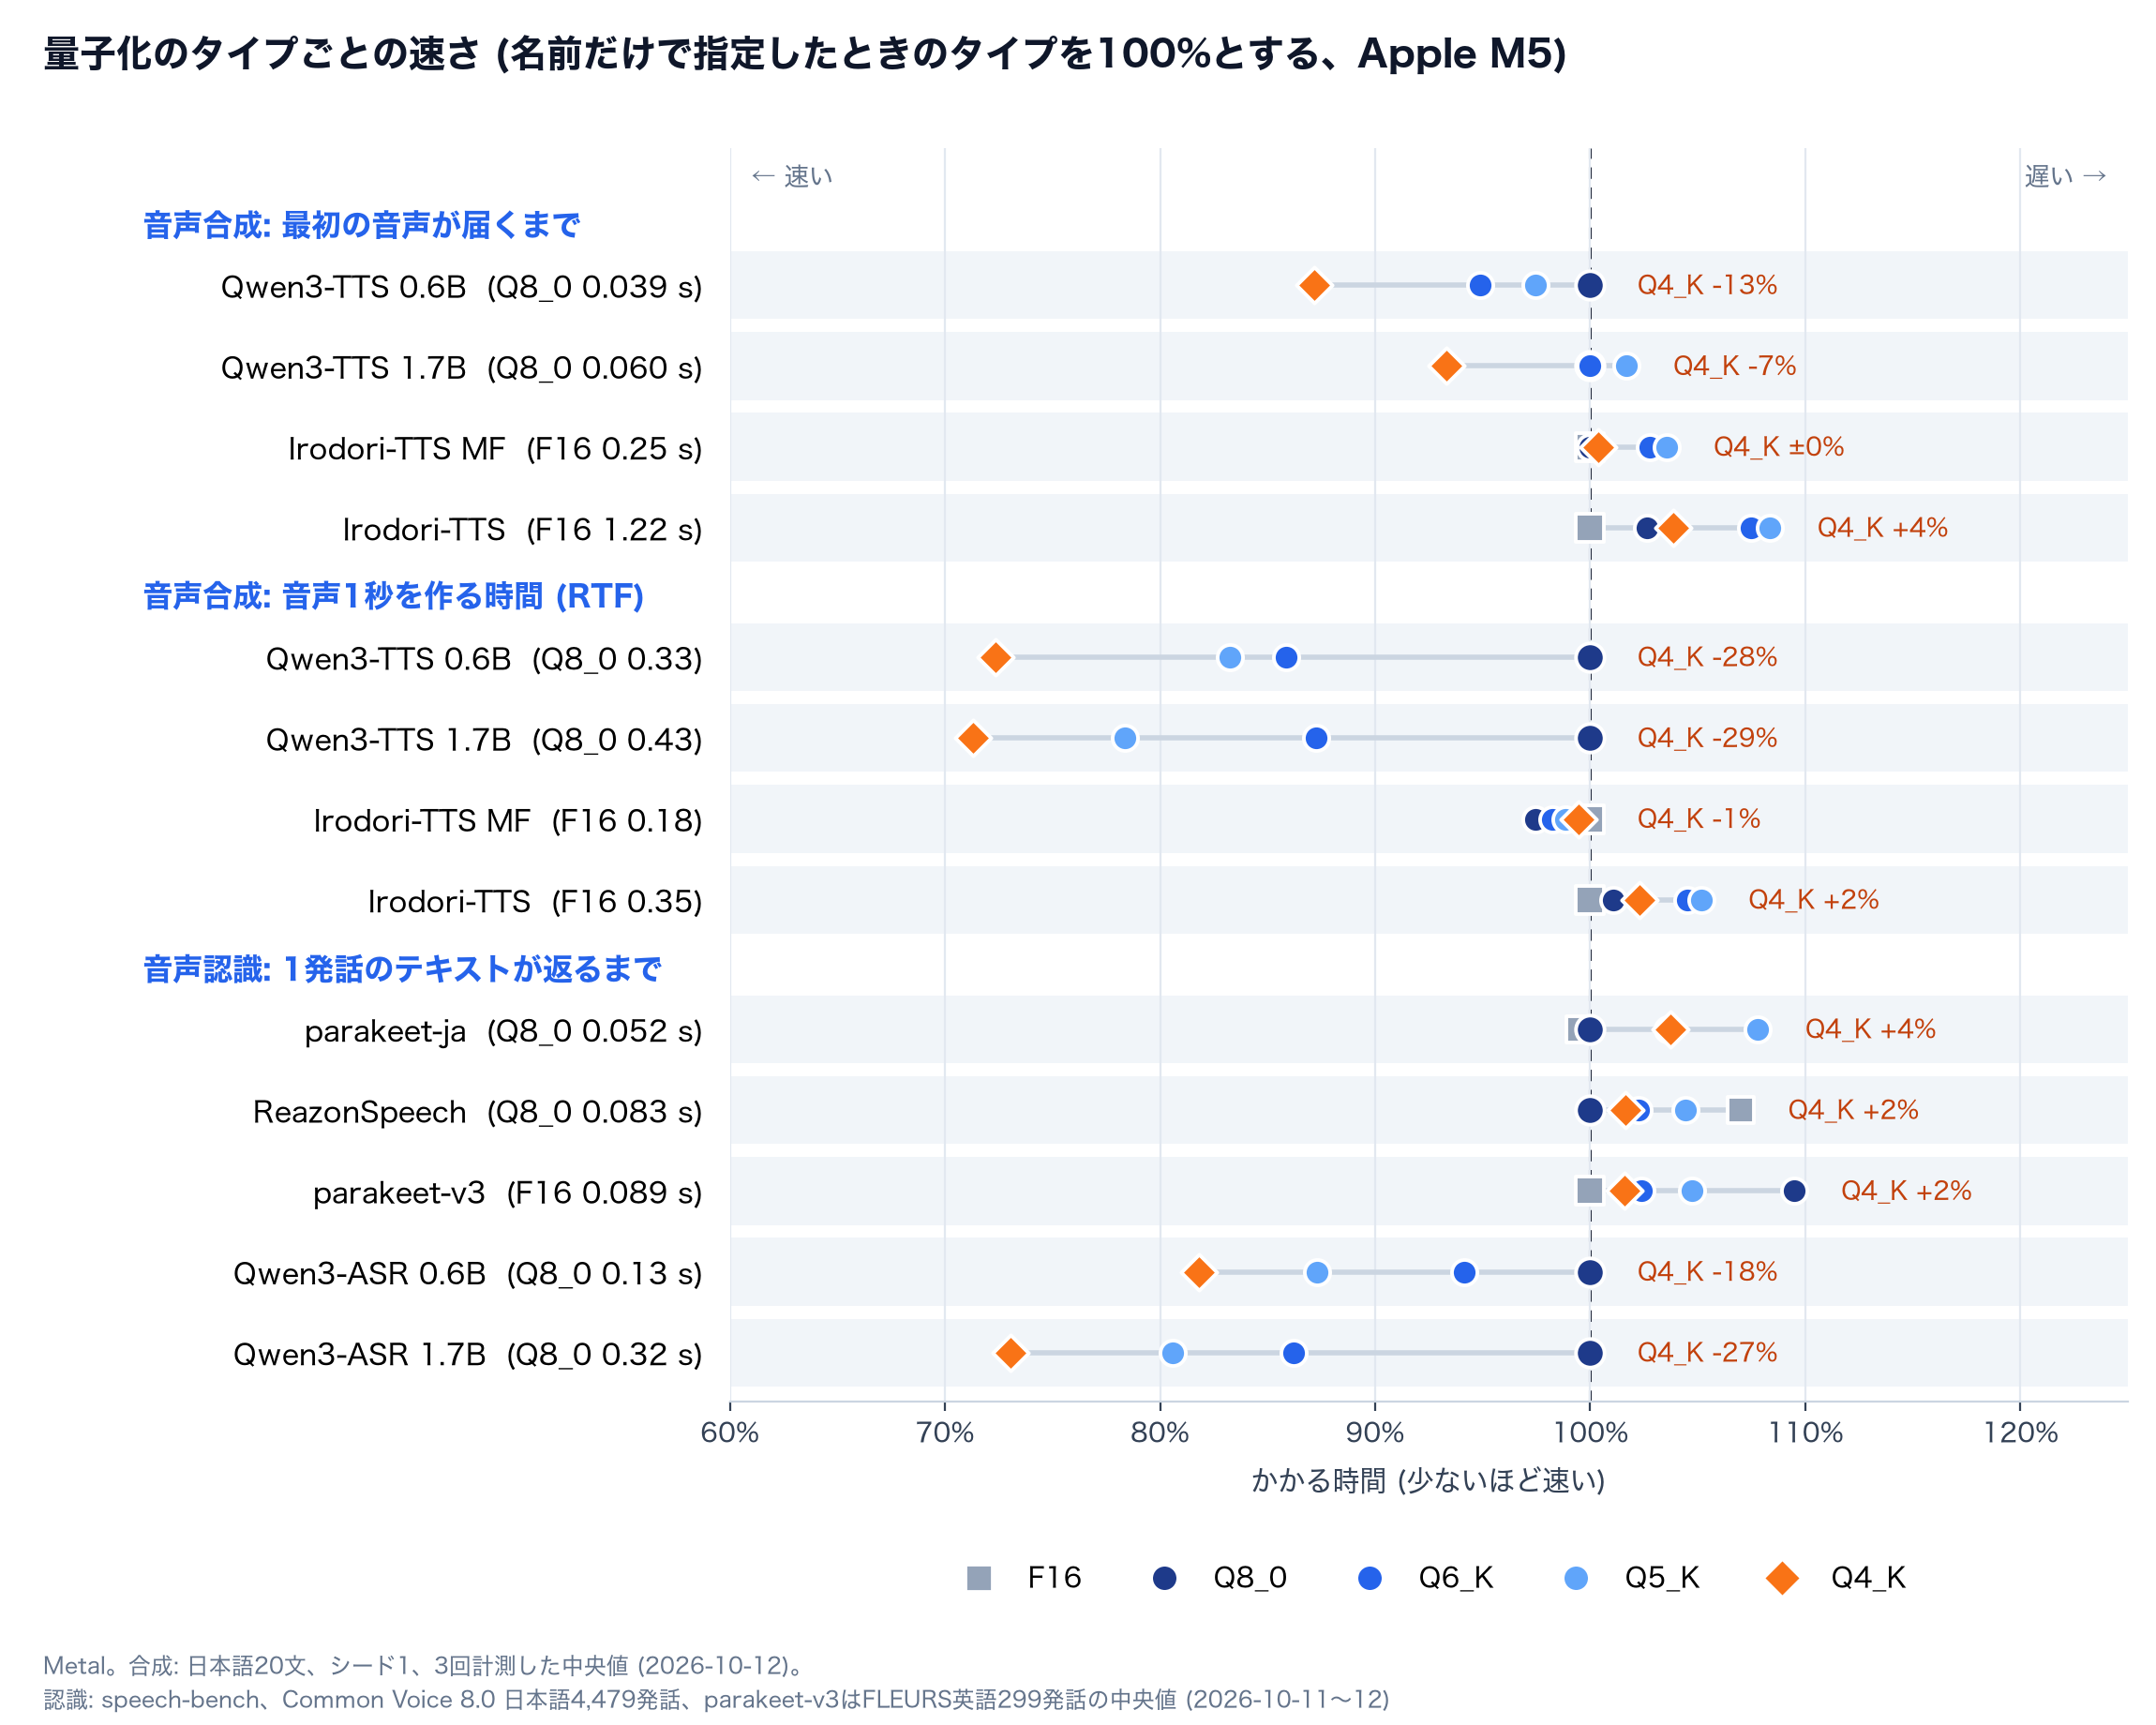
- Qwen3-TTSとQwen3-ASRはタイプを小さくするほど速くなります
- Q4_KにするとQwen3-ASR 1.7Bの認識の時間は27%短くなり、Qwen3-TTSが音声を作る時間は3割ほど短くなりました
- Qwen3-TTSの最初の音声までの時間はもともと0.04〜0.06秒と短く、Q4_Kにしても数ミリ秒しか変わりません
- FastConformerの3モデル (parakeet-ja、ReazonSpeech、parakeet-v3) とIrodori-TTSはどのタイプでも速さがほとんど変わりません
Qwen3-TTSとQwen3-ASRはトークンを1つ作るたびにウェイト全体をメモリから読み込みます。ウェイトが小さいほど読み込む量が減るので、そのぶん速くなります。FastConformerとIrodori-TTSは1回の計算でたくさんのフレームをまとめて処理します。ウェイトを読み込む時間より計算の時間のほうが長いので、ウェイトを小さくしても速くならないのだと考えられます。
WindowsのRTX 2080 (Vulkan) でも同じように計測しました。
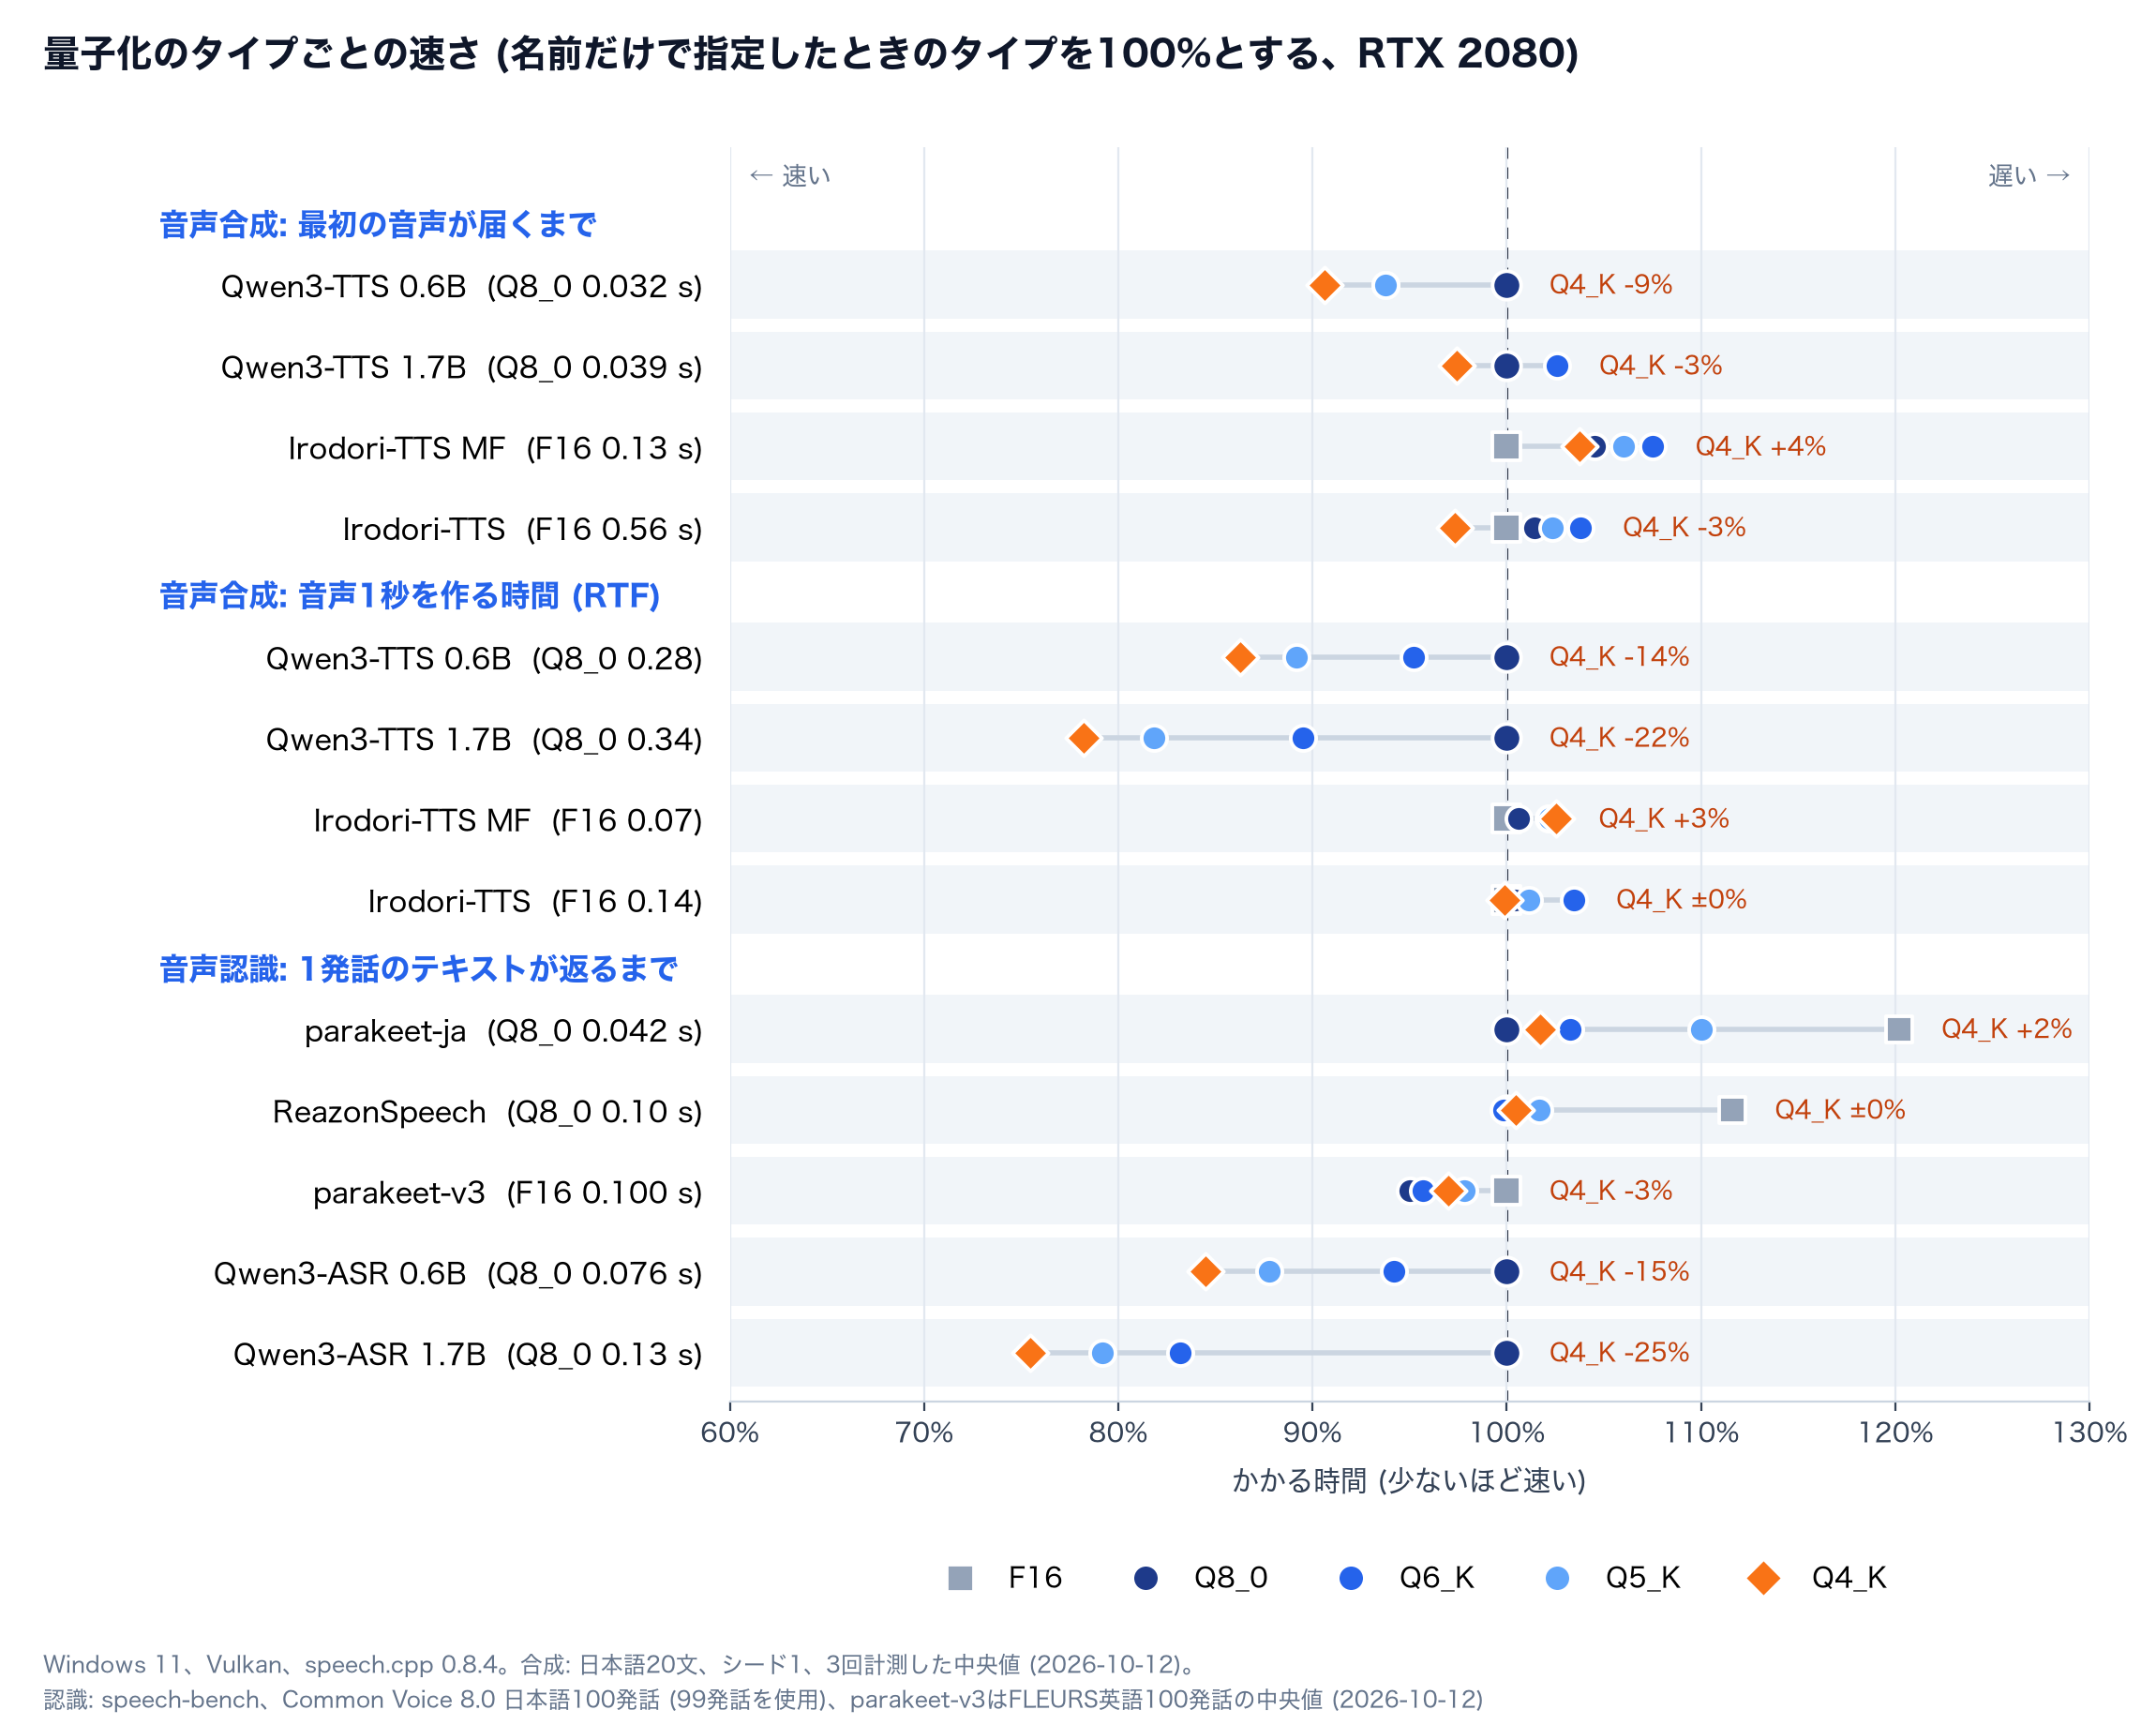
傾向はM5と同じです。Q4_KにするとQwen3-ASR 1.7Bの認識の時間は25%短くなり、Qwen3-TTS 1.7Bが音声を作る時間は22%短くなりました。FastConformerとIrodori-TTSはほとんど変わりません。Vulkanでは今回の修正でQ4_KとQ5_Kの計算のしかたが変わりましたが、それでもQ8_0より速いままです。またRTX 2080ではparakeet-jaとReazonSpeechのF16がQ8_0より1〜2割遅く、名前だけで指定したときにQ8_0を使うようにしたことは速さの面でも得になっています。
読み込みの時間
タイプを小さくするとモデルを読み込む時間も短くなります。OSのファイルキャッシュを空にした場合 (PCを起動して初めて使うときなど) と、キャッシュに載っている場合 (2回目以降に使うとき) に分けてApple M5で計測しました。
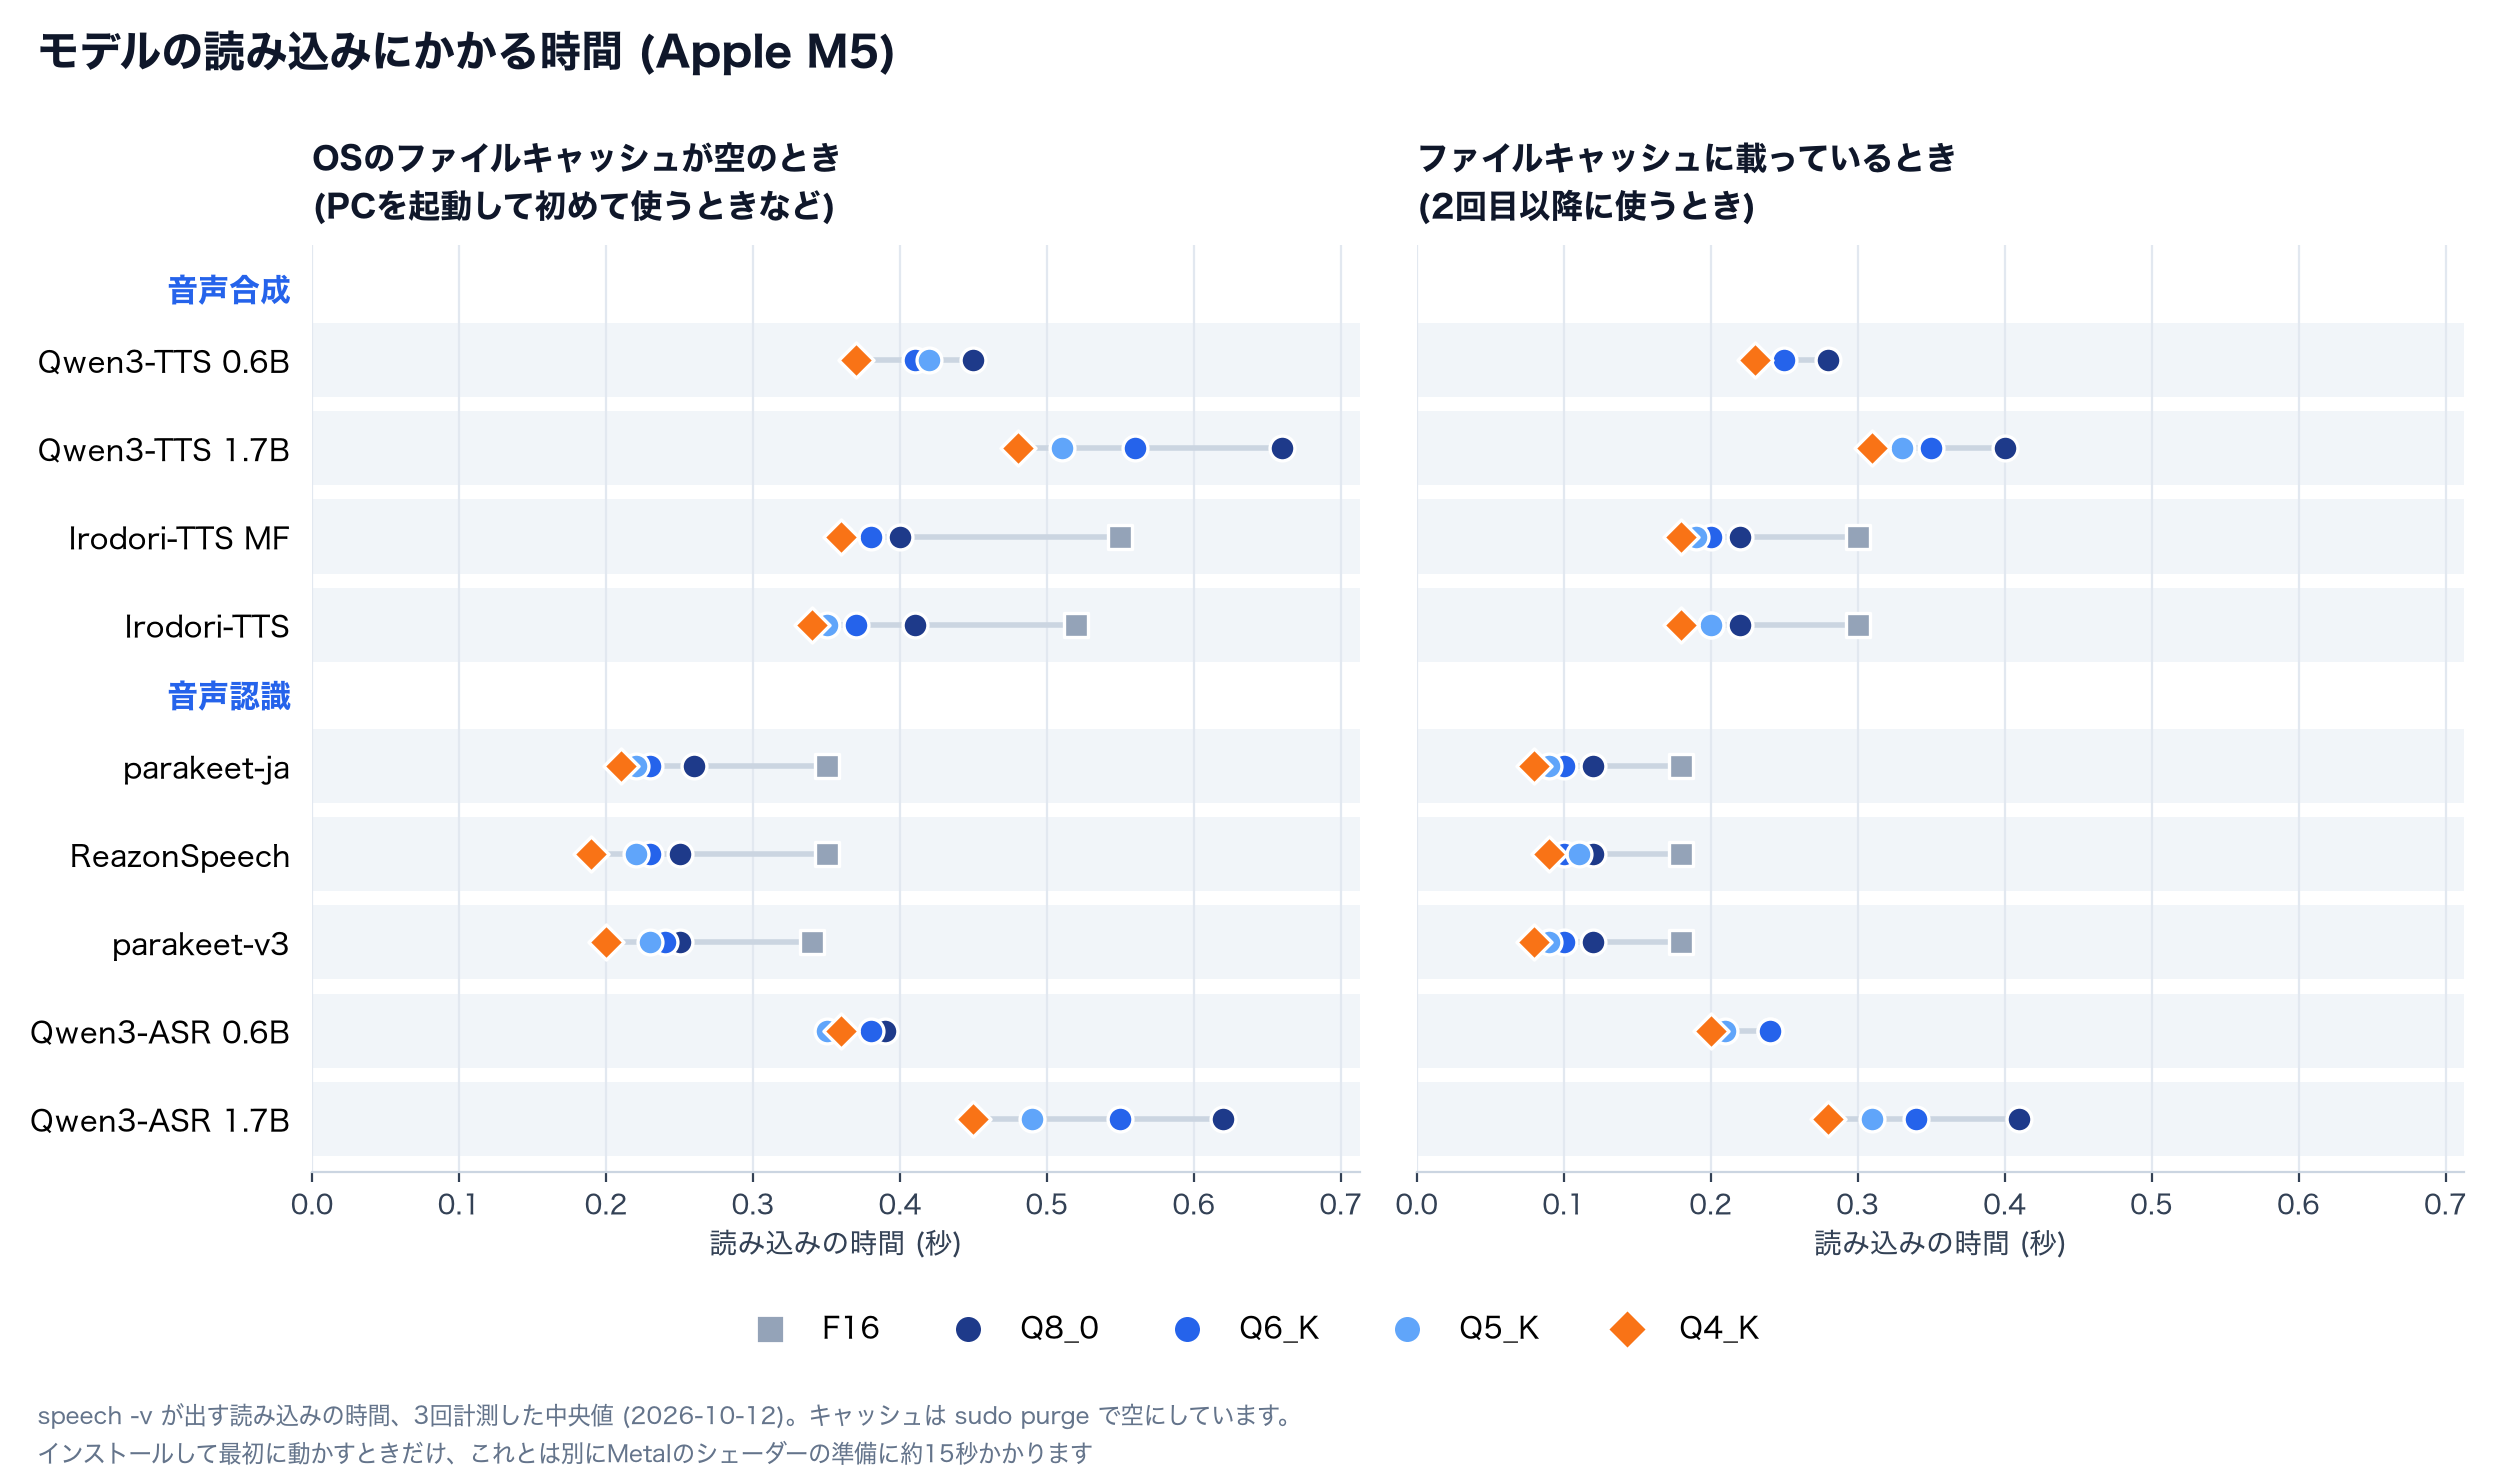
- 読み込みの時間はファイルの大きさにほぼ比例して短くなります
- FastConformerの3モデルはF16の0.35秒がQ4_Kでは0.2秒ほどになりました
- Qwen3-TTS 1.7BとQwen3-ASR 1.7Bはキャッシュが空のときでQ8_0の0.6秒台がQ4_Kでは0.5秒弱になりました
- キャッシュに載っているときはどのモデルもキャッシュが空のときの半分ほどで読み込めます
M5のSSDは速いので、どのモデルもキャッシュが空の状態から0.7秒以内に読み込めます。ただしインストールして最初に動かすときだけは、これとは別にMetalのシェーダーの準備に15秒ほどかかります。
まとめ
- 0.8.4ではSilero VAD以外のすべてのモデルでQ8_0からQ4_Kまでのタイプを選択できるようになりました
- parakeet-ja、ReazonSpeech、Qwen3-ASR、Irodori-TTSはQ6_Kまで下げても精度がほとんど変わりませんでした。parakeet-jaとReazonSpeechはQ4_Kでも変わりません
- VulkanでQwen3-TTSのQ5_KかQ4_Kを使うときは0.8.4に更新してください
Appendix A: VulkanでQ5_KとQ4_KがNaNになった原因
見つけたきっかけ
公開したファイルをWindowsのRTX 2080で1つずつ動かしていたときに見つけました。Qwen3-TTS 0.6Bだけ、タイプによって合成できたりできなかったりしました。同じファイルでもWindowsのCPUとMacのMetalでは合成できます。
| Qwen3-TTS 0.6B | Vulkan (RTX 2080) |
|---|---|
| Q8_0 | 合成できる |
| Q6_K | 合成できる |
| Q5_K | エラーになる |
| Q4_K | エラーになる |
ggmlのVulkanバックエンドには一部の計算方法を使わないようにする環境変数があります。1つずつ試すと、GGML_VK_DISABLE_MMVQ か GGML_VK_DISABLE_INTEGER_DOT_PRODUCT を設定したときだけ合成できました。どちらも行列積を整数の内積で計算する方法を止める変数です。
q8_1のブロックの合計がF16を超える
ggmlのVulkanバックエンドは行列積を整数の内積で計算するときに、ウェイトに掛けるActivationをq8_1という形式に量子化します。q8_1は32個の値をひとまとまりにして、int8の値32個とF16のスケール d とF16の合計 s を持ちます。s は32個のActivationを足した値にほぼ等しくなります。
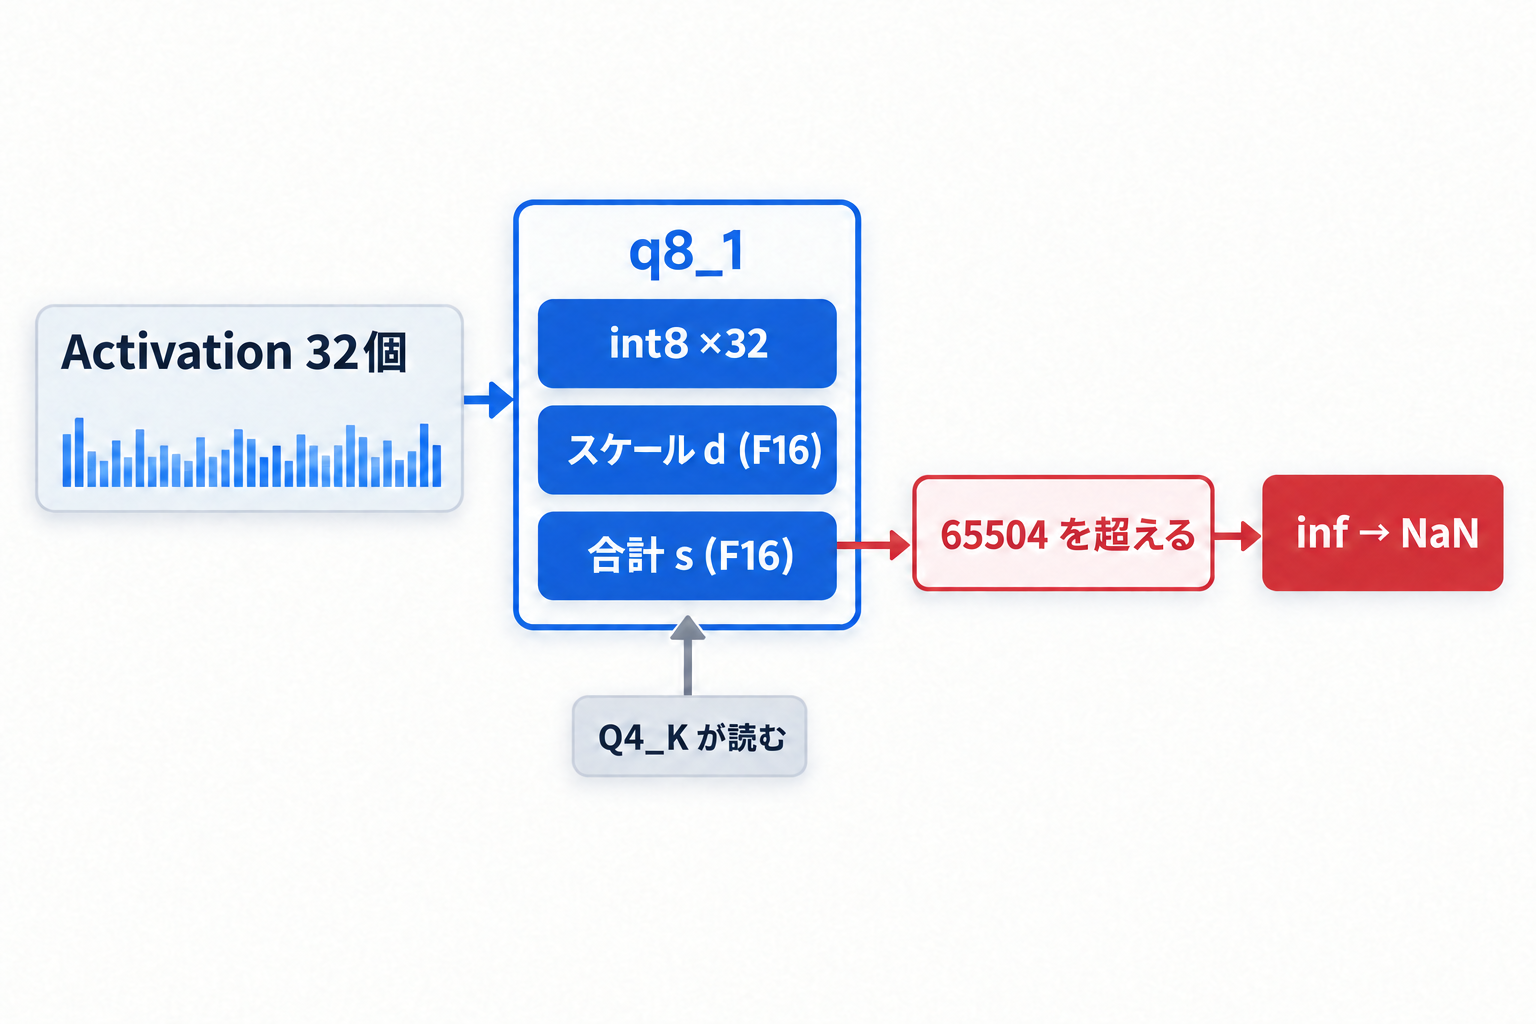
F16で表せる最大の値は65504なので、2048を超えるActivationが32個続くと s は無限大になります。LLMではごく一部のチャンネルにとても大きなActivationが出ることが知られていて (Sun et al., 2024)、Qwen3-TTSでもどこかでこの大きさに達していました。
s を使うかどうかはウェイトのタイプで決まります。Q4_Kは32個のウェイトごとにスケール d と最小値 m を持ち、ウェイトを w = d·q − m で表します (qは0〜15の整数)。Activationを a ≈ d_a·r (rはint8) と表すと、32個分の内積は次のようになります。
1つ目の項は整数の内積で計算できて、2つ目の項で s を使います。ggmlのシェーダーでもQ4_KとQ5_Kはこの式のとおりに計算しています。
return ACC_TYPE(float(cache_b.ds.x) * float(cache_a[ib_a].dm.x) * float(q_sum) - float(cache_a[ib_a].dm.y) * float(cache_b.ds.y));
ggml-org/ggml v0.25.3: src/ggml-vulkan/vulkan-shaders/mul_mmq_funcs.glsl
cache_b.ds.y が s です。これが無限大だと結果も無限大かNaNになります。Q8_0とQ6_Kには最小値がないので2つ目の項がなく、s を使いません。Q8_0とQ6_Kだけが合成できたのはこのためです。シェーダーを読むと s を使うタイプはQ2_0、Q4_0、Q4_1、Q5_0、Q5_1、Q4_K、Q5_K、IQ1_Sの8つでした。
CPUでQ4_Kを計算するときはActivationをQ8_Kという別の形式にしています。Q8_Kは合計をint16で、スケールをF32で持つので、この問題は起きません。
直し方
s を使う8つのタイプではq8_1を使う計算をしないようにしました。ggmlはNVIDIAのGPUでQ6_Kを同じように外していて、その条件にこの8つを足しています。Q8_0とQ6_Kの計算は変わりません。
この修正をCodexにレビューしてもらったところ、もう1つ問題が見つかりました。q8_1を使わない場合、ggmlはウェイトをF16に戻してから行列積を計算します。このとき行列積の精度が指定されていないとF16のまま足し合わせ、65504を超えた結果を65504に切り詰めます。speech.cppのQwen3のデコーダは精度を指定していません。そのためブロックの合計は65504以内でも積の結果が65504を超えると、修正前には正しかった値が修正後に切り詰められてしまいます。そこでこの8つのタイプはF32で足し合わせるようにしました。q8_1を使う計算はもともと整数とF32で足していたので、修正前と同じ大きさの値まで扱えます。
テストケース
ggmlのテスト (test-backend-ops) にはこの問題で失敗するケースがなかったので、2種類を足しました。
- Activationを2048〜4096にして、32個の合計がF16を超えるケース
- Activationを512〜1024、ウェイトを0.5〜1にして、合計は超えないけれど積の結果がF16を超えるケース
これをQ4_0、Q5_0、Q4_K、Q5_Kのそれぞれで、行列とベクトルの積と小さなバッチと大きなバッチの3通りで計算します。Q4_1とQ5_1は比較する相手のCPUもActivationをq8_1にしていて同じように -inf を返すので、ケースに入れていません。
test-backend-ops -b Vulkan0 (RTX 2080) |
修正前 | 修正後 |
|---|---|---|
| 追加したケース | 8 / 24 | 24 / 24 |
| MUL_MAT のすべてのケース | 1138 / 1154 | 1154 / 1154 |
| MUL_MAT_ID のすべてのケース | 937 / 937 | 937 / 937 |
修正したビルドではQwen3-TTSのQ5_KとQ4_Kも合成でき、Q8_0の出力は0.8.3とバイト単位で同じでした。
Appendix B: MetalのTensor APIを使っていない理由
ggmlのMetalバックエンドはM5以降のチップでは行列積をMetal 4のTensor APIで計算します。ところがIrodori-TTSを移植したときに、M5ではこの計算が出力の範囲の外まで書き込むことがわかりました (speech.cpp #13)。出力の列数を128で割って64余るときに起きて、コーデックの64フレームのウィンドウがノイズになります。
そのため0.8.3までは、speech.cppがデバイスを準備する間だけ環境変数 GGML_METAL_TENSOR_DISABLE を設定していました。ただこれは libspeech を組み込んだプログラムの環境変数を書き換えることになりますし、ほかのスレッドが同時に環境変数を読むと安全ではありません。ggmlのフォークを作ることになったので、書き込む位置を直したうえでTensor APIを使えないかを試しました。
書き込む位置を直してspeech.cppのMetalのチェックを実行すると、25個のうち3個が失敗しました。
| チェック (M5、F32) | Tensor APIなし | Tensor APIあり |
|---|---|---|
| Irodori-TTS v4.1-Small、公式の実装との合成音声のSNR | 8.7〜62.5 dB | 2.3〜48.3 dB |
| ReazonSpeech、311秒の音声をビームサーチで認識 | NeMoと同じテキスト | 数文字違う |
同じビルドで2回実行すると同じ値が出るので、サンプリングのばらつきではありません。DiTを1回計算するだけのチェック (109項目) でもSNRの中央値が59.1 dBから52.9 dBに下がっていて、この差が40ステップのサンプリングで積み重なっていました。原因はggmlがTensor APIの行列積に渡している引数でした。
mpp::tensor_ops::matmul2d<
mpp::tensor_ops::matmul2d_descriptor(
NRB, NRA, static_cast<int>(dynamic_extent), false, true, true,
mpp::tensor_ops::matmul2d_descriptor::mode::multiply_accumulate),
execution_simdgroups<N_MM_SIMD_GROUP_X * N_MM_SIMD_GROUP_Y>> mm;
ggml-org/ggml v0.25.3: src/ggml-metal/kernels/mul_mm.metal
6番目の引数は relaxed_precision で、true は精度を下げて速く計算してよいという意味です。これを false にすると25個のチェックはすべて通り、Irodori-TTSのSNRは14.0〜64.8 dBとTensor APIを使わないときより良くなりました。しかしその一方で遅くなってしまいました。
| M5、中央値 | Tensor APIなし | Tensor API (relaxed_precision が false) |
|---|---|---|
| Irodori-TTS MF、最初の音声まで | 0.251 s | 0.351 s |
| Irodori-TTS 16ステップ、最初の音声まで | 1.239 s | 1.762 s |
| Qwen3-TTS 0.6B、最初の音声まで | 0.039 s | 0.072 s |
| Qwen3-ASR 0.6B、認識 | 0.123 s | 0.150 s |
| ReazonSpeech、認識 | 0.078 s | 0.107 s |
どのモデルも22〜85%遅くなります。精度か速さのどちらかを下げることになるので、Tensor APIはデフォルトで使わないことにしました。ggmlもM5より前のチップではTensor APIをデフォルトで使っていないので、フォークではこれをすべてのチップに広げています。これでspeech.cppは環境変数を設定しなくてよくなり、Macの計算は0.8.3と同じになりました。
Appendix C: ggmlのフォーク
Appendix AとBの修正はどちらもggmlのソースを変える必要があります。そこでspeech.cppのサブモジュールをnyosegawa/ggmlの speech.cpp ブランチに変えました (#111)。
フォークは公式のリポジトリとの差が大きくなると更新できなくなります。そうならないように次の決まりで扱っています。
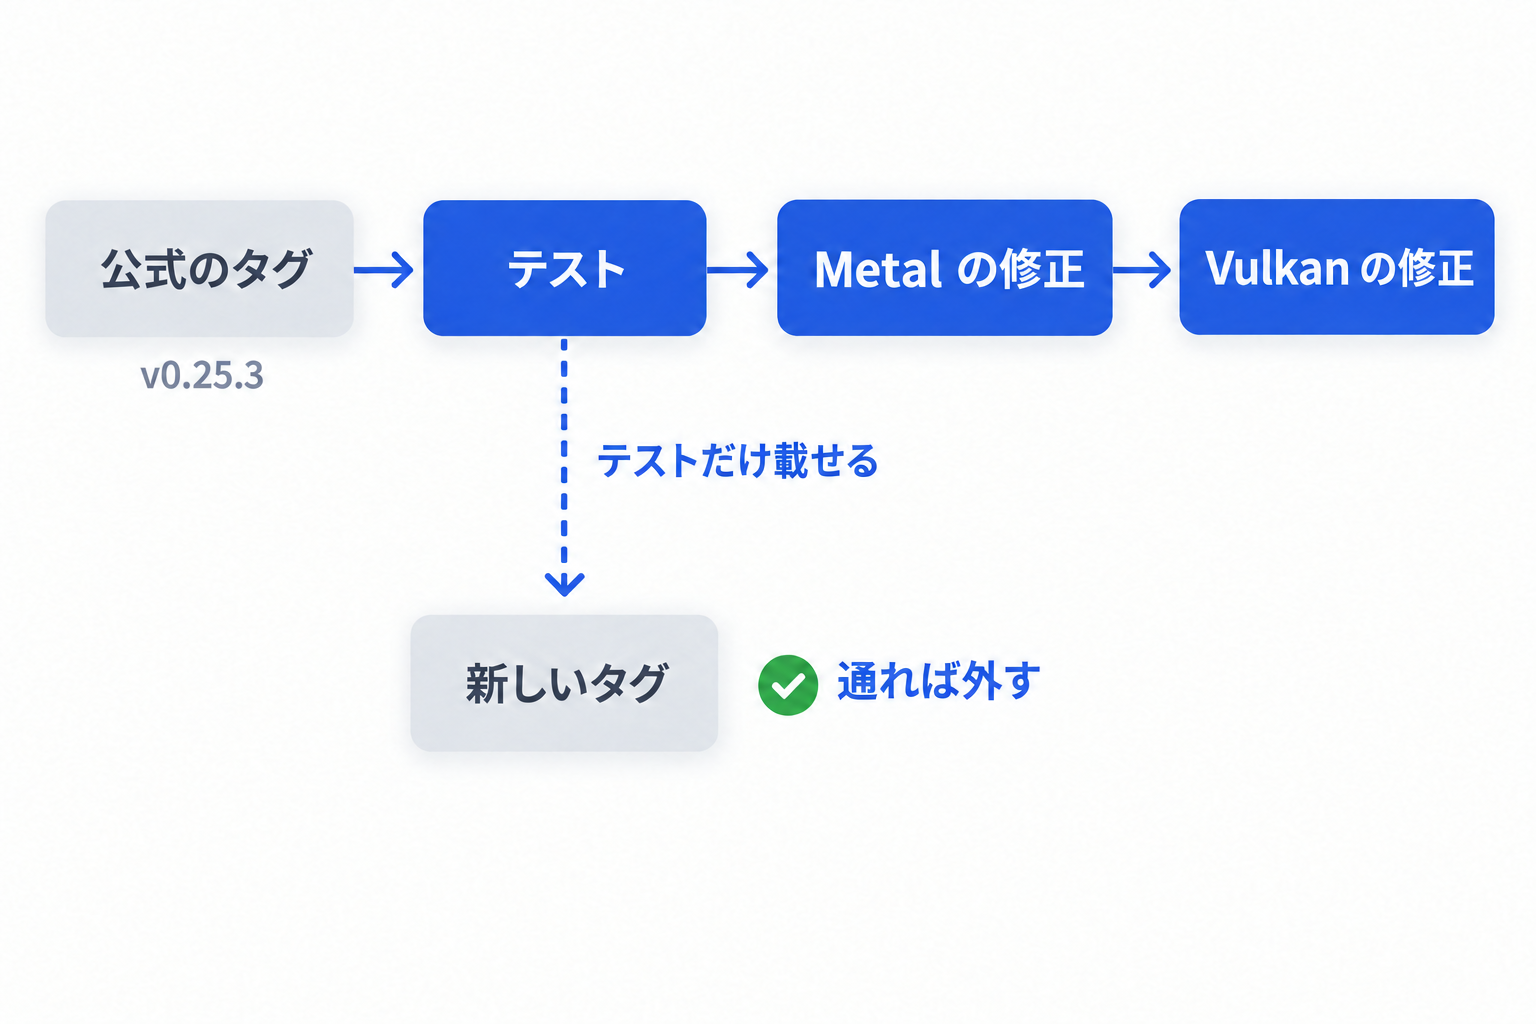
- ブランチはggmlの公式のタグの上に、テストケースのコミットを1つと不具合ごとの修正のコミットを積んだものにします
- 修正にはその不具合で失敗するテストケースを必ず付けます
- ggmlの新しいタグに上げるときは、まずテストケースのコミットだけを新しいタグに載せて実行します
- 修正なしで通ったテストケースがあれば公式のggmlで直ったということなので、その修正を外します
WindowsのマシンにはC++のコンパイラがないので、CIを checks=true で実行したときにggmlの test-backend-ops.exe も作るようにしました。Windowsではそれをダウンロードして実行すれば、修正がまだ要るかどうかがわかります。
Appendix D: 読み込みのメモリが減った理由
0.8.3はGGUFのテンソルを1つずつ std::vector に読んでからデバイスに送っていました。このバッファはいちばん大きなテンソルの大きさまで大きくなります。Qwen3系ではテキストの埋め込みがいちばん大きく、Qwen3-TTSとQwen3-ASR 1.7Bでは331 MBあります。0.8.4では16 MBずつ読んで送るようにしました (#105)。
Vulkanではもう1つ減る理由があります。ggmlのVulkanバックエンドはGPUに書き込むデータをホスト側の一時バッファに置いてから送ります。このバッファはいちばん大きな書き込みの大きさのまま、プロセスが終わるまで残ります。331 MBのテンソルを一度に書くと331 MBのバッファが残り続けますが、16 MBずつ書けば16 MBで済みます。
Appendix E: 計測の条件
- Mac: Apple M5、macOS 26.2、Metal
- Windows: Windows 11、NVIDIA GeForce RTX 2080、Vulkan SDK 1.4.357.0
- タイプごとの精度とメモリ: speech-bench、2026-10-12、M5
- 合成のCER: speech-benchの
prompts/speak-ja-JP.jsonの20文、シードは1、2、3- Qwen3-TTSの話者は
ono_annaで、Irodori-TTSは1つの参照音声から作った声のファイルを使いました - 聞き取りにはQwen3-ASR 1.7BのQ8_0を使いました
- Qwen3-TTSの話者は
- 速さ: 合成は同じ20文をシード1で3回ずつ合成した中央値です。認識はM5ではCommon Voiceの4,479発話、RTX 2080ではその最初の100発話 (99発話を使用) です。parakeet-v3はFLEURSの英語で、M5では299発話、RTX 2080では100発話です
- メモリ:
speechで1回合成または認識したときのpeak memory footprint (macOS) - Q6_K、Q5_K、Q4_Kは256個の値をひとまとまりにして量子化するので、行の長さが256で割り切れない行列はQ8_0のまま残ります。Qwen3-ASR 0.6Bのエンコーダ (行の長さ896) と、FastConformerのprediction networkとjoint (640) がこれに当たります
References
- speech.cpp
- モデル (Hugging Face)
- ggml
- ggml-org/ggml
- Massive Activations in Large Language Models
- ggml-org/llama.cpp #12135: Vulkan: Add DP4A MMQ and Q8_1 quantization shader
- ggml-org/llama.cpp #30105: vulkan: honor FP32 source precision in MUL_MAT_ID
- deepbeepmeep/kernels #4: MMQ returns NaN when a 32-activation block sum exceeds 65504 (CUDA)
- 測定
- 関連する記事